
大模型应用开发 / 系统课时
控制上下文长度
控制上下文长度
RAG 最常见的长度问题不是模型完全装不下,而是检索片段挤占了问题、提示词或答案空间。本节建立一个可执行的令牌预算:先预留固定开销和答案空间,再按相关性逐片加入证据,超过预算时立即停止。
学习目标
- 能拆分系统提示词、问题、知识片段和答案的令牌预算
- 能根据剩余预算动态选择或裁剪检索片段
- 能区分开发期粗略估算与生产环境精确分词
先算可用于上下文的预算
设模型最大上下文窗口为 ,系统提示词占用 ,用户问题占用 ,为答案预留 ,那么可用于检索上下文的预算近似为:
这里的关键是先预留答案空间,而不是把检索结果塞满后再看还能生成多少。如果 已经很小,应优先缩短固定提示词或减少检索范围,而不是盲目截断问题。
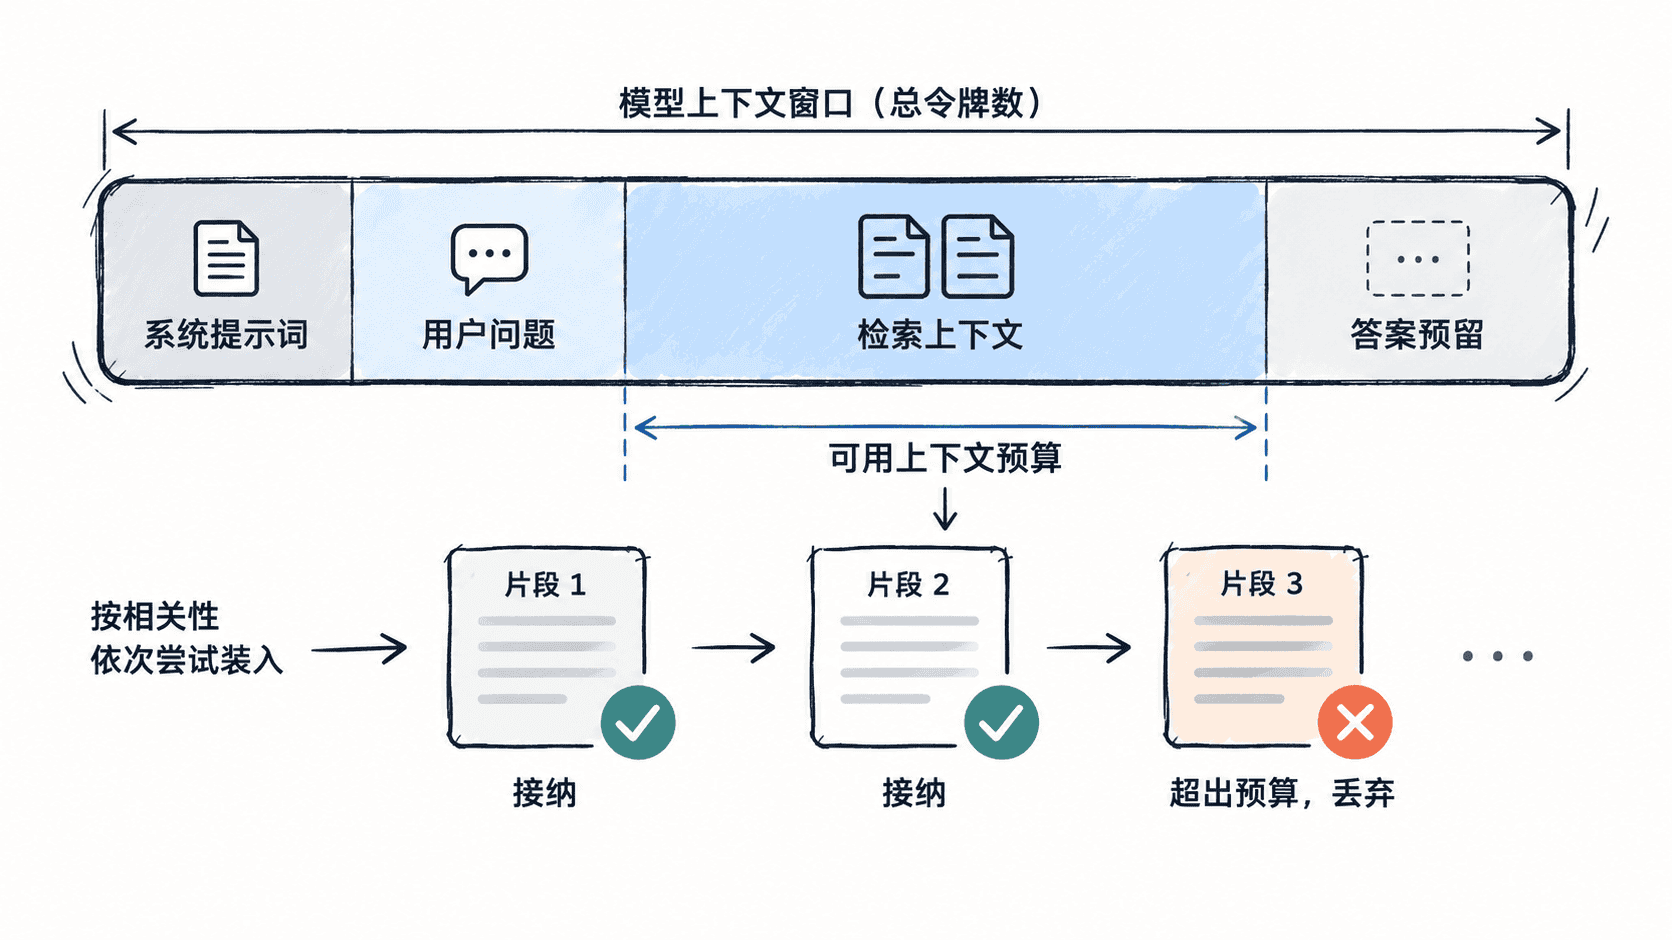
用预算逐片选择证据
下面的可运行示例使用“每 4 个字符约 1 个令牌”的粗略估算,只用于演示预算算法。生产环境应替换为目标模型对应的 tokenizer,否则中文、代码和特殊符号的误差会明显增大。
def estimate_tokens(text):
    return max(1, (len(text) + 3) // 4)

def select_context(snippets, max_tokens, system_prompt, question, answer_reserve):
    fixed = estimate_tokens(system_prompt) + estimate_tokens(question) + answer_reserve
    context_budget = max(0, max_tokens - fixed)
    selected = []
    used = 0

    for item in sorted(snippets, key=lambda x: x["score"], reverse=True):
        cost = estimate_tokens(item["text"])
        if used + cost > context_budget:
            continue
        selected.append(item["id"])
        used += cost

    return context_budget, selected, used

snippets = [
    {"id": "s1", "score": 0.95, "text": "A" * 60},
    {"id": "s2", "score": 0.90, "text": "B" * 80},
    {"id": "s3", "score": 0.85, "text": "C" * 40},
]

budget, selected, used = select_context(
    snippets,
    max_tokens=100,
    system_prompt="S" * 80,
    question="Q" * 40,
    answer_reserve=30,
)

print(f"available_context_tokens={budget}")
print(f"selected={selected}")
print(f"used_context_tokens={used}")
预期输出
available_context_tokens=40
selected=['s1', 's2']
used_context_tokens=35
系统提示词约占 20 个令牌,问题约占 10 个,再预留 30 个答案令牌,因此只剩 40 个令牌给知识片段。s1 与 s2 共占约 35 个令牌,s3 再加入会超过预算,所以被跳过。
裁剪时优先丢什么
预算不足时,优先丢弃低相关性、重复、只提供背景但不直接回答问题的片段。对于必须保留的长片段,可以先按句子或原始 chunk 边界缩短,再重新计算令牌数;不要直接从字符串中间硬截断,因为这可能切断代码、表格或一句关键限定条件。
如果知识片段之间有父子结构,例如标题加正文,裁剪时应保证标题与正文一起保留。若答案必须带引用,还要把来源标识计入预算,因为它同样会占用模型上下文。
验证裁剪策略
测试时不要只看“是否超长”,还要比较裁剪前后的答案命中率。准备一组固定问题,记录选中的片段、实际输入令牌数和最终答案是否仍包含关键事实;如果长度下降但答案质量明显变差,应调整重排序、chunk 大小或答案预留,而不是继续压缩。
可维护的策略应把最大窗口、答案预留和安全余量做成参数,并用真实 tokenizer 统计请求。这样模型、提示词或知识库变化时,只需重新计算预算,不必修改整条 RAG 流程。