
大模型应用开发 / 系统课时
压缩检索上下文
压缩检索上下文
检索结果并不等于最终提示词上下文。本节用一个可运行的句子级压缩器,从候选片段中只保留与问题直接相关的句子,并说明如何在召回率、上下文长度和证据完整性之间取得平衡。
学习目标
- 区分“检索候选”和“送入模型的压缩上下文”
- 实现一个可运行的句子级相关性压缩流程
- 识别压缩过度、证据断裂和信息失真的边界
为什么检索后还要压缩
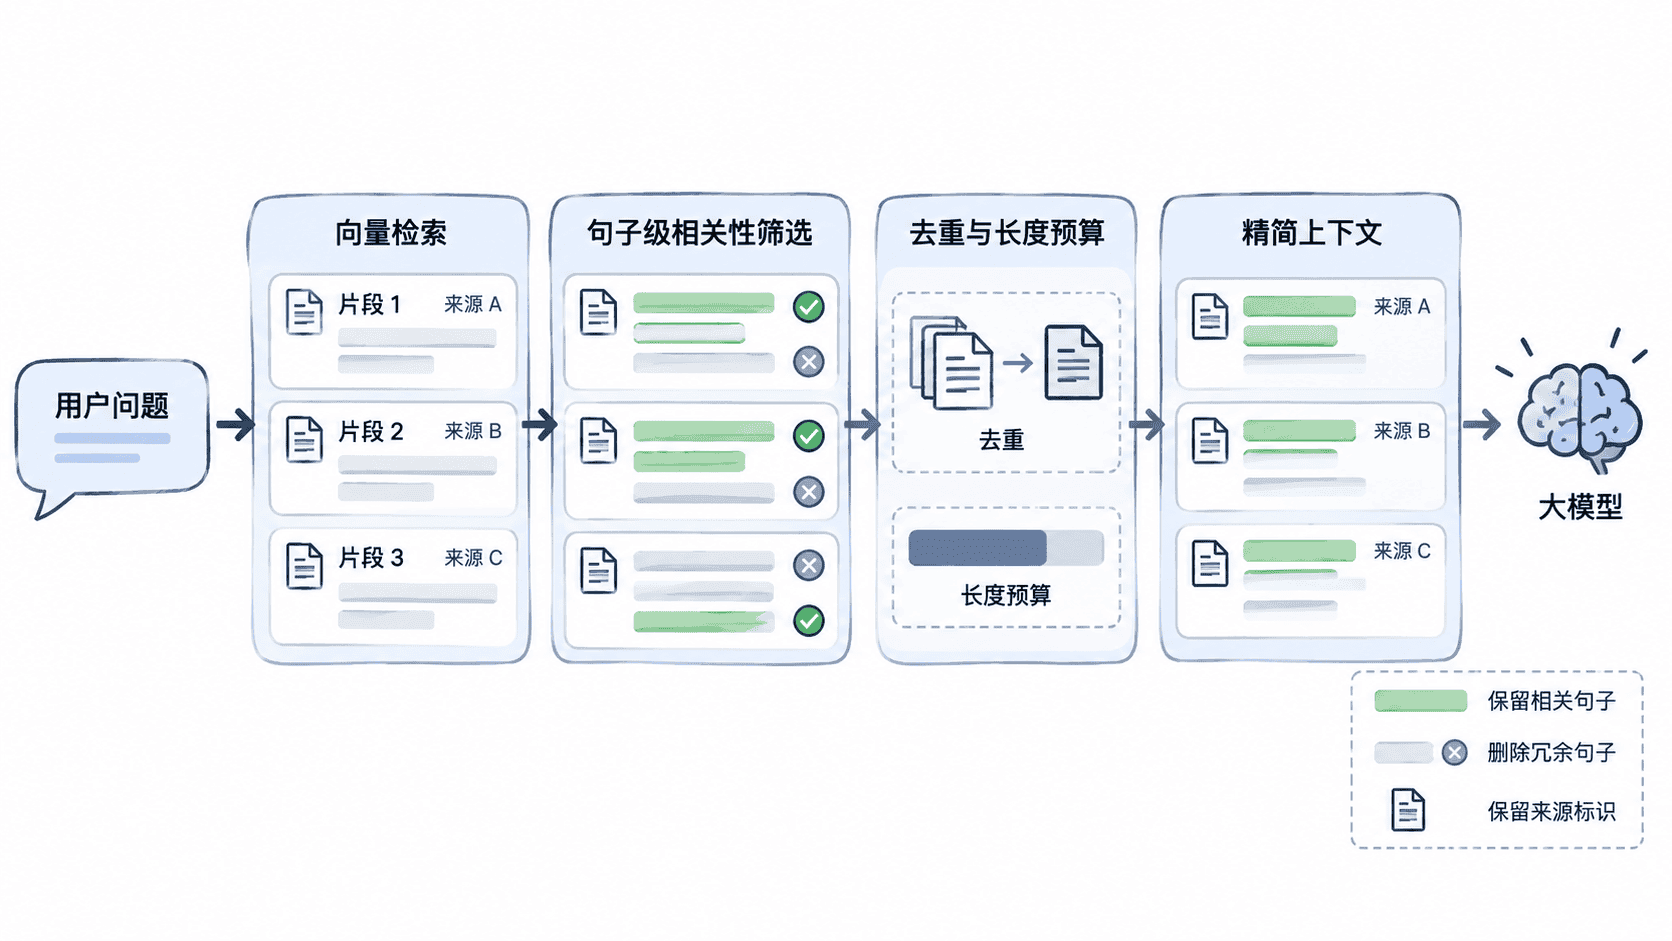
向量检索通常返回完整段落或固定长度切片,其中可能只有一两句真正回答问题。若把所有候选原样拼进提示词,模型既要处理重复信息,也更容易被无关句子干扰。
压缩的目标不是重新检索,而是在已有候选中做第二次筛选:保留能解释问题、支持答案或补足限定条件的句子,删除模板文本、旁支说明和重复内容。
实现句子级压缩
下面的示例用字符重合度做一个最小可运行版本。真实系统可以把 score_sentence 替换成交叉编码器、LLM 判别器或专门的重排模型,但“候选分句—相关性评分—按预算保留”的压缩流程不变。
python
from collections import Counter

def tokenize(text: str) -> list[str]:
    # 保留字母、数字和汉字等字母数字字符,示例无需额外分词依赖。
    return [char.lower() for char in text if char.isalnum()]

def score_sentence(question: str, sentence: str) -> int:
    question_tokens = Counter(tokenize(question))
    sentence_tokens = Counter(tokenize(sentence))
    return sum((question_tokens & sentence_tokens).values())

def compress(question: str, chunks: list[str], max_sentences: int = 3) -> list[str]:
    candidates = []
    for chunk_id, chunk in enumerate(chunks):
        normalized = chunk.replace('!', '。').replace('?', '。').replace('!', '。').replace('?', '。')
        sentences = [item.strip() for item in normalized.split('。') if item.strip()]
        for sentence in sentences:
            score = score_sentence(question, sentence)
            if score > 0:
                candidates.append((score, chunk_id, sentence))

    # 先按相关性排序,再按句子预算截断,同时保留来源编号。
    candidates.sort(key=lambda item: item[0], reverse=True)
    return [f'[source:{chunk_id}] {sentence}' for _, chunk_id, sentence in candidates[:max_sentences]]

if __name__ == '__main__':
    question = 'RAG 为什么要压缩检索上下文'
    chunks = [
        'RAG 会先检索多个候选片段。候选片段中可能包含与检索问题无关的句子。',
        '上下文压缩会保留相关证据并删除冗余内容。这样可以减少提示词长度。',
        '向量数据库也可以保存商品推荐数据。这个话题与当前问题关系较弱。'
    ]
    for line in compress(question, chunks):
        print(line)
预期输出
text
[source:0] RAG 会先检索多个候选片段
[source:1] 上下文压缩会保留相关证据并删除冗余内容
[source:0] 候选片段中可能包含与检索问题无关的句子
这个评分器只用于演示流程,不代表生产级语义相关性判断。替换评分模型后,具体排序可能变化;验证重点是压缩结果明显短于候选全文,同时仍保留可以追溯到原片段的来源标识。
控制压缩预算
压缩器至少要同时约束相关性和长度。只按分数取前几句,可能把同一个来源的重复表述全部保留;只按字符数截断,又可能切掉关键限定条件。
工程上通常先重排候选句,再去重,最后按 token 预算截断。对于定义、条件和结论相互依赖的证据,应尽量作为一个语义单元保留,避免只抽走结论而丢失适用条件。
避免压缩过度
压缩率越高不代表效果越好。问题依赖长距离上下文、答案需要多个条件联合成立、原文中的否定或时间范围很重要,以及后续需要精确引用时,都应降低压缩强度。
最可靠的验收不是单看“上下文变短了”,而是同时比较压缩前后的回答正确率、引用完整性和 token 消耗。只有答案质量没有明显下降时,减少上下文才算真正有效的优化。
按自己的节奏,确认真正理解。