
大模型应用开发 / 系统课时
执行向量检索
执行向量检索
向量检索的核心链路是:把用户问题转换为向量,在同一向量空间中计算相似度,再用返回数量和阈值筛出候选片段。本节实现一个可运行的最小检索器,并说明 top_k 与相似度阈值分别控制什么。
学习目标
- 理解“问题向量化 → 相似度计算 → 排序 → 阈值过滤”的检索过程。
- 正确设置
top_k和相似度阈值,控制候选知识的数量与质量。 - 用可解释的输出检查候选片段是否适合进入后续重排或生成阶段。
从问题到候选片段
检索前,文档片段已经被向量化并写入索引。收到用户问题后,必须使用兼容的嵌入方法生成查询向量;随后计算查询向量与各片段向量的相似度,按分数降序排列,并只保留满足阈值的前 top_k 条。
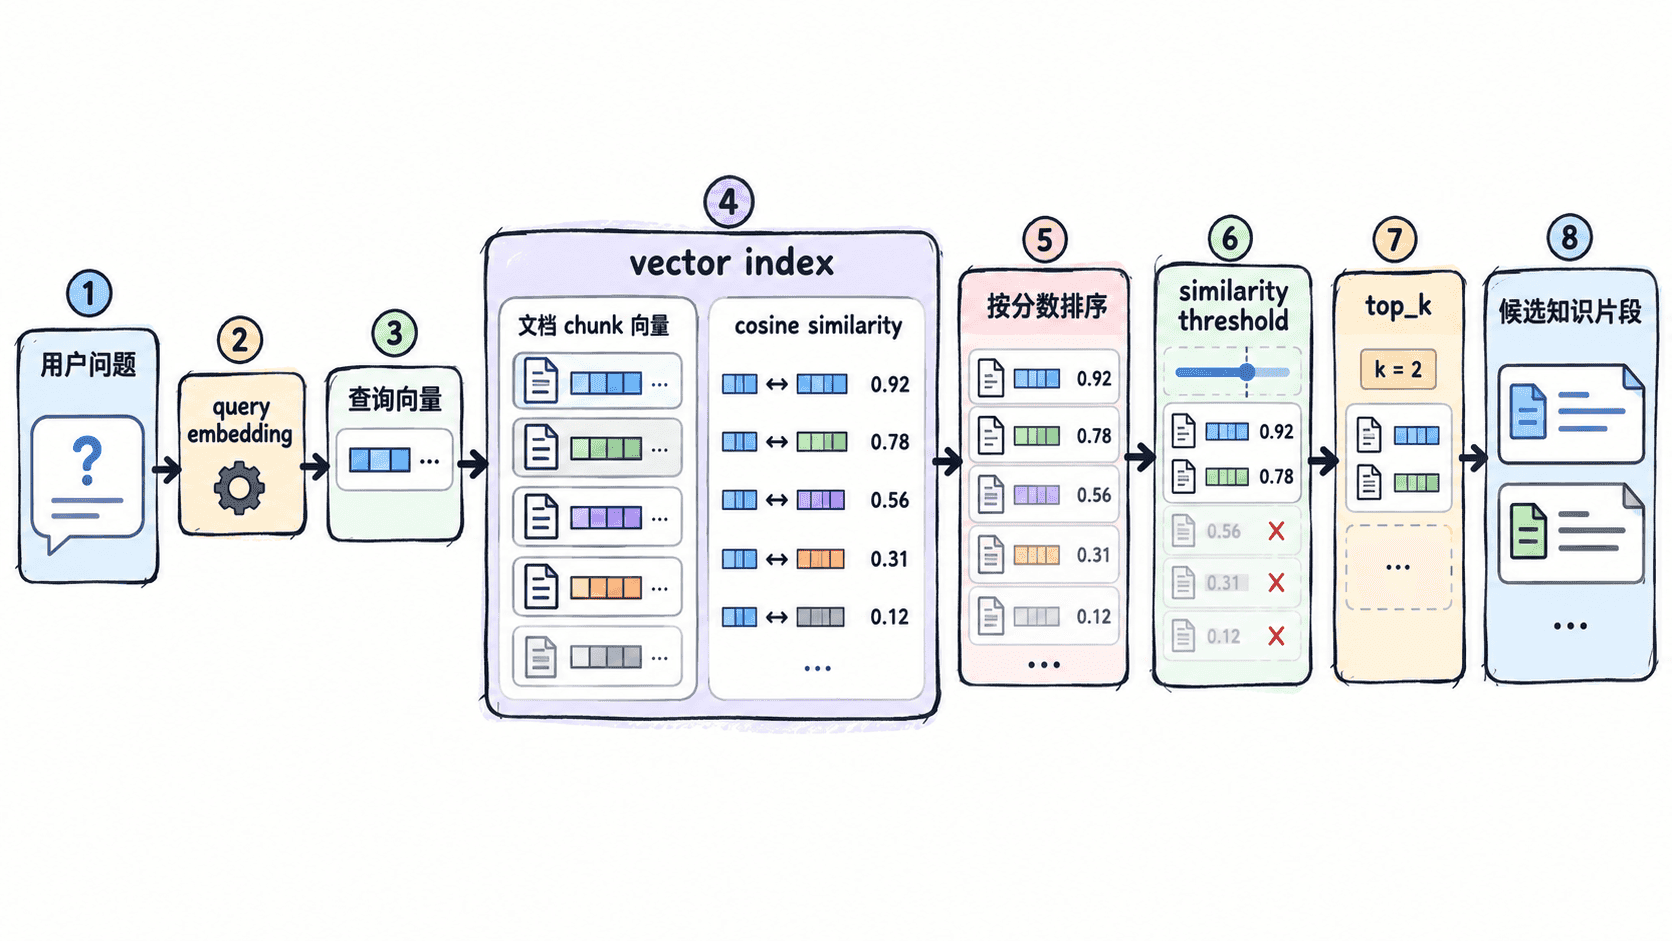
top_k 解决“最多拿多少条”,阈值解决“最低要多相似”。只设 top_k 时,即使所有结果都很差,也会硬返回若干片段;只设阈值时,相关结果很多时又可能返回过多内容。因此二者通常一起使用。
实现一个最小向量检索器
下面用二维向量演示完整检索过程。示例中的向量是预先给定的,目的是把注意力放在检索逻辑本身;接入真实嵌入模型时,只需把 embed_query 替换为实际模型调用,并保证文档与问题使用同一模型和维度。
from dataclasses import dataclass
from math import sqrt

@dataclass
class Record:
    chunk_id: str
    text: str
    vector: list[float]

def cosine_similarity(a: list[float], b: list[float]) -> float:
    dot = sum(x * y for x, y in zip(a, b))
    norm_a = sqrt(sum(x * x for x in a))
    norm_b = sqrt(sum(y * y for y in b))
    return dot / (norm_a * norm_b)

def embed_query(question: str) -> list[float]:
    # 演示中的固定映射用于复现实验结果;真实系统应调用同一嵌入模型。
    if "退款" in question:
        return [1.0, 0.0]
    return [0.0, 1.0]

def search(
    records: list[Record],
    question: str,
    top_k: int,
    min_score: float,
) -> list[tuple[str, float, str]]:
    query_vector = embed_query(question)
    scored = [
        (r.chunk_id, cosine_similarity(query_vector, r.vector), r.text)
        for r in records
    ]
    scored.sort(key=lambda item: item[1], reverse=True)
    return [item for item in scored if item[1] >= min_score][:top_k]

records = [
    Record("c1", "退款期限为 14 天。", [0.98, 0.20]),
    Record("c2", "退款失败时转人工处理。", [0.90, 0.30]),
    Record("c3", "发票可在订单页下载。", [0.15, 0.99]),
]

results = search(
    records,
    question="退款需要在几天内申请?",
    top_k=2,
    min_score=0.80,
)

for chunk_id, score, text in results:
    print(chunk_id, f"{score:.3f}", text)
预期输出:
c1 0.980 退款期限为 14 天。
c2 0.949 退款失败时转人工处理。
实际项目中的相似度数值会受嵌入模型、向量归一化方式和向量库距离定义影响,因此不要把示例中的 0.80 当成通用阈值。应使用自己的查询集观察相关与不相关片段的分数分布后再定。
调整 top_k 与相似度阈值
top_k 太小,可能漏掉后续重排所需的相关片段;太大,则会增加重排和生成上下文成本。对简单事实问答,可以从较小值开始;需要多证据拼接时,可以提高 top_k,再交给重排器压缩。
阈值太低会让弱相关内容进入候选集,增加模型“被错误上下文带偏”的风险;阈值太高则可能让答案需要的片段被提前丢弃。一个常见做法是先设较宽松的召回阈值,再通过重排分数、文档权限、时间范围等条件二次过滤。
验收检索结果
上线前应准备一组带已知答案来源的问题,记录“目标片段是否进入前 top_k”“目标片段分数”“首条错误片段分数”等指标。这样调参依据来自真实检索表现,而不是凭感觉修改阈值。
当候选片段能够稳定覆盖正确知识时,向量检索阶段就完成了它的职责:尽量把可能相关的内容召回。后续是否最终采用某个片段,应继续交给 metadata 过滤、重排和生成阶段判断,而不是把“向量最相似”直接等同于“答案一定正确”。