
大模型应用开发 / 系统课时
构建企业知识助手
构建企业知识助手
本节把企业知识助手压缩成一条可验证的最小链路:文档可增量导入,查询同时走关键词与向量通道,答案携带来源,并在检索前执行权限过滤,最后用小型评测集检查召回、引用和越权风险。
学习目标
- 设计知识导入、增量索引、混合检索、引用问答与权限过滤的完整链路。
- 用一个可运行的本地示例验证增量更新、检索融合和引用输出。
- 用可重复指标评测召回、引用正确性与权限泄漏风险。
先定义可验收的企业能力
企业知识助手不能只做到“能回答”。最小验收应覆盖六件事:同一文档重复导入时不重复索引;内容或权限变更时只更新受影响文档;关键词与向量结果可以融合;回答能返回稳定来源标识;无权限文档在检索阶段就被排除;固定问题集可以重复评测。
这里最重要的边界是权限过滤顺序。先取回全库 Top K 再过滤,会让无权限内容参与候选排序,还可能通过日志、缓存或调试信息暴露元数据。更稳妥的做法是先根据用户身份得到 ACL 过滤条件,再让关键词通道和向量通道都只在允许集合内检索。
把导入、检索和问答串成一条安全链路
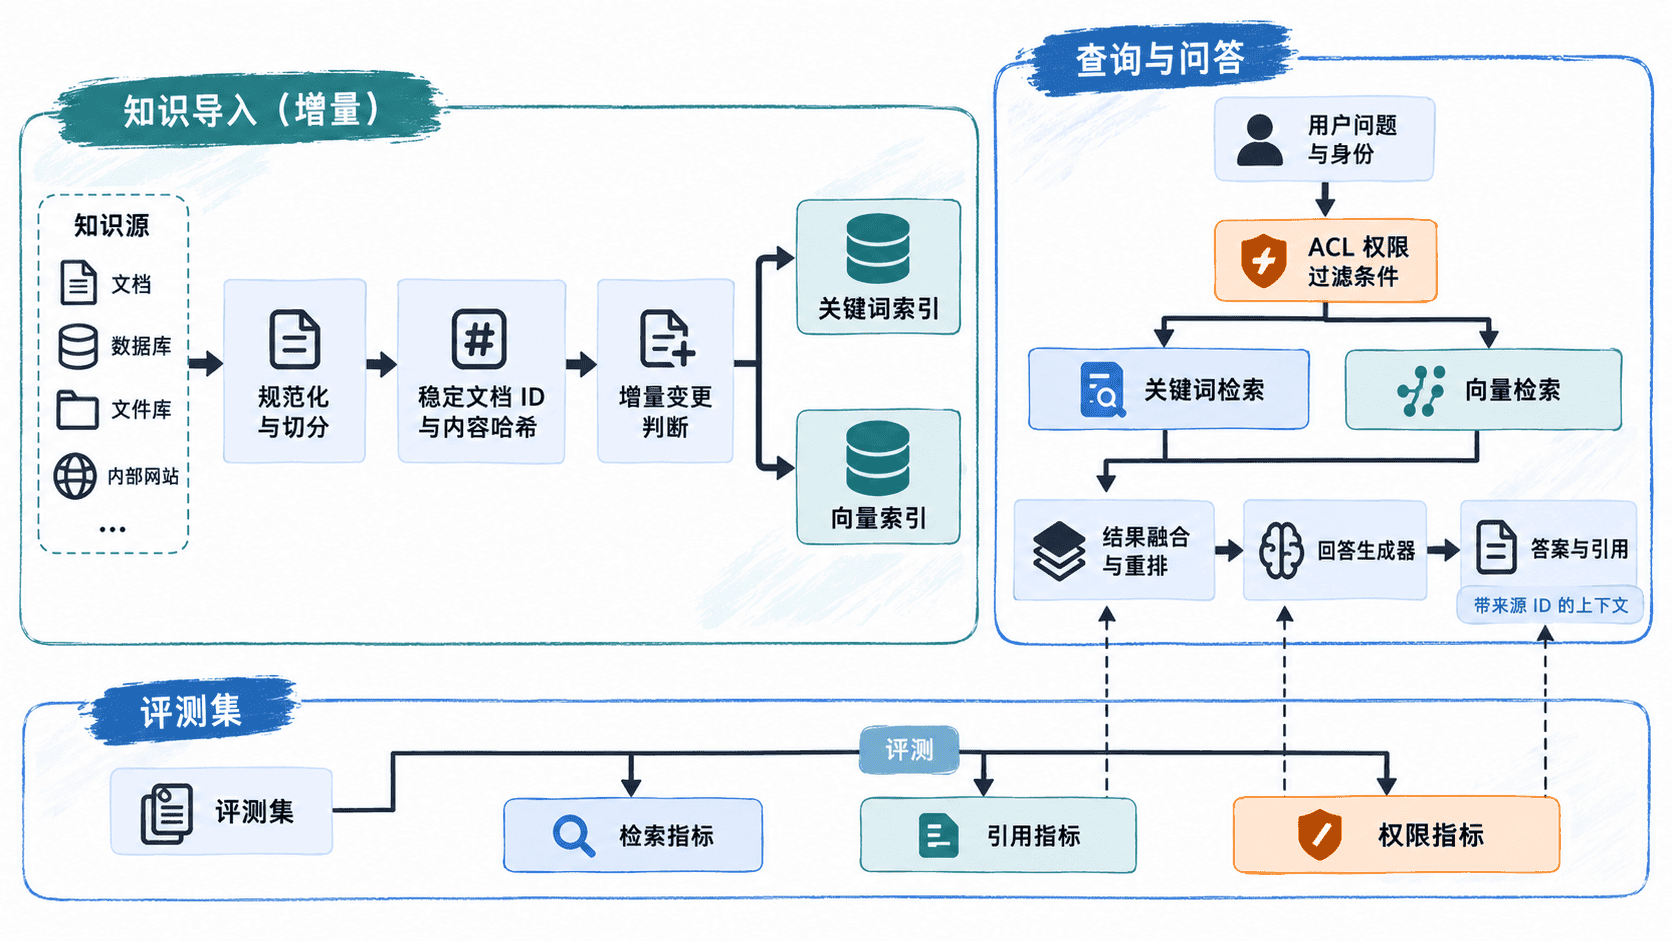
导入侧需要稳定标识和变更指纹。稳定 doc_id 决定“这是不是同一个知识对象”,而内容、版本与 ACL 共同计算的哈希决定“这次是否需要重建索引”。查询侧则把授权条件当成检索输入,而不是问答完成后的补救步骤。
用最小实现跑通六个能力
下面的 Python 示例只依赖标准库。关键词通道使用字符与二元片段重合度,向量通道使用确定性的特征哈希向量;这只是为了本地可运行,生产环境应把向量通道替换成真实 Embedding 服务,并把内存索引替换为可持久化检索引擎。其余控制点——增量指纹、ACL 前置过滤、融合排序、引用和评测——可以直接迁移。
from __future__ import annotations

from collections import Counter
from dataclasses import dataclass
import hashlib
import math
import re

@dataclass(frozen=True)
class Document:
    doc_id: str
    text: str
    acl: frozenset[str]
    version: str

def lexical_features(text: str) -> Counter[str]:
    parts = re.findall(r"[a-z0-9]+|[\u4e00-\u9fff]+", text.lower())
    features: list[str] = []
    for part in parts:
        if re.fullmatch(r"[a-z0-9]+", part):
            features.append(part)
            continue
        chars = list(part)
        features.extend(chars)
        features.extend("".join(chars[i : i + 2]) for i in range(len(chars) - 1))
    return Counter(features)

def hashed_vector(features: Counter[str], dims: int = 64) -> list[float]:
    vector = [0.0] * dims
    for token, count in features.items():
        digest = hashlib.sha256(token.encode("utf-8")).digest()
        bucket = digest[0] % dims
        sign = 1.0 if digest[1] % 2 == 0 else -1.0
        vector[bucket] += sign * count
    return vector

def cosine(left: list[float], right: list[float]) -> float:
    dot = sum(a * b for a, b in zip(left, right))
    left_norm = math.sqrt(sum(a * a for a in left))
    right_norm = math.sqrt(sum(b * b for b in right))
    return dot / (left_norm * right_norm) if left_norm and right_norm else 0.0

def overlap_score(query: Counter[str], doc: Counter[str]) -> float:
    query_terms = set(query)
    return len(query_terms & set(doc)) / max(len(query_terms), 1)

class EnterpriseAssistant:
    def __init__(self) -> None:
        self.index: dict[str, dict] = {}

    @staticmethod
    def fingerprint(doc: Document) -> str:
        payload = "|".join([doc.version, doc.text, ",".join(sorted(doc.acl))])
        return hashlib.sha256(payload.encode("utf-8")).hexdigest()

    def ingest(self, documents: list[Document]) -> dict[str, int]:
        updated = 0
        unchanged = 0
        for doc in documents:
            fingerprint = self.fingerprint(doc)
            previous = self.index.get(doc.doc_id)
            if previous and previous["fingerprint"] == fingerprint:
                unchanged += 1
                continue
            features = lexical_features(doc.text)
            self.index[doc.doc_id] = {
                "doc": doc,
                "fingerprint": fingerprint,
                "lexical": features,
                "vector": hashed_vector(features),
            }
            updated += 1
        return {"added_or_updated": updated, "unchanged": unchanged}

    def search(self, query: str, groups: set[str], top_k: int = 3) -> list[Document]:
        query_features = lexical_features(query)
        query_vector = hashed_vector(query_features)
        scored: list[tuple[float, Document]] = []
        for item in self.index.values():
            doc: Document = item["doc"]
            # ACL 在两个检索分数计算前生效,禁止无权限文档进入候选集。
            if not groups.intersection(doc.acl):
                continue
            keyword = overlap_score(query_features, item["lexical"])
            vector = cosine(query_vector, item["vector"])
            score = 0.55 * keyword + 0.45 * vector
            scored.append((score, doc))
        scored.sort(key=lambda item: item[0], reverse=True)
        return [doc for score, doc in scored[:top_k] if score > 0]

    def ask(self, query: str, groups: set[str]) -> dict:
        hits = self.search(query, groups, top_k=2)
        if not hits:
            return {"answer": "未找到可访问的相关知识。", "citations": []}
        # 教学示例直接用首条证据作为答案;生产环境在这里调用受控的生成模型。
        return {
            "answer": hits[0].text,
            "citations": [{"doc_id": doc.doc_id} for doc in hits],
        }

    def evaluate(self, cases: list[dict]) -> dict[str, float]:
        recalled = 0
        citation_ok = 0
        leakage = 0
        for case in cases:
            groups = set(case["groups"])
            hits = self.search(case["query"], groups, top_k=1)
            recalled += int(bool(hits) and hits[0].doc_id == case["expected_doc"])
            response = self.ask(case["query"], groups)
            citation_ids = {item["doc_id"] for item in response["citations"]}
            citation_ok += int(case["expected_doc"] in citation_ids)
            leakage += sum(not groups.intersection(doc.acl) for doc in hits)
        total = len(cases)
        return {
            "recall_at_1": recalled / total,
            "citation_precision": citation_ok / total,
            "access_leakage": leakage / total,
        }

def main() -> None:
    assistant = EnterpriseAssistant()
    docs_v1 = [
        Document("doc-refund", "退款申请需要订单号。企业客户由财务审批。", frozenset({"support", "finance"}), "1"),
        Document("doc-password", "研发环境数据库密码轮换周期为90天,只有platform组可查看。", frozenset({"platform"}), "1"),
        Document("doc-invoice", "发票开具需要合同编号和订单号,由finance组处理。", frozenset({"finance"}), "1"),
    ]
    docs_v2 = [
        Document("doc-refund", "退款申请需要订单号和客户编号。企业客户由财务审批。", frozenset({"support", "finance"}), "2"),
        docs_v1[1],
        docs_v1[2],
    ]

    print("首次导入:", assistant.ingest(docs_v1))
    print("增量导入:", assistant.ingest(docs_v2))
    response = assistant.ask("企业客户退款需要什么资料", {"support"})
    print("答案:", response["answer"])
    print("引用:", [item["doc_id"] for item in response["citations"]])

    cases = [
        {"query": "企业客户退款需要什么资料", "groups": ["support"], "expected_doc": "doc-refund"},
        {"query": "研发数据库密码多久轮换", "groups": ["platform"], "expected_doc": "doc-password"},
    ]
    print("评测:", assistant.evaluate(cases))

if __name__ == "__main__":
    main()
预期输出
首次导入: {'added_or_updated': 3, 'unchanged': 0}
增量导入: {'added_or_updated': 1, 'unchanged': 2}
答案: 退款申请需要订单号和客户编号。企业客户由财务审批。
引用: ['doc-refund']
评测: {'recall_at_1': 1.0, 'citation_precision': 1.0, 'access_leakage': 0.0}第一次导入写入三条知识;第二次只有退款文档的内容与版本发生变化,因此只重建一条索引。support 用户无法访问 doc-invoice 和 doc-password,所以这两条文档不会进入该问题的候选集。示例中的动态排序分数没有打印,避免把实现细节误当成稳定接口。
验收检索、引用与权限
评测不要只看“答案像不像”。检索层至少检查目标文档是否进入前 K;引用层检查答案引用的 doc_id 是否来自实际检索证据;权限层检查无权限文档是否进入候选集。示例用两个固定问题得到 recall_at_1=1.0、citation_precision=1.0 和 access_leakage=0.0,证明这组最小数据上的三条门禁都通过。
真正接入生成模型后,还应把“答案正确”与“引用正确”分开评分。模型即使写出正确答案,也可能引用错误来源;反过来,检索到了正确文档,生成阶段也可能遗漏限定条件。企业场景应保留检索结果、最终引用和权限上下文的可审计记录,但日志本身不能记录用户无权看到的正文。
上生产前补齐的边界
本地示例解决的是链路正确性,不是容量与可靠性。生产实现应把单文档扩展为可追踪的 chunk,并让 chunk 继承文档级 ACL;把内容哈希、版本和删除标记写入持久化元数据;关键词索引与向量索引都支持同一权限过滤条件;融合后再做重排,并限制送入模型的上下文数量。
评测集也应跟随知识库演进。每次索引策略、切分方式、Embedding 模型、融合权重或权限逻辑变更,都用同一批核心问题做回归,再补充线上失败样本。这样,企业知识助手的“可用”就不再依赖人工试问,而是由增量一致性、检索质量、引用可追溯和权限零泄漏共同定义。