
大模型应用开发 / 系统课时
按字符递归切分
按字符递归切分
普通文本没有稳定的章节结构时,最实用的做法是按字符长度递归切分:先尽量沿段落和句子边界拆分,再用重叠保留相邻片段的上下文。本节会完成一个可运行的最小实现,并说明片段长度、重叠范围和分隔符优先级如何配合。
学习目标
- 理解递归切分为什么比固定字符截断更能保留语义边界。
- 配置片段长度、重叠范围与分隔符优先级。
- 用可运行的 Python 示例完成切分并检查结果。
递归切分在解决什么
固定每隔 N 个字符直接截断,可能把一个句子、定义或参数说明从中间切开。递归切分则先尝试较粗的边界,例如空行和换行;片段仍然过长时,再继续尝试句号、逗号、空格,最后才退化为硬切字符。
这里有三个核心参数:chunk_size 限制单个基础片段的最大长度,overlap 把上一片段尾部复制到下一片段开头,separators 决定边界尝试顺序。优先级应从“语义更强”到“语义更弱”排列。
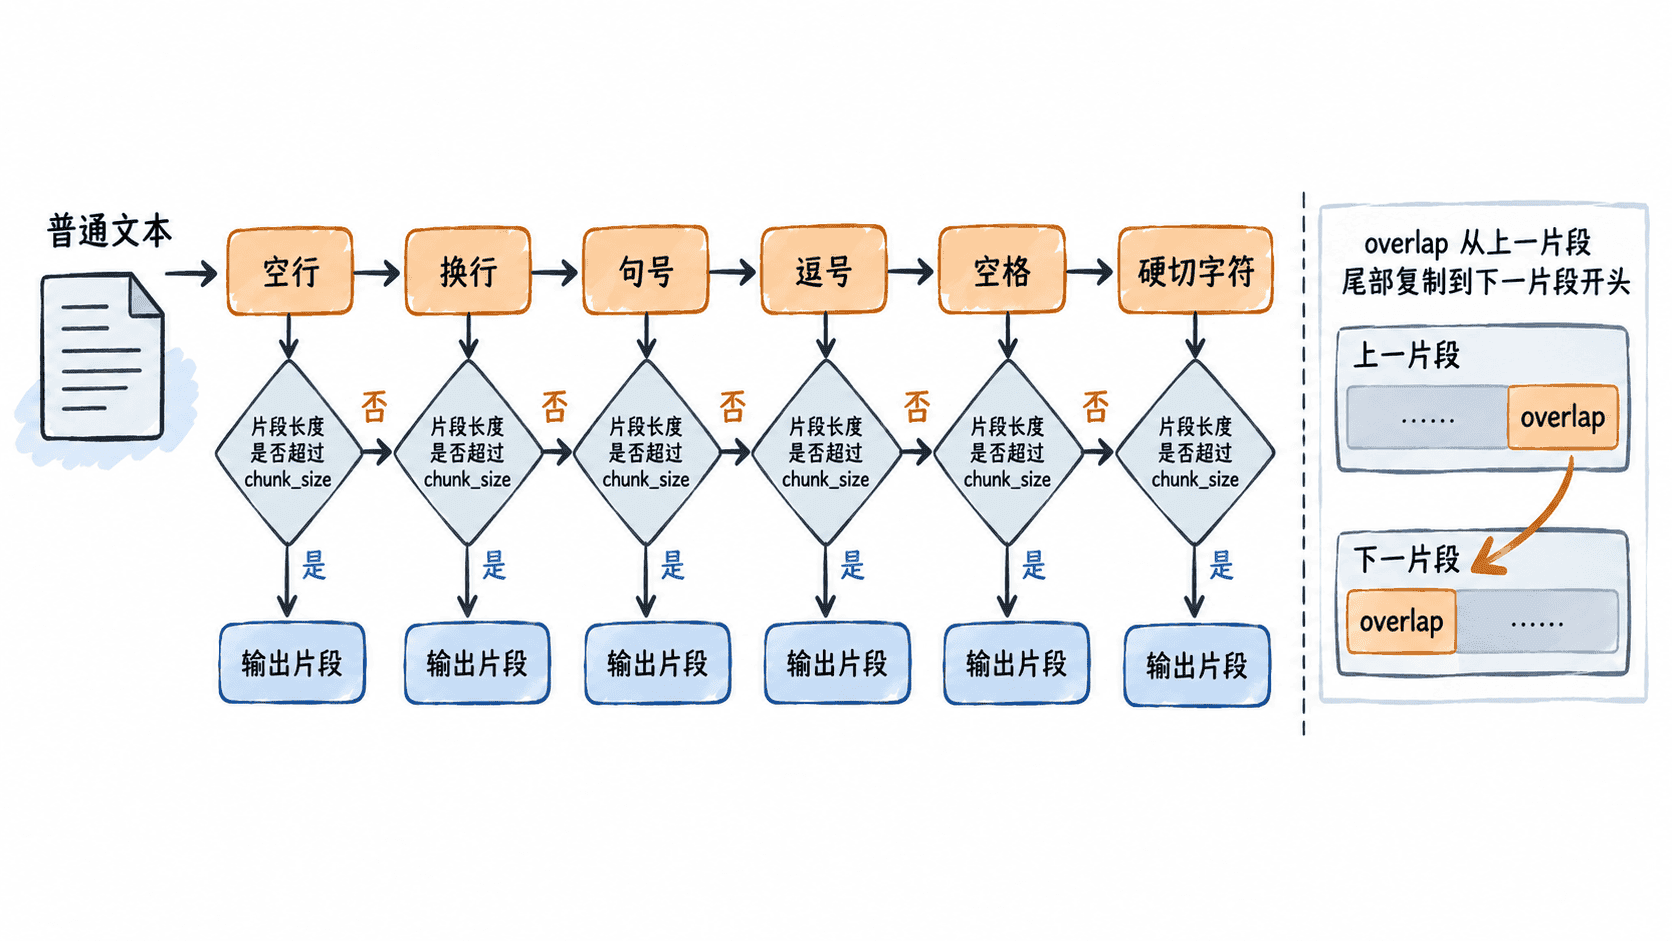
配置分隔符和重叠
对中文普通文本,可以从 ("\n\n", "\n", "。", ",", " ", "") 这样的顺序开始:先保持段落,再保持行和句子,最后才允许硬切。空字符串必须放在最后,它代表“前面的自然边界都无法满足长度限制时,按字符截断”。
overlap 不是越大越好。过小会让跨片段的定义与解释失联,过大则会制造重复向量、增加索引体积,并让检索结果出现高度相似的片段。实际应用应结合嵌入模型和检索评测调整,而不是只凭字符数决定。
用 Python 完成递归切分
下面的实现不依赖第三方库。它先递归生成满足长度限制的基础片段,再统一添加字符重叠,适合用来理解递归切分器的工作方式。
def split_keep_separator(text: str, sep: str) -> list[str]:
    if not sep:
        return [text]

    raw = text.split(sep)
    return [
        part + (sep if i < len(raw) - 1 else "")
        for i, part in enumerate(raw)
        if part
    ]

def recursive_units(
    text: str,
    chunk_size: int,
    separators: tuple[str, ...],
) -> list[str]:
    text = text.strip()
    if not text or len(text) <= chunk_size:
        return [text] if text else []

    # 优先选择当前文本中仍然存在的最粗分隔符。
    sep = next((s for s in separators if s and s in text), "")
    if not sep:
        return [
            text[i : i + chunk_size]
            for i in range(0, len(text), chunk_size)
        ]

    result, current = [], ""
    for part in split_keep_separator(text, sep):
        candidate = current + part
        if len(candidate) <= chunk_size:
            current = candidate
            continue

        if current:
            result.extend(
                recursive_units(current, chunk_size, separators[1:])
            )

        # 单个部分本身仍过长时,继续使用更细的分隔符递归拆分。
        if len(part) > chunk_size:
            result.extend(
                recursive_units(part, chunk_size, separators[1:])
            )
            current = ""
        else:
            current = part

    if current:
        result.extend(
            recursive_units(current, chunk_size, separators[1:])
        )

    return [item.strip() for item in result if item.strip()]

def add_overlap(units: list[str], overlap: int) -> list[str]:
    chunks, previous = [], ""

    for unit in units:
        prefix = (
            previous[-overlap:]
            if previous and overlap > 0
            else ""
        )
        chunks.append(prefix + unit)
        previous = chunks[-1]

    return chunks

text = (
    "RAG 先把文档切成片段,再为片段建立向量索引。\n\n"
    "片段太长会混入多个主题,检索命中后也会浪费上下文窗口。"
    "片段太短则容易丢失定义与解释之间的联系。\n\n"
    "递归切分会优先尝试段落、换行、句号等分隔符,"
    "直到片段满足长度限制。"
)

chunks = add_overlap(
    recursive_units(
        text,
        chunk_size=45,
        separators=("\n\n", "\n", "。", ",", " ", ""),
    ),
    overlap=8,
)

for i, chunk in enumerate(chunks, 1):
    print(f"{i}: {chunk}")
预期输出:
1: RAG 先把文档切成片段,再为片段建立向量索引。
2: 段建立向量索引。片段太长会混入多个主题,检索命中后也会浪费上下文窗口。
3: 浪费上下文窗口。片段太短则容易丢失定义与解释之间的联系。
4: 解释之间的联系。递归切分会优先尝试段落、换行、句号等分隔符,直到片段满足长度限制。
调整策略时检查什么
验证切分结果时,不要只看片段是否小于上限。还要随机抽查定义、列表项和完整句子是否被不必要地拆开,并观察检索结果中是否出现大量仅因重叠而相似的片段。
如果文本天然以段落表达独立主题,应优先保护空行和换行;如果是连续中文说明,则句号通常比逗号更重要。递归切分的目标不是得到“完全等长”的片段,而是在长度约束下尽可能保留可检索、可理解的局部语义。