
大模型应用开发 / 系统课时
更新与删除索引
更新与删除索引
文档被修订或下线后,不能只追加新向量,否则旧片段仍可能被召回。本节用文档唯一编号把一个文档的所有片段视为同一批次,完成“先移除旧片段,再写入新片段”的更新流程,并验证删除后旧知识不再参与检索。
学习目标
- 用稳定的
document_id关联同一文档产生的全部向量片段。 - 实现文档级更新与删除,避免新旧片段同时存在。
- 通过检索结果验证索引变更已经生效。
用唯一编号管理片段
向量索引中的每条记录至少应包含片段编号、文档编号、文本和向量。chunk_id 标识单个片段,document_id 标识它属于哪份源文档。更新文档时,不要猜测旧文档有多少片段,而应按 document_id 找出并删除整组旧记录。
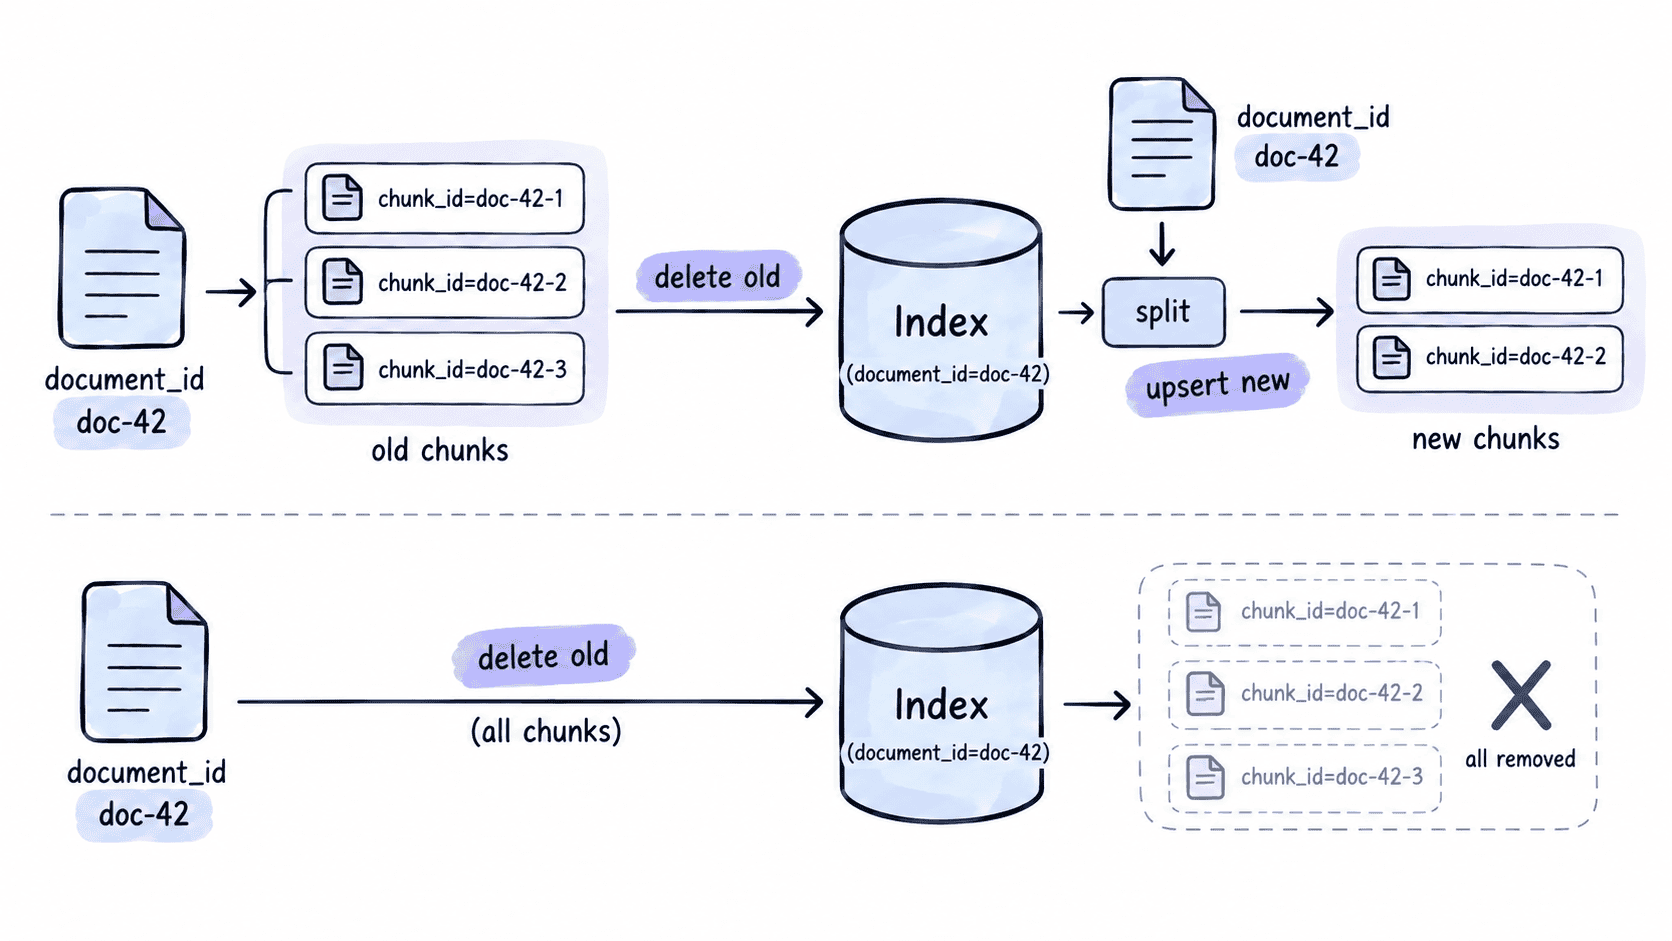
真正需要保持稳定的是 document_id。片段数量、片段边界甚至嵌入模型都可能变化,因此不要把“第几个片段”当作文档身份。文档更新后重新切分,再为新片段生成新的 chunk_id,可以让索引结构与当前正文一致。
实现文档级更新和删除
下面的示例用内存结构模拟向量索引,重点展示文档级删除与替换语义。真实向量数据库中应把 delete_by_document_id 对应为 metadata/filter 删除,把 upsert_chunks 对应为批量 upsert。
from dataclasses import dataclass

@dataclass
class Chunk:
    chunk_id: str
    document_id: str
    text: str

class VectorIndex:
    def __init__(self):
        self.records: dict[str, Chunk] = {}

    def upsert_chunks(self, chunks: list[Chunk]) -> None:
        for chunk in chunks:
            self.records[chunk.chunk_id] = chunk

    def delete_by_document_id(self, document_id: str) -> int:
        # 先找出同一文档的全部片段,避免只删到部分旧知识。
        targets = [
            chunk_id
            for chunk_id, chunk in self.records.items()
            if chunk.document_id == document_id
        ]
        for chunk_id in targets:
            del self.records[chunk_id]
        return len(targets)

    def update_document(self, document_id: str, texts: list[str]) -> None:
        self.delete_by_document_id(document_id)
        # 重新切分后生成新的片段编号,再作为一个批次写入。
        chunks = [
            Chunk(f"{document_id}-v2-{i}", document_id, text)
            for i, text in enumerate(texts, start=1)
        ]
        self.upsert_chunks(chunks)

    def texts_of(self, document_id: str) -> list[str]:
        return [
            chunk.text
            for chunk in self.records.values()
            if chunk.document_id == document_id
        ]

index = VectorIndex()
index.upsert_chunks([
    Chunk("doc-42-v1-1", "doc-42", "旧规则:退款期限为 7 天。"),
    Chunk("doc-42-v1-2", "doc-42", "旧规则:仅支持原路退款。"),
])

index.update_document("doc-42", [
    "新规则:退款期限为 14 天。",
    "新规则:原路退款失败时可转人工处理。",
])
print(index.texts_of("doc-42"))

deleted = index.delete_by_document_id("doc-42")
print("deleted:", deleted)
print(index.texts_of("doc-42"))
预期输出:
['新规则:退款期限为 14 天。', '新规则:原路退款失败时可转人工处理。']
deleted: 2
[]
真实系统里,更新通常还包括重新切分和重新生成向量。关键顺序是“识别旧批次 → 删除旧片段 → 写入新片段 → 验证”,而不是在旧片段旁边继续追加。
避免更新窗口留下脏数据
如果删除旧片段后、写入新片段前进程失败,索引会暂时缺少该文档;如果先写新片段再删旧片段,则短时间内可能同时召回两个版本。生产环境应根据向量库能力选择事务、版本号或双索引切换来缩短这个不一致窗口。
还应把源文档版本写入 metadata,例如 version=2026-09-04。检索链路可以暂时只放行当前版本,在后台完成新旧索引切换后再清理历史版本,这样更适合大文档或批量更新。
验证旧知识已经退出检索
索引更新完成后,至少验证三件事:当前文档的片段数与新切分结果一致;旧 chunk_id 已不存在;使用能命中旧知识的测试问题进行检索时,不再返回旧文本。删除文档时同样要验证该 document_id 的片段数归零。
若业务还保留缓存、重排结果缓存或问答结果缓存,只删除向量记录并不够。缓存中的旧答案仍可能被用户看到,因此文档更新事件最好同时触发相关缓存失效。索引治理的目标不是“写入成功”,而是确保线上检索只看到当前有效知识。