
大模型应用开发 / 系统课时
生成来源引用
生成来源引用
RAG 的引用不是在答案末尾随便附几条链接,而是要把每个可核验结论绑定到本次真正参与生成的上下文片段。完成这一节后,你可以用稳定的来源编号生成引用,并在输出前过滤未参与回答或不存在的来源。
学习目标
- 为检索片段设计可追踪的来源元数据与稳定编号。
- 让答案只引用实际进入生成上下文的片段。
- 在返回前校验引用编号,并渲染标题、章节、页码或链接。
先把来源信息放进检索片段
引用能否可靠,取决于入库时是否保留足够的元数据。每个 chunk 至少应保存文档标识、标题和可定位位置;PDF 可以记录页码,网页可以记录规范链接,长文档还可以记录章节名。
推荐把“内容”和“展示用来源信息”分开保存。例如一个片段可以拥有 source_id、title、section、page、url 等字段。检索阶段只负责找内容,生成阶段用 source_id 建立引用,最后再把编号映射成人类可读来源。
只给参与回答的片段分配引用编号
实际系统通常先召回较多候选,再经过重排、阈值过滤或上下文预算裁剪。引用编号应在“最终上下文”确定后再分配,而不是给所有候选都编号,否则答案很容易附上没有参与生成的片段。
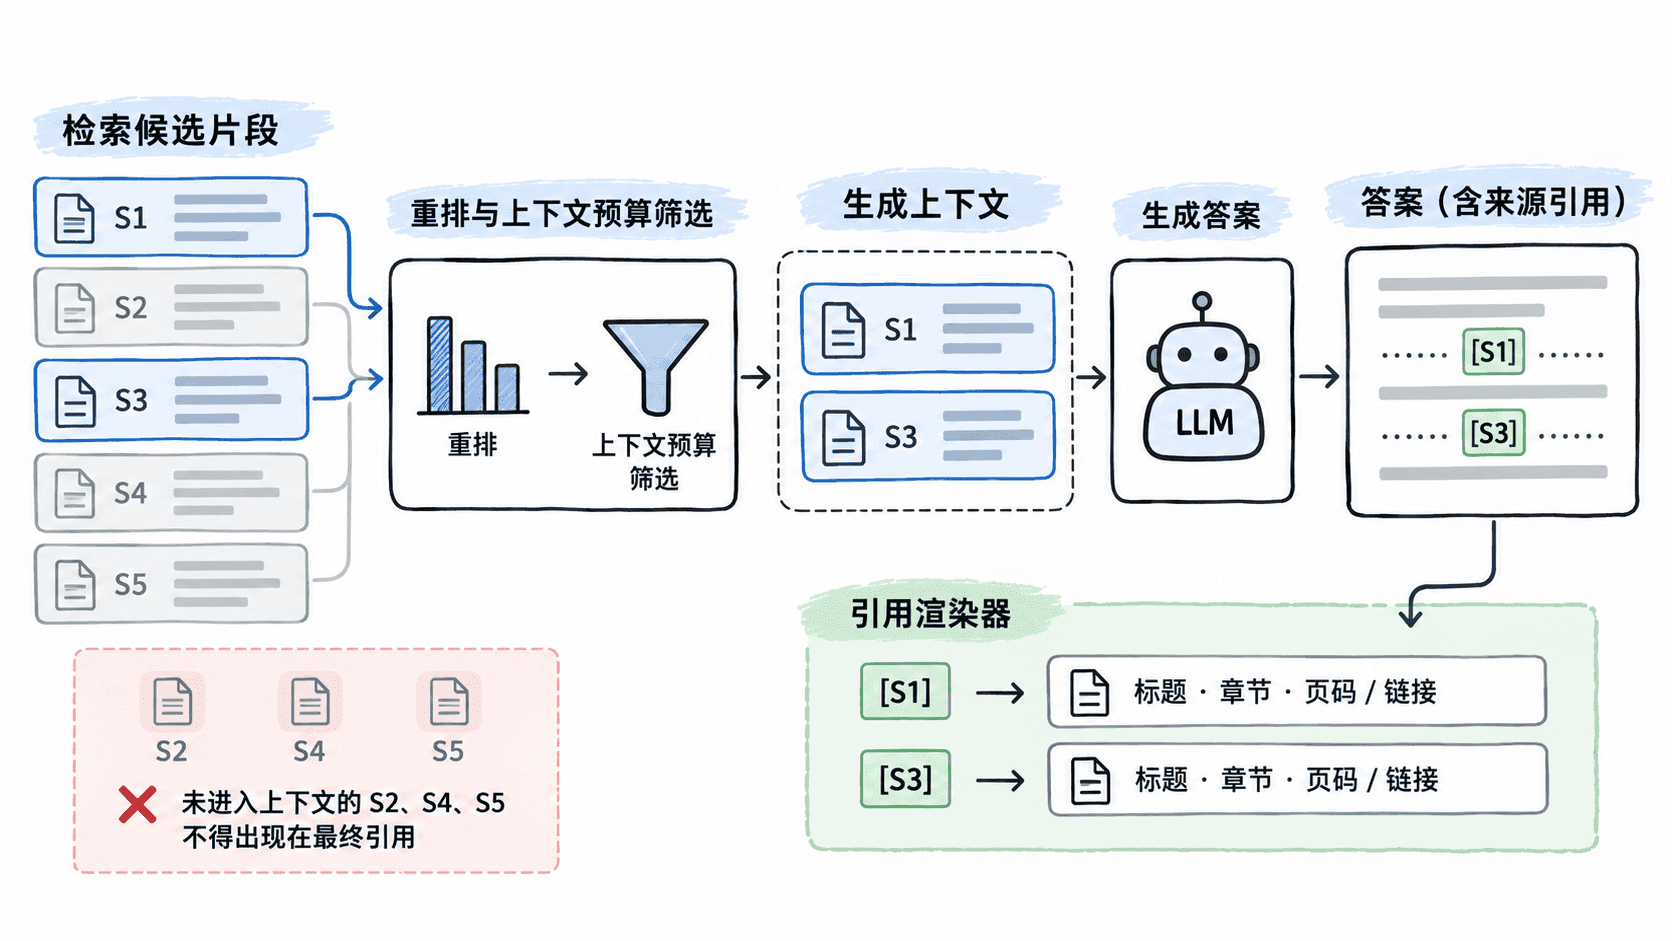
下面的最小示例展示了一个安全做法:先给最终上下文分配 S1、S2,模型只返回这些编号,应用再验证并渲染来源。示例不依赖第三方库,可直接运行。
from dataclasses import dataclass

@dataclass
class Chunk:
    source_id: str
    text: str
    title: str
    section: str
    page: int | None = None
    url: str | None = None

def render_answer(answer: str, chunks: list[Chunk]) -> str:
    allowed = {chunk.source_id: chunk for chunk in chunks}
    used = []
    rendered = answer

    # 只处理当前生成上下文中真实存在的来源编号。
    for source_id, chunk in allowed.items():
        marker = f"[{source_id}]"
        if marker not in answer:
            continue
        used.append(chunk)
        rendered = rendered.replace(marker, f"[{len(used)}]")

    lines = [rendered, ""]
    for index, chunk in enumerate(used, start=1):
        location = f"{chunk.section} / p.{chunk.page}" if chunk.page else chunk.section
        suffix = f" / {chunk.url}" if chunk.url else ""
        lines.append(f"[{index}] {chunk.title} / {location}{suffix}")

    return "\n".join(lines)

context = [
    Chunk("S1", "订单完成后 7 天内可申请退款。", "帮助中心", "退款规则", 12),
    Chunk("S2", "到账时间通常为 1 至 3 个工作日。", "帮助中心", "退款到账", 13),
]
model_answer = "退款需要在订单完成后 7 天内申请。[S1]"
print(render_answer(model_answer, context))
预期输出
退款需要在订单完成后 7 天内申请。[1]

[1] 帮助中心 / 退款规则 / p.12
这里 S2 虽然进入了上下文,但答案没有使用它,因此不会被渲染成引用。更严格的实现还应扫描模型输出中的所有 [Sx] 标记:如果出现不在允许集合中的编号,应拒绝该答案、删除非法引用或重新生成,而不是把不存在的来源展示给用户。
让引用落到可核验的位置
“来源:产品手册”通常还不够。用户需要能快速核验答案,所以引用粒度应与文档形态匹配:PDF 优先提供标题、章节和页码;网页优先提供标题、章节锚点和规范链接;数据库记录则应提供稳定记录 ID,而不是易变化的列表序号。
对于被切成多个 chunk 的同一页,不必把每个 chunk 都展示成独立来源。可以在渲染阶段按文档、章节和页码合并重复引用,但保留内部 source_id,这样既能追踪模型到底用了哪个片段,又不会把界面塞满重复条目。
校验引用是否真的支持结论
“引用存在”不等于“引用正确”。生成后至少要做两层检查:第一层验证编号是否合法,第二层检查被引用片段是否包含支持该结论的证据。前者可以纯代码完成,后者可以用关键词规则、语义相似度或额外的判定模型实现。
可靠引用的关键不是“多放来源”,而是保持一条可审计链路:最终上下文片段拥有真实元数据,答案只使用允许的来源编号,应用再把这些编号渲染为用户可核验的位置。这样即使检索结果很多,也不会把未参与回答的片段冒充成证据。