
大模型应用开发 / 系统课时
构建评测数据集
构建评测数据集
RAG 的优化不能只靠主观试问。本节把真实问题、参考答案、相关文档和问题类型整理成可重复运行的数据集,并加入最小校验规则,最终得到一份能长期用于检索与生成评测的稳定样本。
学习目标
- 设计包含问题、参考答案、相关文档和问题类型的评测样本结构
- 从真实问题中抽取覆盖核心场景与边界场景的测试集
- 用脚本校验样本完整性并导出可复用的 JSONL 文件
先定义一条样本需要什么
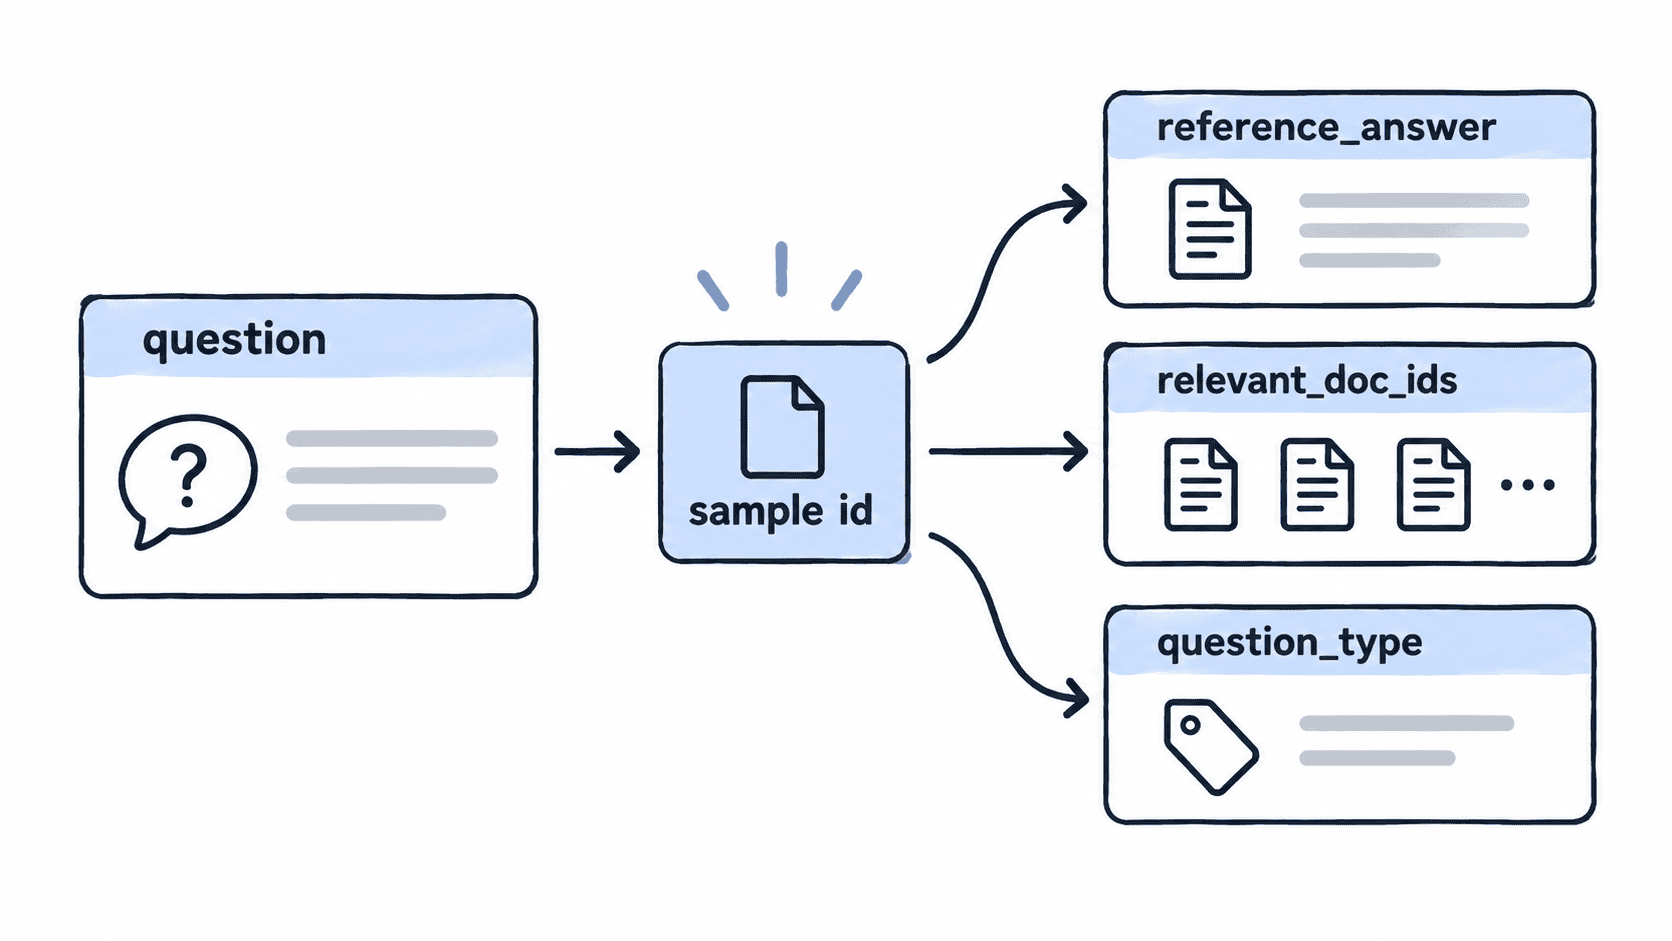
一条评测样本至少要回答四个问题:用户问了什么、理想答案是什么、哪些文档片段可以支持答案、它属于哪类问题。这样既能评估检索是否找对知识,也能继续评估生成答案是否忠于证据。
建议把样本设计为稳定的机器可读结构:id 用于追踪,question 保存原始问题,reference_answer 保存人工确认的参考答案,relevant_doc_ids 保存相关文档标识,question_type 用于分组统计。
选择能暴露问题的测试样本
不要只收集“系统肯定答得对”的问题。一个小而有效的数据集应同时覆盖高频业务问题、容易混淆的问题、跨文档问题、无答案问题,以及对时间、版本或实体名称敏感的问题。
初版可以先准备 30~100 条人工确认样本。数量不是第一目标,覆盖故障模式更重要。每条样本都应来自真实需求或可信的产品定义,参考答案必须能够被相关文档直接支持,避免把模型猜测写成标准答案。
问题类型可以保持少而稳定,例如 fact、multi_hop、no_answer。后续看到新的失败模式时再扩展,不要一开始创建十几个含义重叠的标签。
用脚本生成并校验 JSONL
下面的 Python 示例把三条样本写入 rag_eval.jsonl,并在写入前检查必填字段、文档标识和问题类型。代码可直接运行,适合作为最小数据集构建脚本。
import json
from pathlib import Path

samples = [
    {
        "id": "q-001",
        "question": "退款申请提交后多久处理?",
        "reference_answer": "退款申请提交后会在 3 个工作日内完成审核。",
        "relevant_doc_ids": ["refund-policy-v2"],
        "question_type": "fact",
    },
    {
        "id": "q-002",
        "question": "企业版是否支持单点登录,如何启用?",
        "reference_answer": "企业版支持单点登录,需要管理员在组织设置中完成身份提供商配置。",
        "relevant_doc_ids": ["enterprise-features", "sso-setup"],
        "question_type": "multi_hop",
    },
    {
        "id": "q-003",
        "question": "你们是否支持线下现金退款?",
        "reference_answer": "现有文档未提供该能力说明,应返回无法从知识库确认。",
        "relevant_doc_ids": [],
        "question_type": "no_answer",
    },
]

required = {"id", "question", "reference_answer", "relevant_doc_ids", "question_type"}
allowed_types = {"fact", "multi_hop", "no_answer"}

for sample in samples:
    missing = required - sample.keys()
    if missing:
        raise ValueError(f"{sample.get('id', '<unknown>')} 缺少字段: {sorted(missing)}")
    if not isinstance(sample["relevant_doc_ids"], list):
        raise TypeError("relevant_doc_ids 必须是列表")
    if sample["question_type"] not in allowed_types:
        raise ValueError(f"未知 question_type: {sample['question_type']}")

output = Path("rag_eval.jsonl")
with output.open("w", encoding="utf-8") as f:
    for sample in samples:
        f.write(json.dumps(sample, ensure_ascii=False) + "\n")

print(f"validated={len(samples)} file={output}")
预期输出
validated=3 file=rag_eval.jsonl实际路径可能因运行目录不同而变化;示例中的文件名固定为 rag_eval.jsonl。
保证数据集能够长期复用
评测集一旦开始用于回归对比,就不要随意改写旧样本。更稳妥的做法是给数据集做版本管理:新增样本进入新版本,修正参考答案时保留变更记录,并记录对应知识库版本。
还要避免把待评测系统自己生成的答案直接当作参考答案,否则会把已有错误固化到评测集。对于 no_answer 样本,也不要强行指定一个知识库不存在的答案;它们的价值正是验证系统能否识别“没有足够证据”。
一份可用的评测数据集不追求庞大,而追求可解释、可复现、能覆盖失败模式。只要样本来源清楚、参考答案可验证、相关文档标注明确,就能成为后续检索与生成优化的稳定基线。