
大模型应用开发 / 系统课时
清洗文档内容
清洗文档内容
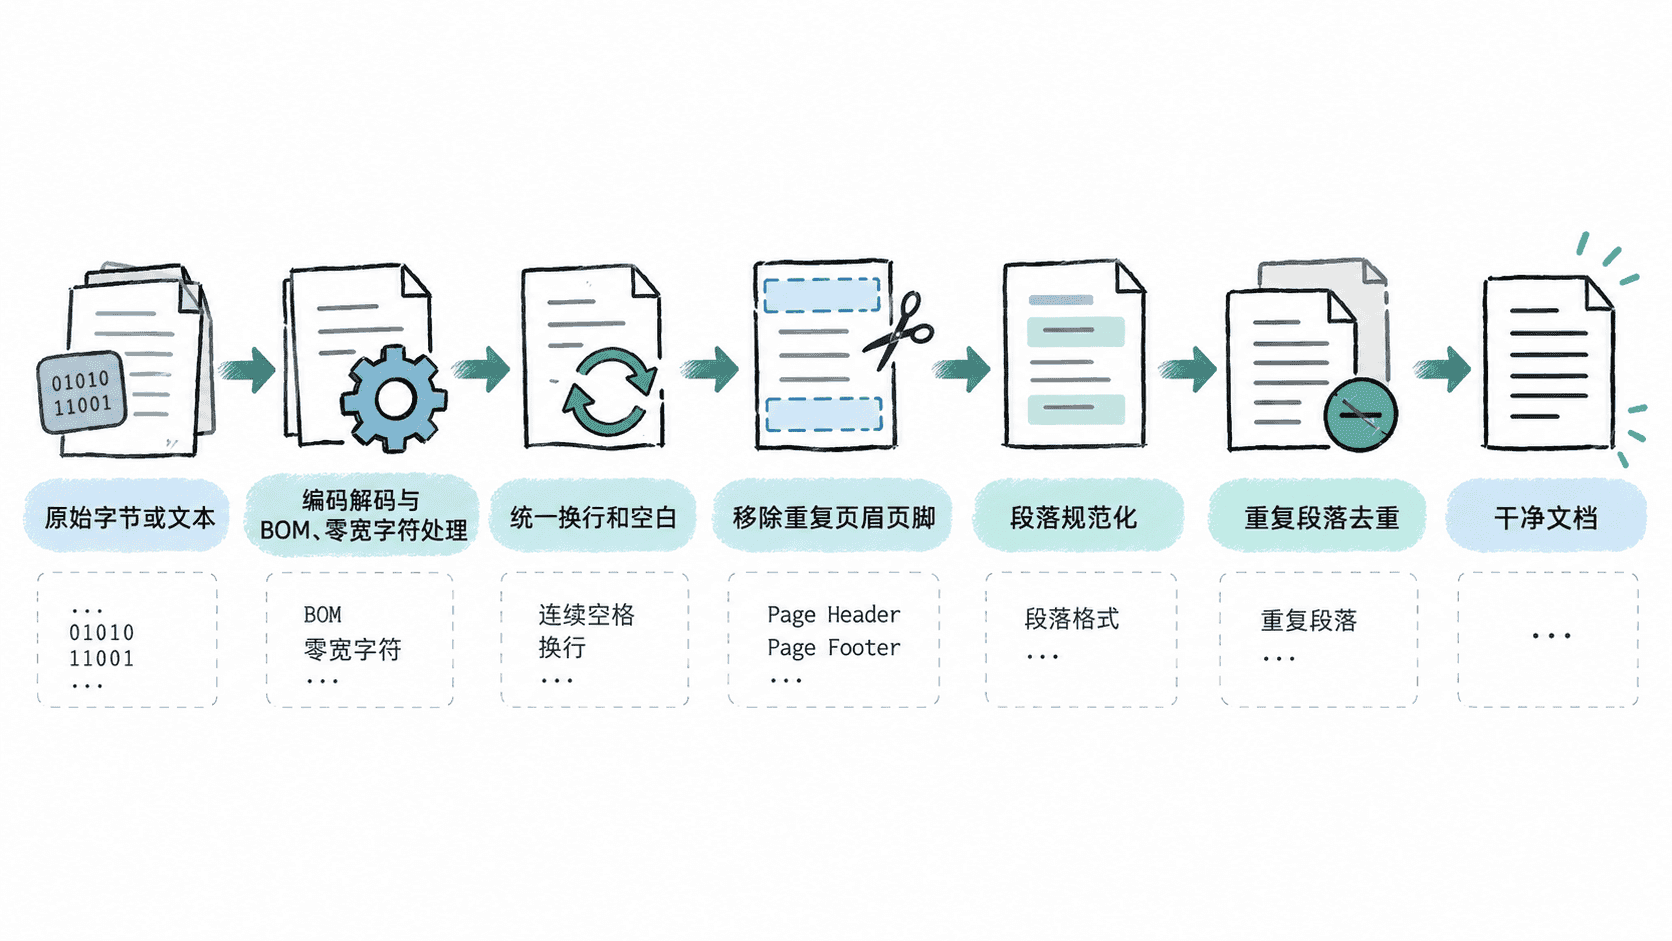
原始文档常混有 BOM、零宽字符、连续空白、重复页眉页脚和重复段落。这些噪声会被一起送进切分与向量化流程,降低检索质量。本节实现一条可复现的清洗流水线,把原始文本整理成边界稳定的知识正文。
学习目标
- 能按合理顺序处理编码、空白、页眉页脚和重复内容。
- 能用代码验证清洗前后的文本结果。
- 能识别过度清洗造成正文丢失的风险。
按稳定顺序处理噪声
清洗顺序会影响最终结果。通常先解决字节解码和不可见字符,再统一换行与空白,然后处理固定页眉页脚,最后按段落去重。若先去重,同一段文字可能因为 BOM、零宽字符或空格差异而被错误判断为不同内容。
实现最小清洗器
下面的 Python 示例处理 UTF-8 BOM、零宽字符、不同换行符、重复空白、固定页眉和完全重复的段落。页眉规则属于业务定制项,真实项目应根据文档来源配置,而不是删除所有短文本。
python
import re


HEADER_RE = re.compile(r"^内部知识库 - 第\d+页$", re.MULTILINE)


def decode_text(data: bytes) -> str:
    # utf-8-sig 在解码 UTF-8 时自动去掉 BOM。
    return data.decode("utf-8-sig")


def clean_text(text: str) -> str:
    text = text.replace("\u200b", "")
    text = text.replace("\r\n", "\n").replace("\r", "\n")
    text = HEADER_RE.sub("", text)

    normalized_lines = []
    for line in text.split("\n"):
        line = re.sub(r"[ \t]+", " ", line).strip()
        normalized_lines.append(line)

    normalized = "\n".join(normalized_lines)
    paragraphs = re.split(r"\n\s*\n", normalized)

    # 保留首次出现的有效段落,删除完全重复内容。
    seen = set()
    kept = []
    for paragraph in paragraphs:
        paragraph = re.sub(r"\s*\n\s*", " ", paragraph).strip()
        if paragraph and paragraph not in seen:
            seen.add(paragraph)
            kept.append(paragraph)

    return "\n\n".join(kept)


def main():
    raw = (
        "\ufeff内部知识库 - 第1页\n\n"
        "RAG\u200b   导入前要清洗文档。\n\n"
        "RAG   导入前要清洗文档。\n\n"
        "切分前保留有意义的段落边界。"
    ).encode("utf-8")

    print(clean_text(decode_text(raw)))


if __name__ == "__main__":
    main()
预期输出:
text
RAG 导入前要清洗文档。

切分前保留有意义的段落边界。
结果中 BOM、零宽字符、重复空白、页眉和重复段落都已经消失,而两个有效段落仍然保留。真实数据如果不是 UTF-8,应先根据来源确认编码,不要用忽略解码错误的方式静默丢弃字符。
清理格式残留但不要误删正文
PDF 转文本、网页复制和富文本导出常留下页码、导航词、按钮文案或格式符号残片。处理这些噪声时,优先使用可解释的稳定规则,例如删除固定页眉模板、固定页脚模板或明确的导航片段,不要使用过宽的正则表达式删除所有“看起来不像正文”的短行。
用差异判断清洗质量
清洗后可以检查字符数变化、空段落数量、重复段落数量,以及是否仍出现替换字符 �。如果文本长度突然下降很多,应先抽样比对原文;如果大量重复内容仍然存在,则继续定位页眉页脚模板或重复块来源,而不是直接进入切分。
清洗的目标不是让文本越短越好,而是让保留下来的每个段落都承载可检索信息,并拥有稳定、可信的段落边界,为后续切分和向量检索提供干净输入。
按自己的节奏,确认真正理解。