
大模型应用开发 / 系统课时
RAG 核心组件
RAG 核心组件
一套可工作的 RAG 并不是“向量库加大模型”这么简单。把文档加载、向量化、存储、召回、重排和生成拆开后,就能看清每一步的输入输出,也更容易定位质量和性能问题。
学习目标
- 说清文档加载器、嵌入模型、向量数据库、检索器、重排序器和生成模型的职责
- 区分离线索引链路与在线问答链路
- 根据异常现象判断应优先检查哪个组件
两条链路串起六个组件
RAG 通常分成离线索引和在线查询两条链路。索引阶段先由文档加载器读取原始资料,嵌入模型把文本转换为向量,向量数据库负责保存向量及其关联内容。查询阶段,检索器根据问题找出候选文档,重排序器再精排,最后生成模型结合问题与上下文组织答案。
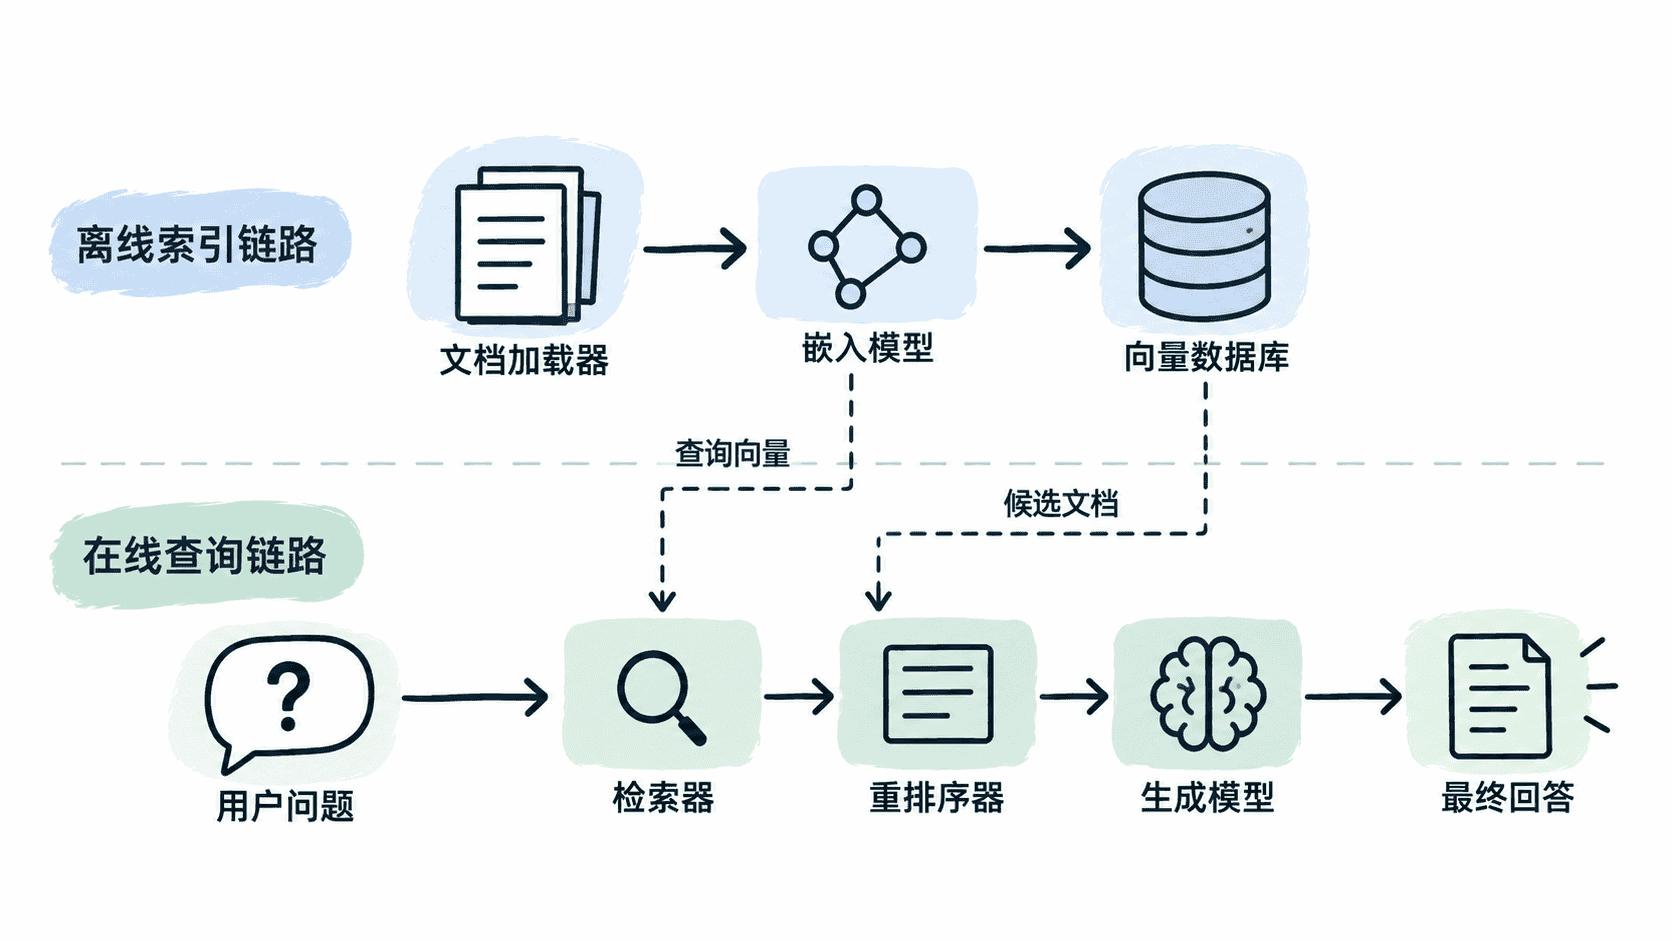
六个组件分别负责什么
| 组件 | 核心职责 | 主要输入 | 主要输出 |
|---|---|---|---|
| 文档加载器 | 把文件、网页或业务数据读成可处理文本 | 原始数据源 | 文本与元数据 |
| 嵌入模型 | 把文本映射到可比较的向量空间 | 文本或查询 | 向量 |
| 向量数据库 | 保存向量并支持相似度搜索与过滤 | 向量、文本、元数据 | 相似候选记录 |
| 检索器 | 组合查询向量、过滤条件和召回策略 | 用户问题 | 候选文档 |
| 重排序器 | 对候选文档做更精细的相关性排序 | 问题与候选文档 | 排序后的文档 |
| 生成模型 | 基于问题和检索上下文生成最终回答 | 问题、上下文 | 自然语言答案 |
向量数据库解决“怎么高效找相似内容”,检索器解决“这次查询具体怎么找”。两者经常被混为一谈,但前者更偏存储与搜索能力,后者负责把查询策略、过滤规则和召回参数组织起来。重排序器通常是可选层,候选集较大或相似度排序不够稳定时才更有价值。
用最小代码理解调用顺序
下面的 Python 示例不依赖第三方库,用关键词集合模拟“嵌入向量”,用内存列表模拟“向量数据库”。它不能替代真实向量检索,但可以完整展示六类职责在一次查询中的先后关系。
python
def load_documents():
    # 加载器输出文本与元数据;真实项目可来自 PDF、网页或数据库。
    return [
        {"id": "doc-1", "text": "RAG 使用检索结果补充生成上下文"},
        {"id": "doc-2", "text": "向量数据库负责保存向量并支持检索"},
        {"id": "doc-3", "text": "生成模型根据上下文组织最终回答"},
    ]

def embed(text):
    keywords = ("RAG", "检索", "向量", "生成")
    return {keyword for keyword in keywords if keyword in text}

def retrieve(query_vector, vector_db, top_k=2):
    # 真实系统通常使用余弦相似度或其他向量距离,并可叠加元数据过滤。
    return sorted(
        vector_db,
        key=lambda item: len(query_vector & item["vector"]),
        reverse=True,
    )[:top_k]

def rerank(query, candidates):
    return sorted(
        candidates,
        key=lambda item: ("RAG" in item["text"], "检索" in item["text"]),
        reverse=True,
    )

def generate(query, contexts):
    return f"回答基于:{contexts[0]['text']}"

def main():
    documents = load_documents()
    vector_db = [{**doc, "vector": embed(doc["text"])} for doc in documents]
    query = "RAG 检索"
    candidates = retrieve(embed(query), vector_db)
    ranked = rerank(query, candidates)
    answer = generate(query, ranked)
    print("候选文档:", [item["id"] for item in candidates])
    print("重排结果:", [item["id"] for item in ranked])
    print(answer)

if __name__ == "__main__":
    main()
预期输出
text
候选文档: ['doc-1', 'doc-2']
重排结果: ['doc-1', 'doc-2']
回答基于:RAG 使用检索结果补充生成上下文
组件边界决定排查顺序
如果“相关资料根本没被召回”,先检查加载内容是否完整、嵌入是否一致、向量库是否写入成功,以及检索器的过滤和召回参数。如果候选文档基本正确但顺序差,再看是否需要重排序器;如果上下文已经正确而答案仍偏题,则应优先检查生成模型的提示词、上下文拼接和回答约束。
真正可维护的 RAG 不是把组件绑死,而是让每一层都有明确输入、输出和可替换边界。这样更换模型、向量库或检索策略时,不必重写整条链路。
按自己的节奏,确认真正理解。