
大模型应用开发 / 系统课时
按文档结构切分
按文档结构切分
Markdown 文档已经包含标题层级、表格和代码块等显式结构,继续只按字符数切分会丢掉这些边界。本节会把标题路径保留为片段元数据,并确保表格和围栏代码块不会被标题扫描器误拆,从而得到可直接用于索引的结构化片段。
学习目标
- 根据 Markdown 标题层级生成带章节路径的片段。
- 识别表格与围栏代码块等不应随意拆开的内容边界。
- 用 Python 生成结构化片段并验证标题、表格和代码块归属。
先保留文档的语义骨架
结构化切分最重要的不是“每块一样长”,而是让检索结果知道内容来自哪里。遇到 #、##、### 标题时,可以维护一个标题路径,例如“接口文档 / 请求参数”,并把它作为片段元数据一起写入向量库。
表格和代码块则属于原子内容。表格被从中间切开后,列名与数据行可能失去对应关系;代码块被切开后,语法上下文也可能失效。因此应先识别这些边界,再考虑长度限制。
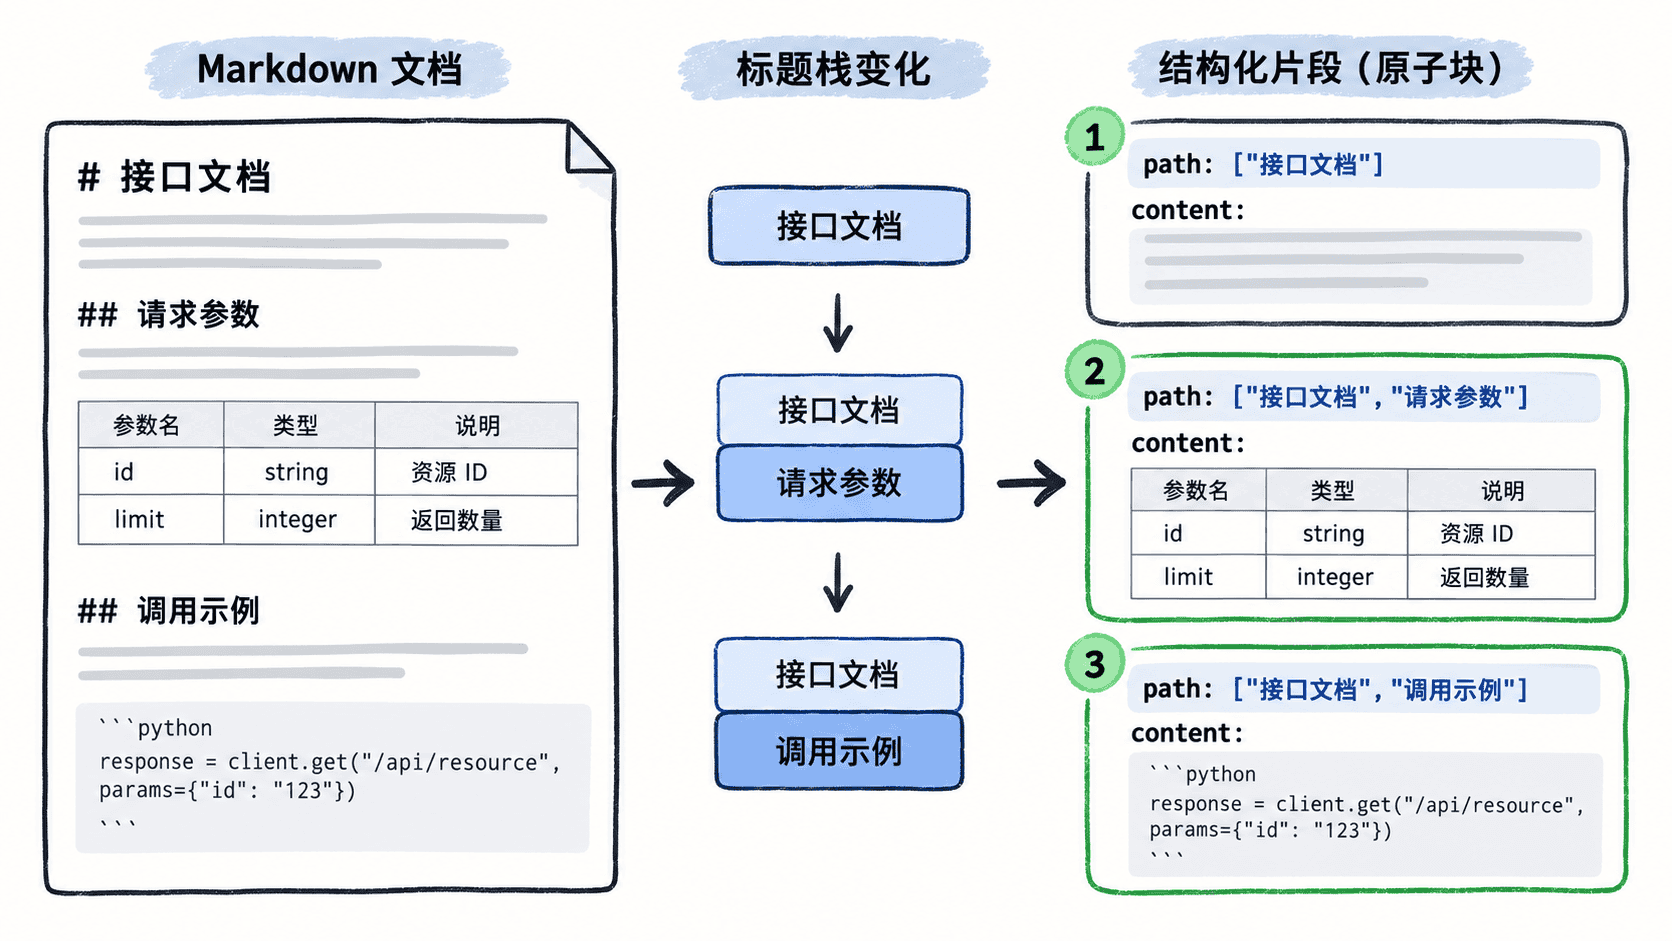
定义可拆与不可拆边界
标题用于切换当前章节路径,通常在新标题出现前结束上一片段。普通段落可以在后续二次切分时继续按长度处理,但表格和围栏代码块最好整体保留。
处理 Markdown 时还要特别注意代码围栏内部的 #。例如 Shell 注释或 Markdown 示例中的 ## 都不是真正的文档标题,所以解析器必须先判断自己是否位于围栏代码块内部,再决定是否执行标题匹配。
用 Python 生成结构化片段
下面的最小实现把一到三级标题转换为 path,同时在代码围栏内暂停标题识别,并把连续 Markdown 表格行留在当前片段中。示例重点是结构边界,不额外引入字符长度二次切分。
python
import re

HEADING = re.compile(r"^(#{1,3})\s+(.+)$")
FENCE = chr(96) * 3

def split_markdown(md: str) -> list[dict[str, str]]:
    chunks: list[dict[str, str]] = []
    path: list[str] = []
    current_path: list[str] = []
    current_lines: list[str] = []

    def flush() -> None:
        nonlocal current_lines

        content = "\n".join(current_lines).strip()
        if content:
            chunks.append(
                {
                    "path": " / ".join(current_path),
                    "content": content,
                }
            )
        current_lines = []

    lines = md.splitlines()
    i = 0
    in_fence = False

    while i < len(lines):
        line = lines[i]

        if line.startswith(FENCE):
            in_fence = not in_fence
            current_lines.append(line)
            i += 1
            continue

        if not in_fence:
            match = HEADING.match(line)
            if match:
                flush()

                level = len(match.group(1))
                title = match.group(2).strip()
                path = path[: level - 1] + [title]
                current_path = path.copy()

                i += 1
                continue

            # 表头下一行是分隔行时,把整张表作为同一内容块读取。
            is_table = (
                "|" in line
                and i + 1 < len(lines)
                and re.match(
                    r"^\s*\|?[\s:-]+\|[\s|:-]*$",
                    lines[i + 1],
                )
                is not None
            )

            if is_table:
                while i < len(lines) and "|" in lines[i]:
                    current_lines.append(lines[i])
                    i += 1
                continue

        current_lines.append(line)
        i += 1

    flush()
    return chunks

sample = (
    "# 接口文档\n"
    "这是检索接口的说明。\n\n"
    "## 请求参数\n"
    "| 参数 | 说明 |\n"
    "| --- | --- |\n"
    "| top_k | 返回片段数 |\n\n"
    "## 调用示例\n"
    f"{FENCE}python\n"
    'result = search("RAG", top_k=3)\n'
    "print(result)\n"
    f"{FENCE}\n\n"
    "调用结果用于后续生成答案。"
)

for item in split_markdown(sample):
    content = item["content"]
    print(
        f'{item["path"]} | '
        f'table={"| top_k |" in content} | '
        f'code={"result = search" in content}'
    )
预期输出:
text
接口文档 | table=False | code=False
接口文档 / 请求参数 | table=True | code=False
接口文档 / 调用示例 | table=False | code=True
给结构片段补上长度约束
真实文档中,一个标题下仍可能有几千字。更稳妥的策略是先按结构得到章节片段,再只对超长的普通段落做二次递归切分;表格和代码块继续作为原子块保留。这样“结构边界”拥有比“长度均匀”更高的优先级。
写入向量库时,至少保留标题路径和正文内容;如果上游还能提供文件名、原始 URL 或页码,也应一并作为元数据保存。检索返回片段后,这些字段既能帮助重排,也能让最终答案引用到更准确的来源位置。
按自己的节奏,确认真正理解。