
大模型应用开发 / 系统课时
按语义边界切分
按语义边界切分
固定字符数切分容易把一个完整主题拦腰截断。语义边界切分把相邻句子的语义变化当成分界信号,让每个片段更接近一个自然主题单元,尤其适合标题层级缺失、段落结构混乱的长文本。
学习目标
- 理解如何用相邻句子的语义相似度识别主题切换
- 能根据阈值把连续句子聚合为语义片段
- 知道阈值、最小片段长度与最大片段长度如何共同约束切分结果
用语义变化代替固定长度
语义切分的核心不是“每隔多少字切一次”,而是先把文本拆成句子,再比较相邻句子的语义相似度。相似度持续较高时,句子通常属于同一主题;当相似度突然跌破阈值时,就把该位置视为候选边界。
常见做法是先用嵌入模型把句子映射成向量,再计算余弦相似度。若相邻句子向量分别为 与 ,则可用余弦相似度衡量方向接近程度;得分越低,越值得考虑切分。
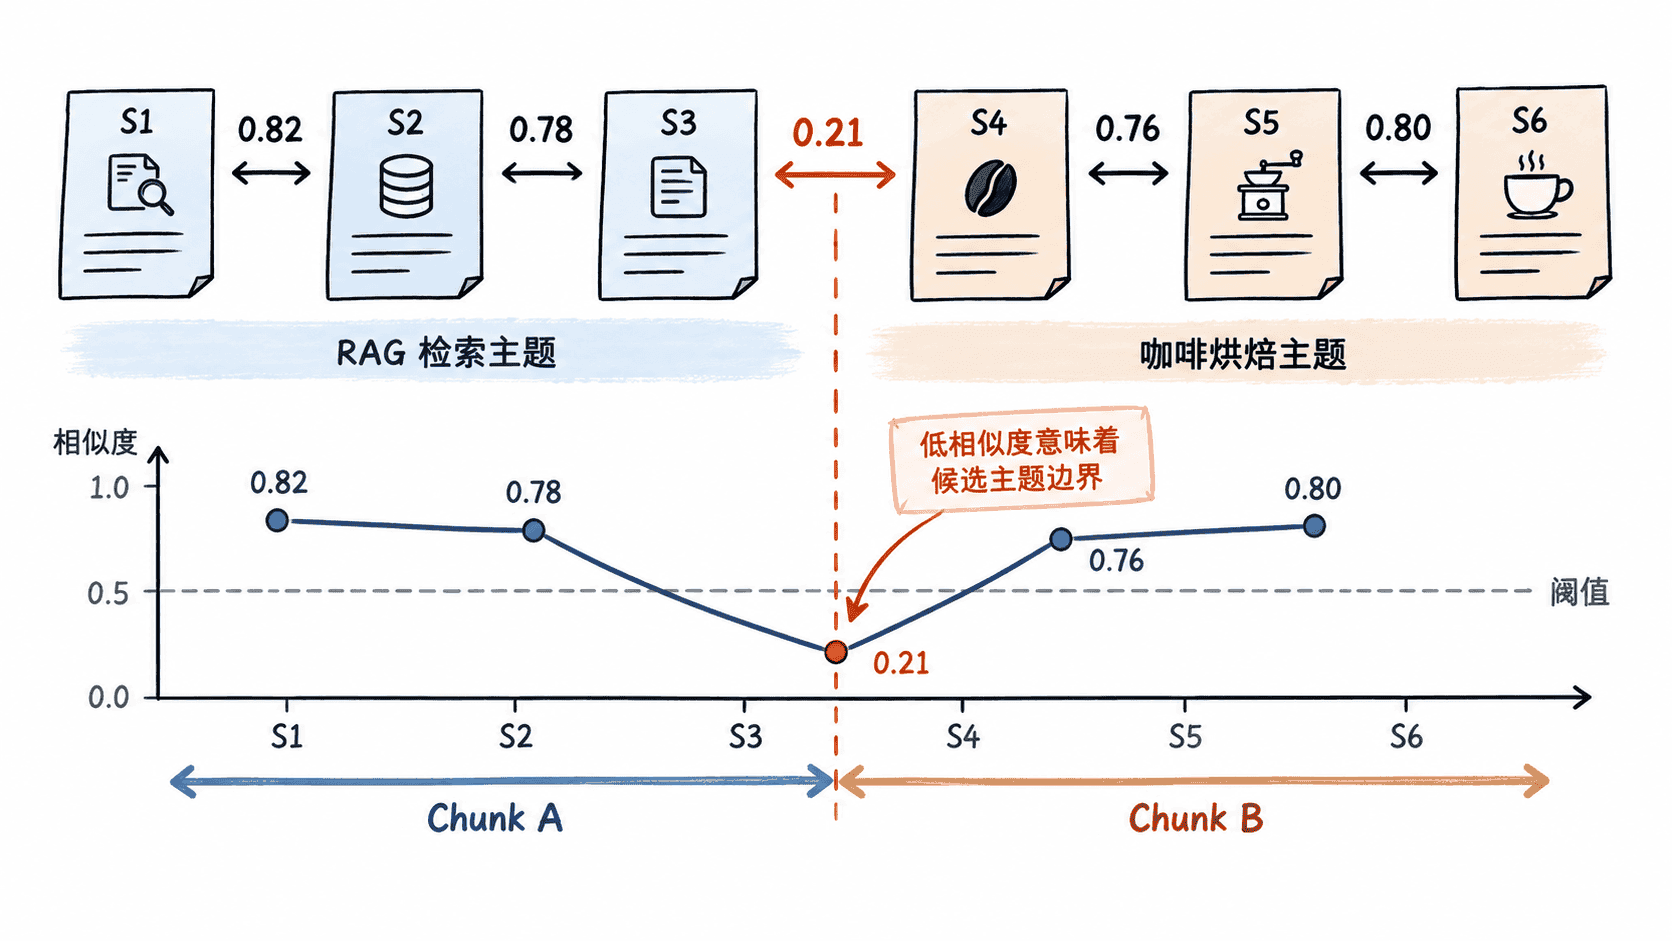
用阈值生成语义片段
下面把“相邻语义相似度”作为输入,演示最小切分逻辑。示例中的分数可以理解为嵌入模型计算后的结果;真正接入模型时,只需替换分数来源,边界判定过程保持不变。
sentences = [
    "用户提交问题后,系统先检索相关文档。",
    "检索器会返回与问题最相关的若干片段。",
    "这些片段随后与问题一起交给生成模型。",
    "咖啡豆的烘焙程度会影响酸度与苦味。",
    "浅烘焙通常保留更多果酸与花香。",
]

similarities = [0.86, 0.81, 0.18, 0.77]

def split_by_similarity(sentences, similarities, threshold=0.45):
    if len(similarities) != len(sentences) - 1:
        raise ValueError("相似度数量必须比句子数量少 1")

    chunks = []
    current = [sentences[0]]

    for i, score in enumerate(similarities):
        if score < threshold:
            chunks.append("".join(current))
            current = [sentences[i + 1]]
        else:
            current.append(sentences[i + 1])

    chunks.append("".join(current))
    return chunks

for index, chunk in enumerate(split_by_similarity(sentences, similarities), 1):
    print(f"chunk {index}: {chunk}")
预期输出
chunk 1: 用户提交问题后,系统先检索相关文档。检索器会返回与问题最相关的若干片段。这些片段随后与问题一起交给生成模型。
chunk 2: 咖啡豆的烘焙程度会影响酸度与苦味。浅烘焙通常保留更多果酸与花香。
这里真正决定边界的是第三个相似度 0.18。它低于阈值 0.45,因此系统在第三句与第四句之间切开;其他位置保持连续,最终得到两个主题内部相对一致的片段。
给语义边界加长度约束
只看语义变化仍可能产生极短片段或超长片段。工程上通常还要设置最小长度和最大长度:太短的片段向相邻主题合并,太长的片段即使没有明显主题突变,也需要在较弱边界或句子边界处强制拆分。
阈值也不宜直接照搬别人的数值。不同嵌入模型、领域语料和句子粒度会改变相似度分布,较稳妥的做法是先抽样一批真实文档,观察明显同主题与明显跨主题的分数区间,再选一个能把两类情况尽量分开的阈值。
什么时候值得使用
语义边界切分最适合结构弱、主题会在正文中自然切换的材料,例如访谈记录、会议纪要、长篇说明和抓取后的网页正文。若文档本身已经有稳定标题层级、章节编号或明确字段,优先利用这些结构信号通常更便宜,也更容易解释和调试。
在 RAG 中,最终目标不是让每个片段长度完全一致,而是让一次检索命中后,片段内部尽量围绕同一个知识点展开。语义边界只是候选切点,还应结合长度、重叠和实际检索效果一起调参。