
大模型应用开发 / 系统课时
加载本地文件
加载本地文件
本节完成一个统一的本地知识加载入口:把文本、Markdown、PDF、Word 与表格文件转换成可继续切分和向量化的文档对象,同时保留原始文件路径、文件类型以及页码或工作表等来源信息。
学习目标
- 为常见本地文件选择合适的读取方式,并统一成同一种文档结构。
- 在正文之外保存
source、文件类型、页码或工作表等可追溯元数据。 - 识别空文件、扫描版 PDF 和表格结构丢失等常见边界。
统一文档结构
RAG 后续的切分器和向量库不应该关心输入最初是 PDF 还是 Word。更稳妥的做法,是在加载阶段统一成“文本内容 + 元数据”的结构。正文负责承载可检索内容,元数据负责回答“这段内容来自哪里”。
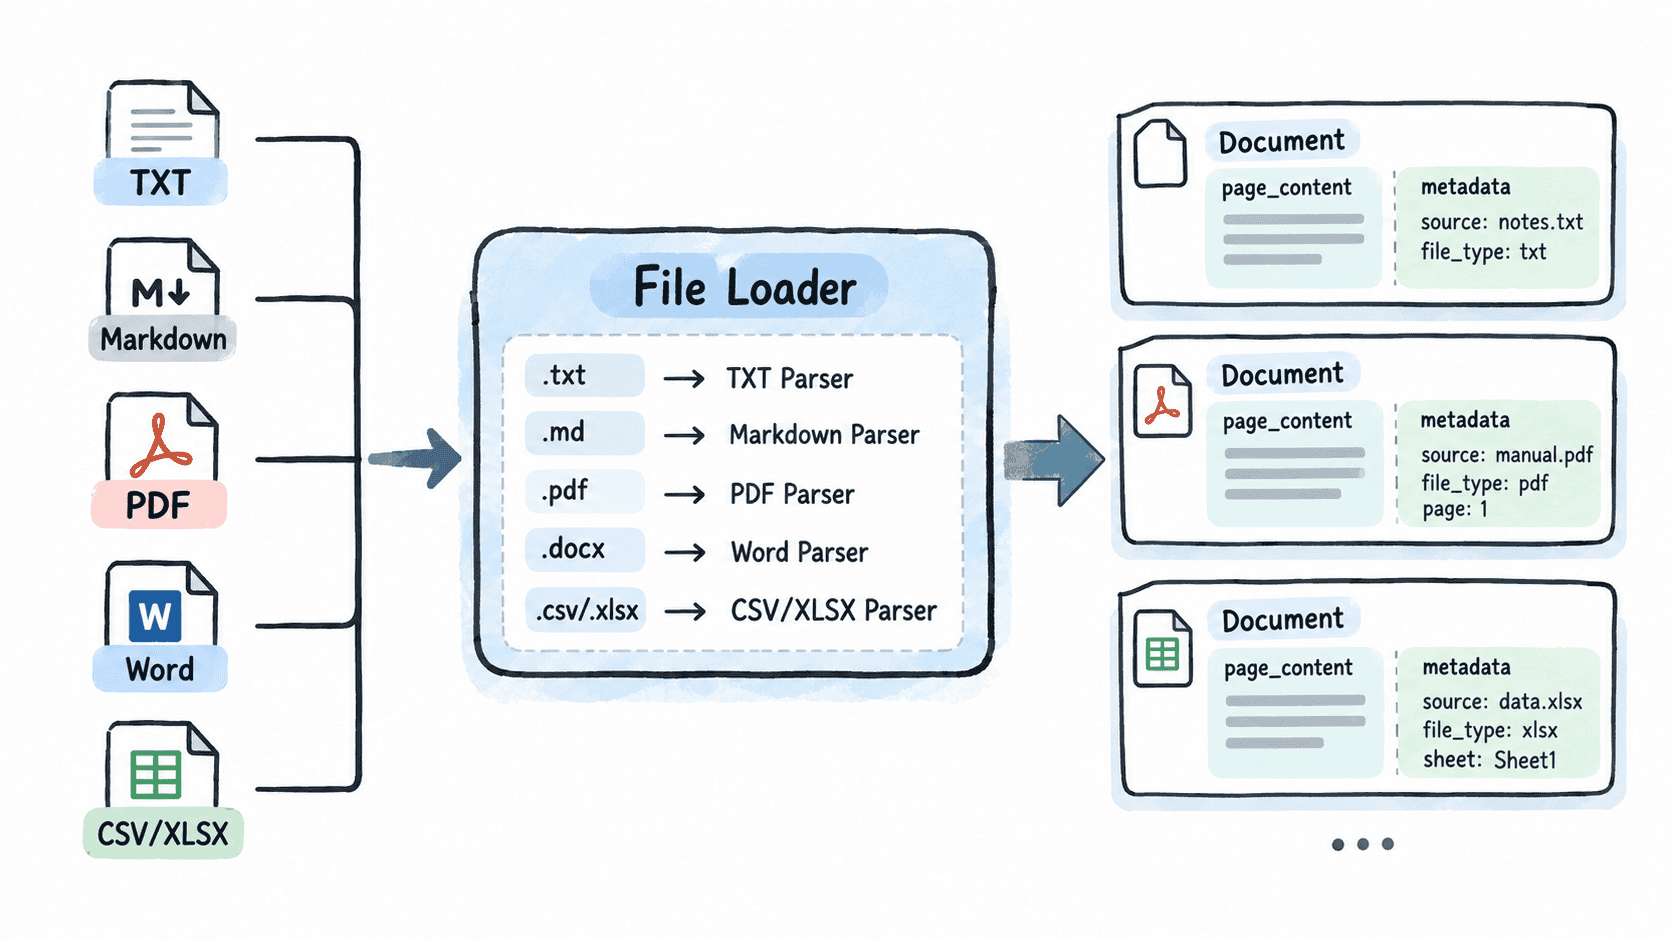
下面的主示例用一个 load_file 函数统一处理五类文件。运行前准备 Python 3.11+,并安装 pypdf、python-docx、pandas、openpyxl。把待导入的受支持文件放在 knowledge/ 目录后执行。
from pathlib import Path
import json

import pandas as pd
from docx import Document as WordDocument
from pypdf import PdfReader


def make_doc(text: str, source: Path, **meta):
    # 正文与来源元数据分离,便于后续切分时继续传递 metadata。
    return {
        "page_content": text.strip(),
        "metadata": {
            "source": str(source),
            "file_type": source.suffix.lower(),
            **meta,
        },
    }


def load_file(path: Path):
    ext = path.suffix.lower()

    if ext in {".txt", ".md"}:
        return [make_doc(path.read_text(encoding="utf-8"), path)]

    if ext == ".pdf":
        docs = []
        for index, page in enumerate(PdfReader(path).pages):
            text = page.extract_text() or ""
            if text.strip():
                docs.append(make_doc(text, path, page=index + 1))
        return docs

    if ext == ".docx":
        doc = WordDocument(path)
        text = "\n".join(p.text for p in doc.paragraphs if p.text.strip())
        return [make_doc(text, path)]

    if ext in {".csv", ".xlsx"}:
        sheets = {"Sheet1": pd.read_csv(path)} if ext == ".csv" else pd.read_excel(path, sheet_name=None)
        return [
            make_doc(df.to_json(orient="records", force_ascii=False), path, sheet=sheet)
            for sheet, df in sheets.items()
        ]

    raise ValueError(f"Unsupported file type: {ext}")


all_docs = []
for file_path in sorted(Path("knowledge").iterdir()):
    if file_path.is_file():
        all_docs.extend(load_file(file_path))

for doc in all_docs:
    print(json.dumps(doc["metadata"], ensure_ascii=False))
预期结果:每条输出都至少包含真实来源路径和文件类型;PDF 文档会额外包含页码,CSV 或 Excel 文档会包含工作表名。实际文件名、页数和输出行数取决于 knowledge/ 中的数据。
{"source": "knowledge/<PATH>", "file_type": "<VALUE>"}
{"source": "knowledge/<PATH>", "file_type": ".pdf", "page": <VALUE>}
{"source": "knowledge/<PATH>", "file_type": ".xlsx", "sheet": "<VALUE>"}
保留来源而不是写进正文
不要把“来源:xxx.pdf”拼进 page_content。来源字符串会参与向量化并污染正文语义,而且生成引用时还需要再次解析。把路径、页码和工作表保存在 metadata,后续切分时将这些字段复制给每个 chunk,就能从召回结果直接定位原文件。
对于 CSV 或 Excel,示例把整张表转换成 JSON 文本只是最小实现。真实知识库通常应按行、业务实体或小批记录拆成更小文档,并保留列名;否则一张大表会形成超长文本,既难切分,也会降低检索命中具体记录的能力。
处理常见文件边界
文本和 Markdown 应优先统一为 UTF-8;历史文件使用其他编码时,应在导入前显式转换。PDF 的文本提取依赖文件中的文本层,扫描版 PDF 往往需要额外 OCR,否则加载结果可能为空。
Word 文档还可能包含表格、页眉和文本框;这些区域对知识有价值时,需要扩展解析逻辑。表格文件则要关注合并单元格、公式结果和空值,因为这些结构信息往往比扩展名更影响最终文本质量。
加载完成后先抽查 page_content 是否可读,再确认 metadata.source 能定位回原文件。只有内容可以稳定检索、结果可以追溯来源,这批本地文件才适合进入后续切分与向量化流程。