
大模型应用开发 / 系统课时
控制知识访问权限
控制知识访问权限
RAG 的权限边界必须在检索阶段生效,而不是等模型生成答案后再“删掉不该看的内容”。本课把用户、组织、角色和文档 ACL 转换为可验证的过滤条件,并用最小示例完成租户隔离与文档级授权。
学习目标
- 将用户身份与组织信息映射为检索过滤条件
- 在向量检索前同时执行租户隔离和文档 ACL 校验
- 用拒绝场景验证不会发生跨租户知识泄露
把授权放在检索之前
安全的 RAG 请求链路至少涉及用户、身份上下文、检索器、知识库和模型五个对象。核心原则只有一个:模型只能看到调用者原本就有权读取的文档。如果先检索全部文档、再让模型忽略敏感内容,敏感文本已经进入上下文,日志、缓存或模型响应都可能泄露信息。
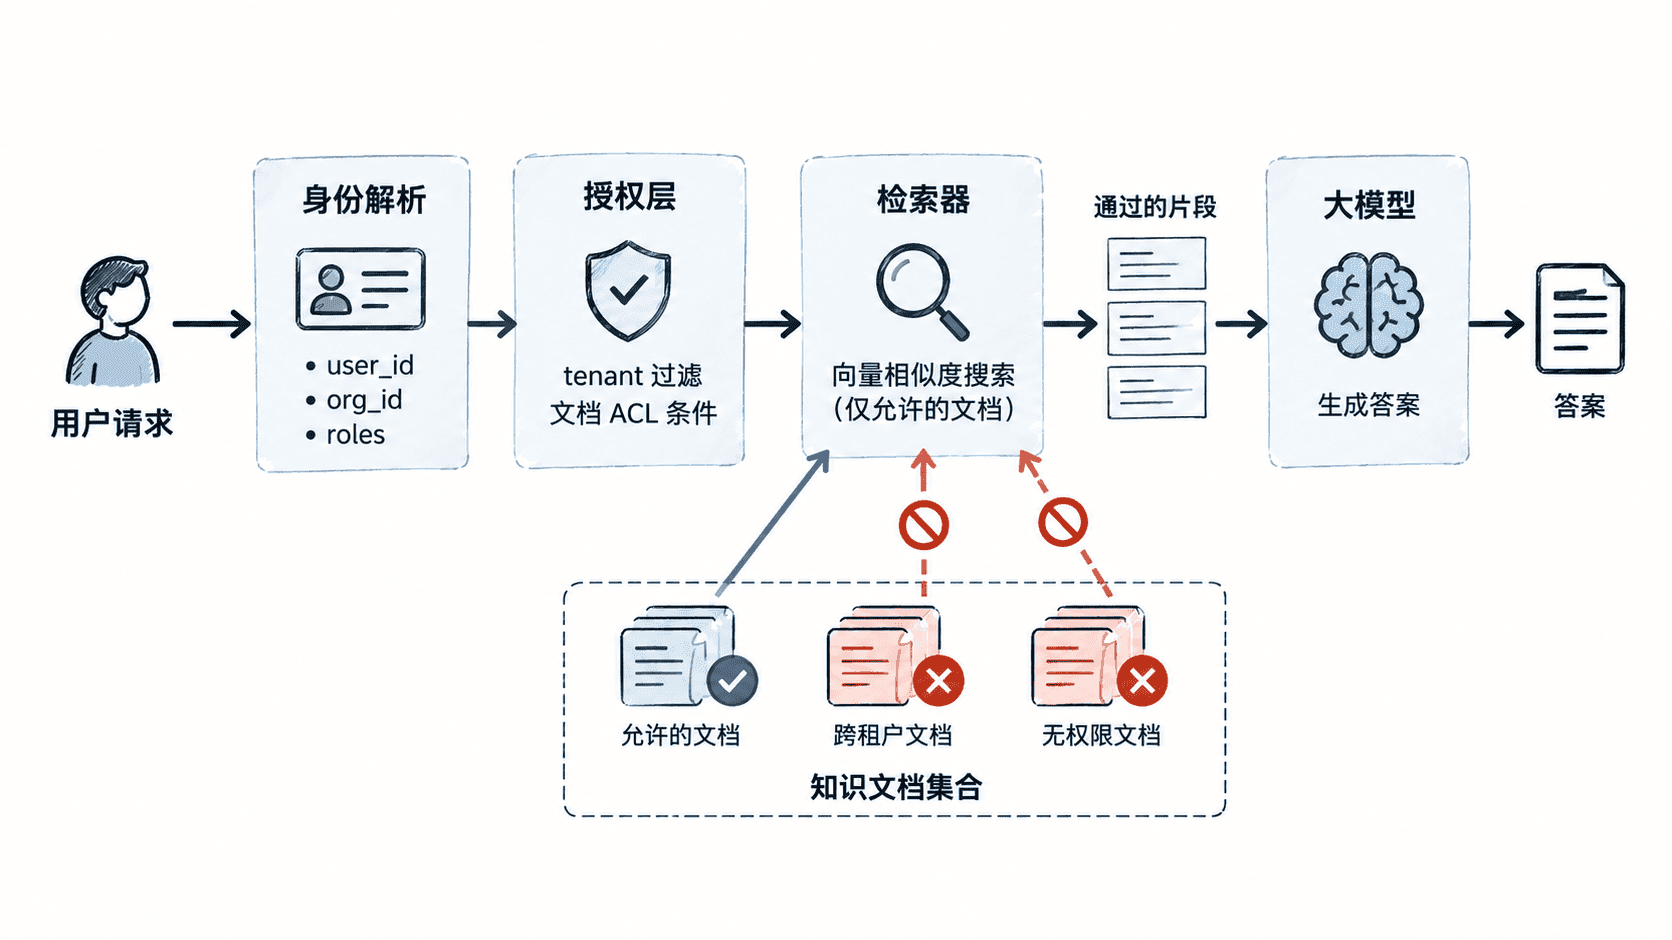
权限过滤通常分两层。第一层是租户边界,例如 org_id 必须与当前登录用户所属组织一致;第二层是文档 ACL,例如文档允许某个用户、角色或公开范围访问。两层应取交集,而不是二选一。
将身份转换为过滤条件
下面用一个内存知识库演示完整过滤逻辑。示例先按 org_id 做硬隔离,再判断文档是否公开、直接授权给用户,或授权给用户所持角色。真实向量数据库可把同样条件转换为 metadata filter、SQL WHERE 或搜索引擎布尔过滤。
from dataclasses import dataclass
from typing import FrozenSet, Iterable

@dataclass(frozen=True)
class Identity:
    user_id: str
    org_id: str
    roles: FrozenSet[str]

@dataclass(frozen=True)
class Document:
    doc_id: str
    org_id: str
    visibility: str
    allowed_users: FrozenSet[str]
    allowed_roles: FrozenSet[str]
    text: str

def can_read(identity: Identity, doc: Document) -> bool:
    # 租户边界是硬条件,任何 ACL 都不能跨越它。
    if doc.org_id != identity.org_id:
        return False
    if doc.visibility == "org":
        return True
    if identity.user_id in doc.allowed_users:
        return True
    return bool(identity.roles & doc.allowed_roles)

def retrieve(identity: Identity, docs: Iterable[Document], query: str) -> list[Document]:
    # 教学示例用关键词命中代替向量相似度,重点放在授权顺序。
    candidates = [doc for doc in docs if can_read(identity, doc)]
    return [doc for doc in candidates if query.lower() in doc.text.lower()]

def main() -> None:
    docs = [
        Document("doc-1", "org-a", "org", frozenset(), frozenset(), "退款流程:提交工单"),
        Document("doc-2", "org-a", "restricted", frozenset(), frozenset({"finance"}), "财务预算:退款准备金"),
        Document("doc-3", "org-b", "org", frozenset(), frozenset(), "退款流程:VIP 规则"),
    ]
    identity = Identity("user-7", "org-a", frozenset({"support"}))
    print([doc.doc_id for doc in retrieve(identity, docs, "退款")])

if __name__ == "__main__":
    main()
预期输出
['doc-1']结果中没有 doc-2,因为当前用户不具备 finance 角色;也没有 doc-3,因为它属于其他组织。真实检索系统即使使用向量相似度,也应先把这两个对象排除,或在数据库查询中用等价过滤条件保证它们不可能成为候选。
在检索器中固化权限约束
权限条件不应散落在 Prompt、业务控制器和前端里,而应封装到检索层。一个常见做法是由授权服务产生规范化过滤对象,例如只包含 org_id、当前用户 ID 和允许角色,再由具体向量库适配器翻译为数据库语法。
如果后端支持 metadata filter,可以构造类似“org_id = 当前组织 AND (visibility = org OR allowed_user 包含当前用户 OR allowed_role 与当前角色相交)”的逻辑。若底层数据库无法安全表达数组交集,宁可先维护一张规范化 ACL 关系表,也不要把全部候选拉回应用层后过滤,因为这会扩大敏感数据暴露面并浪费检索资源。
验证拒绝路径
只验证“有权限时能搜到”不够,至少还要覆盖三种负向测试:同组织但角色不足、用户被撤销直接授权、跨组织访问。测试时观察的不是模型措辞,而是未经授权的文档是否完全没有进入检索结果和模型上下文。
生产日志建议记录请求主体、授权过滤摘要、命中文档 ID 和拒绝原因,但不要记录敏感正文。这样既能追踪越权尝试,也能在权限变更后审计“谁在什么时间检索过哪些知识”。
当租户隔离、ACL 判断和检索过滤都在模型之前完成后,模型就不再承担安全边界职责。即使后续 Prompt 被诱导“输出所有隐藏资料”,它也只能基于已经授权的上下文回答,这才是可验证的 RAG 访问控制。