
大模型应用开发 / 系统课时
输出结构化结果
输出结构化结果
RAG 答案进入接口、缓存或工作流后,最怕模型偶尔多一句解释、漏字段或返回半截 JSON。本节用固定输出契约、解析校验和有限修复,把模型文本变成可稳定消费的结构化结果。
学习目标
- 为答案、引用和置信度定义稳定的 JSON 输出契约。
- 区分 JSON 解析错误、字段校验错误和 RAG 语义错误。
- 只修复可确定的格式问题,并为不可修复结果设计失败路径。
先固定输出契约
结构化输出的第一步不是“让模型尽量输出 JSON”,而是先定义消费者真正接受的字段、类型和边界。若模型接口支持原生结构化输出或 JSON Schema,应优先把约束交给接口层;提示词仍负责解释字段语义,例如引用只能使用本次检索到的片段编号。
{
  "type": "object",
  "required": ["answer", "citations", "confidence"],
  "properties": {
    "answer": {"type": "string", "minLength": 1},
    "citations": {"type": "array", "items": {"type": "string"}},
    "confidence": {"type": "number", "minimum": 0, "maximum": 1}
  },
  "additionalProperties": false
}
这个结构要求返回值只包含三个字段:自然语言答案、引用 ID 列表和 0~1 的置信度。验证时既要检查 JSON 是否能解析,也要检查字段类型、范围和额外字段;只通过“能被 json.loads 读取”还不够。
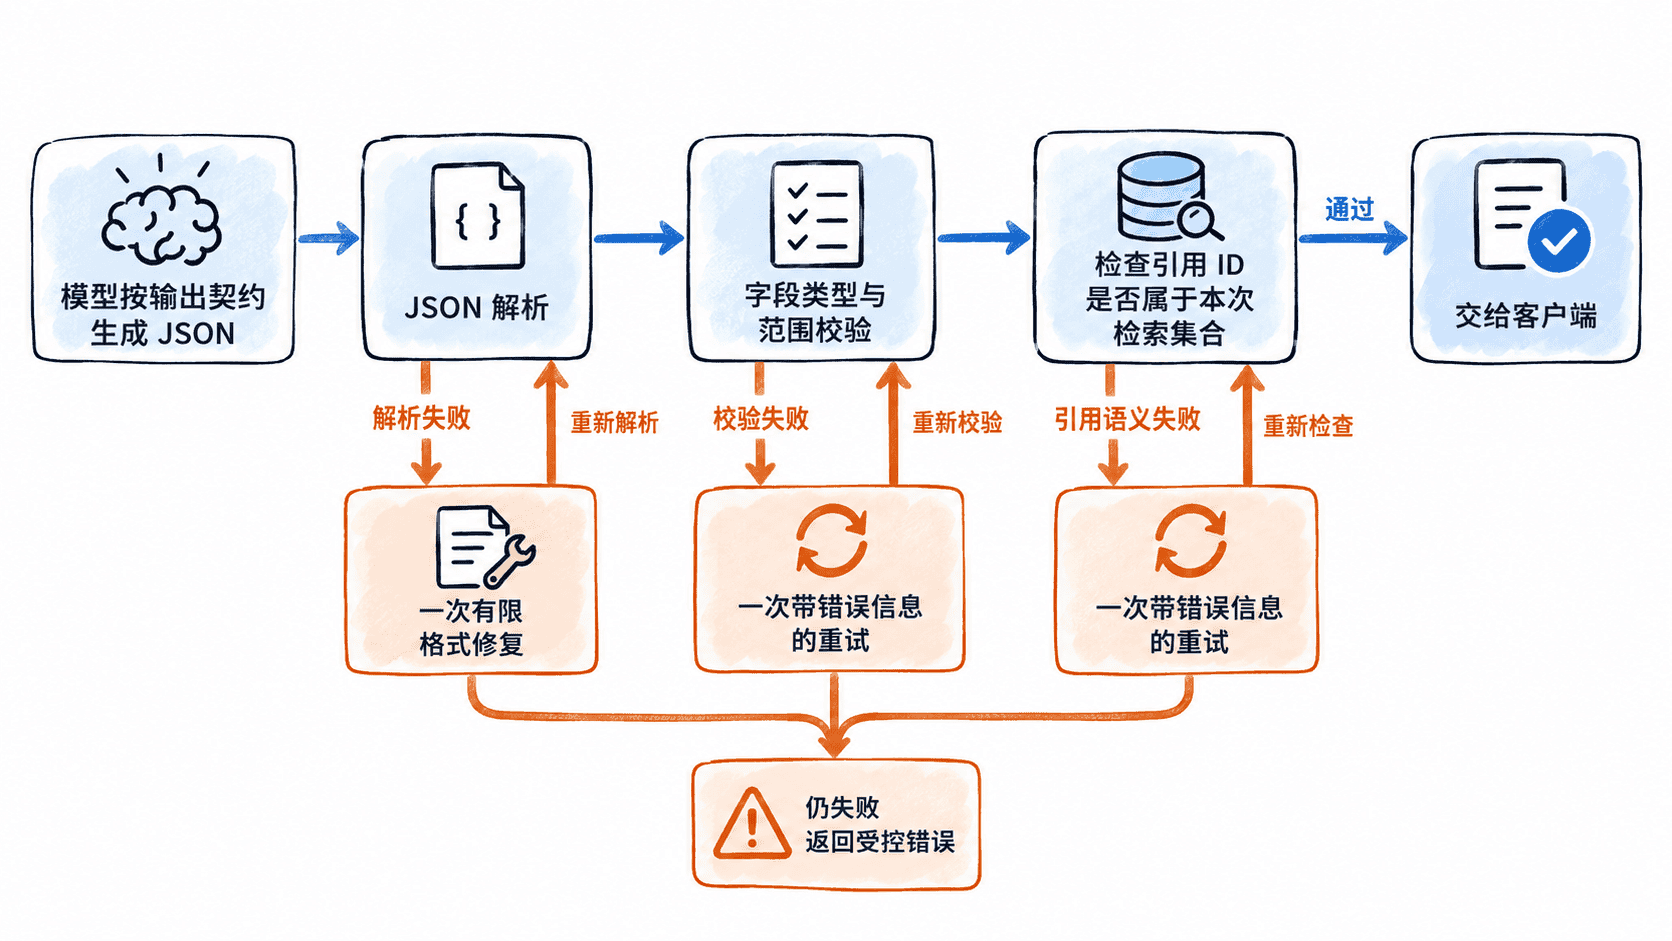
解析和字段校验要分层
下面的完整 Python 示例模拟模型返回带代码围栏和尾随逗号的 JSON。程序先做有限格式修复,再解析并校验字段,最后额外验证引用 ID 必须来自本次检索结果。
import json
import re
from typing import Any

REQUIRED_FIELDS = {"answer", "citations", "confidence"}

def repair_json_text(raw: str) -> str:
    text = raw.strip()
    # 只移除常见代码围栏,不猜测缺失字段或字段语义。
    fence = chr(96) * 3
    if text.startswith(fence):
        lines = text.splitlines()[1:]
        if lines and lines[-1].strip() == fence:
            lines = lines[:-1]
        text = "\n".join(lines).strip()
    return re.sub(r",\s*([}\]])", r"\1", text)

def validate(payload: Any, allowed_citations: set[str]) -> dict:
    if not isinstance(payload, dict) or set(payload) != REQUIRED_FIELDS:
        raise ValueError("fields do not match schema")
    if not isinstance(payload["answer"], str) or not payload["answer"].strip():
        raise ValueError("answer must be a non-empty string")
    if not isinstance(payload["citations"], list):
        raise ValueError("citations must be a list")
    if any(not isinstance(item, str) or not item for item in payload["citations"]):
        raise ValueError("citation ids must be non-empty strings")
    if not set(payload["citations"]).issubset(allowed_citations):
        raise ValueError("citation id is outside retrieved context")

    confidence = payload["confidence"]
    if isinstance(confidence, bool) or not isinstance(confidence, (int, float)):
        raise ValueError("confidence must be numeric")
    if not 0 <= confidence <= 1:
        raise ValueError("confidence must be between 0 and 1")
    return payload

raw = '{"answer":"根据检索片段,退款窗口为 7 天。","citations":["doc-17"],"confidence":0.86,}'

cleaned = repair_json_text(raw)
result = validate(json.loads(cleaned), {"doc-17", "doc-23"})
print(json.dumps(result, ensure_ascii=False, sort_keys=True))
预期输出
{"answer": "根据检索片段,退款窗口为 7 天。", "citations": ["doc-17"], "confidence": 0.86}这里把“格式可恢复”和“语义可接受”拆成两层。即使 JSON 语法正确,只要引用了未检索到的 doc-99,也必须判定失败,避免模型凭空制造引用。
修复只处理可确定错误
自动修复适合处理代码围栏、尾随逗号这类规则明确且不会改变业务含义的问题。缺字段、字段类型错误、引用不存在或答案为空时,不应在服务端自行补造内容,否则会把模型错误伪装成成功结果。
| 错误类型 | 推荐处理 |
|---|---|
| 代码围栏、尾随逗号 | 做一次确定性的文本修复后重新解析 |
| 缺字段、类型或范围错误 | 把校验错误与同一份 Schema 回传模型,最多重试一次 |
| 引用 ID 不在检索集合 | 视为 RAG 语义失败,要求重新生成 |
| 连续失败 | 返回受控错误并记录原始输出与校验原因 |
重试必须有上限,并保留失败原因供日志和指标统计。否则模型持续生成非法结构时,服务端会把一次答案请求放大成不可控的重试循环。
让结构化结果成为接口边界
在 RAG 链路中,模型输出不应直接作为最终接口响应。更稳妥的边界是“模型原始文本 → 解析 → Schema 校验 → 引用集合校验 → 业务对象”,只有最后的业务对象才能进入缓存、数据库或客户端。
这样做的价值不是让模型永远不出错,而是把随机性限制在明确的校验边界内:格式问题可有限修复,语义问题可重试,不可恢复的问题则显式失败。