
大模型应用开发 / 系统课时
设置片段重叠
设置片段重叠
片段切开后,边界附近的信息最容易丢失:定义在前一句、条件在后一句,检索时却只命中其中一侧。设置少量句子重叠,可以让相邻片段共享关键上下文,同时避免重复内容过多拖高索引与检索成本。
学习目标
- 理解片段重叠为什么能降低边界截断造成的信息损失
- 能按句子数量设置可控的重叠窗口
- 能根据句子长度和知识连续性调整重叠范围
重叠解决什么问题
假设第一段结尾写“上下文长度受模型窗口限制”,下一段开头写“因此片段不能无限增大”。如果两句被分到完全独立的片段里,单独命中第二段时,“因此”指向的原因就可能丢失。
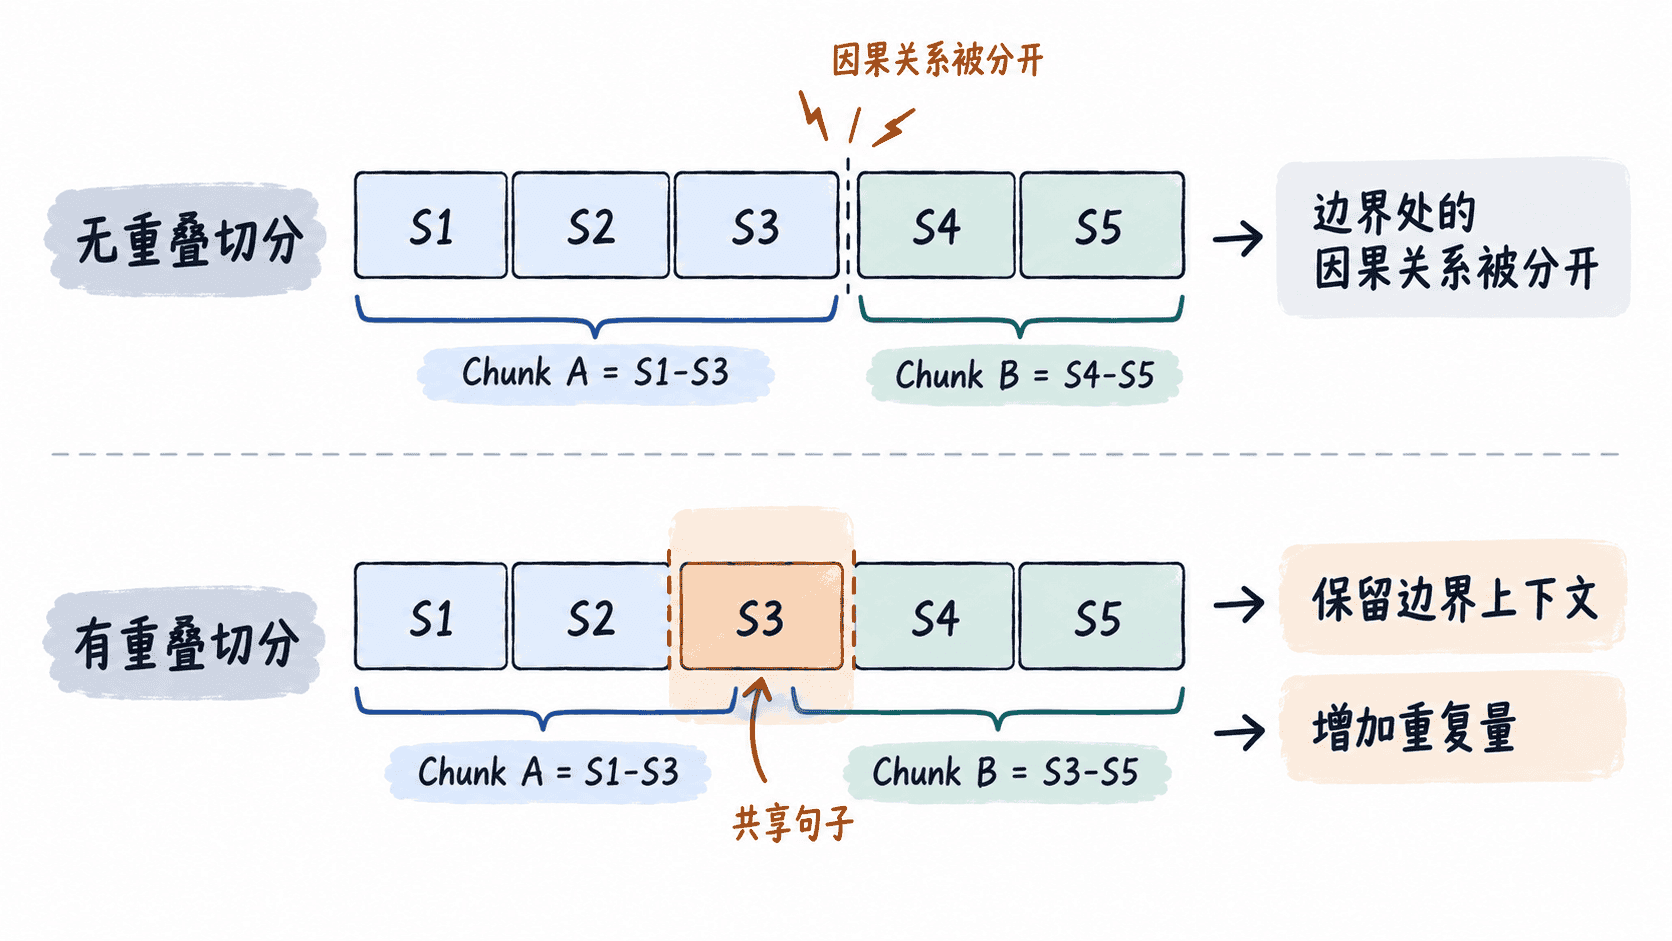
重叠的做法是让下一片段带上上一片段末尾的一小部分内容。这样,边界两侧的定义、条件、指代和因果关系更可能同时进入检索结果,但又不需要复制整段正文。
按句子设置重叠
下面用固定句子数演示重叠。每个片段最多包含 3 句,相邻片段共享 1 句,因此第二个片段会从第一个片段的最后一句重新开始。
sentences = [
    "RAG 先检索与问题相关的片段。",
    "检索结果会和用户问题一起组成上下文。",
    "上下文长度受模型窗口限制。",
    "因此片段不能无限增大。",
    "适度重叠可以保留跨边界语义。",
]

def chunk_with_overlap(sentences, chunk_size=3, overlap=1):
    if chunk_size <= 0:
        raise ValueError("chunk_size 必须大于 0")
    if overlap < 0 or overlap >= chunk_size:
        raise ValueError("overlap 必须满足 0 <= overlap < chunk_size")

    step = chunk_size - overlap
    chunks = []

    for start in range(0, len(sentences), step):
        chunk = sentences[start:start + chunk_size]
        if chunk:
            chunks.append("".join(chunk))
        if start + chunk_size >= len(sentences):
            break

    return chunks

for index, chunk in enumerate(chunk_with_overlap(sentences), 1):
    print(f"chunk {index}: {chunk}")
预期输出
chunk 1: RAG 先检索与问题相关的片段。检索结果会和用户问题一起组成上下文。上下文长度受模型窗口限制。
chunk 2: 上下文长度受模型窗口限制。因此片段不能无限增大。适度重叠可以保留跨边界语义。
共享的第三句让“窗口限制”和后面的“因此”保持在同一片段中。这里的 overlap=1 表示重叠 1 个句子,而不是 1 个字符;对于自然语言文档,这种边界通常比硬截字符更容易保住完整语义。
根据句子长度调范围
重叠不应只看固定比例,还要看句子长度和知识连续性。句子很短、跨句指代很多时,可以重叠 1~2 句;单句很长时,即使只重叠 1 句,也可能复制大量 token,此时更适合改成按 token 预算控制重叠。
还要观察知识是否在边界处连续。如果上一句只是段落结束语,重复价值很低;如果它包含定义、前置条件、公式前提或实体全称,保留到下一片段通常更有价值。也就是说,重叠范围应服务于“保住必要上下文”,而不是追求固定百分比。
避免重叠过大
重叠越大,边界信息越安全,但重复内容也越多。它会增加向量条目中的冗余,可能让检索结果出现多个高度相似片段,还会占用更多上下文窗口,挤压真正互补的信息。
一个实用起点是先让相邻片段共享 1 个完整句子,再用真实查询检查边界知识是否仍被截断。只有当错误确实来自上下文断裂时再增加重叠;若问题来自片段过大、主题混杂或检索模型不匹配,应分别调整切分策略或检索策略。