
大模型应用开发 / 系统课时
评估答案忠实度
评估答案忠实度
忠实度评估要回答一个核心问题:答案里的每个可核对声明,是否都能从本次检索到的知识片段中找到充分证据。通过声明拆分、证据对齐和冲突标记,可以快速发现无依据补充、越界推断和与资料相反的内容。
学习目标
- 把一段答案拆成可独立核对的事实声明
- 区分“有证据”“证据不足”和“与证据矛盾”
- 用简单指标和错误样本定位忠实度问题
先把答案拆成可核对的声明
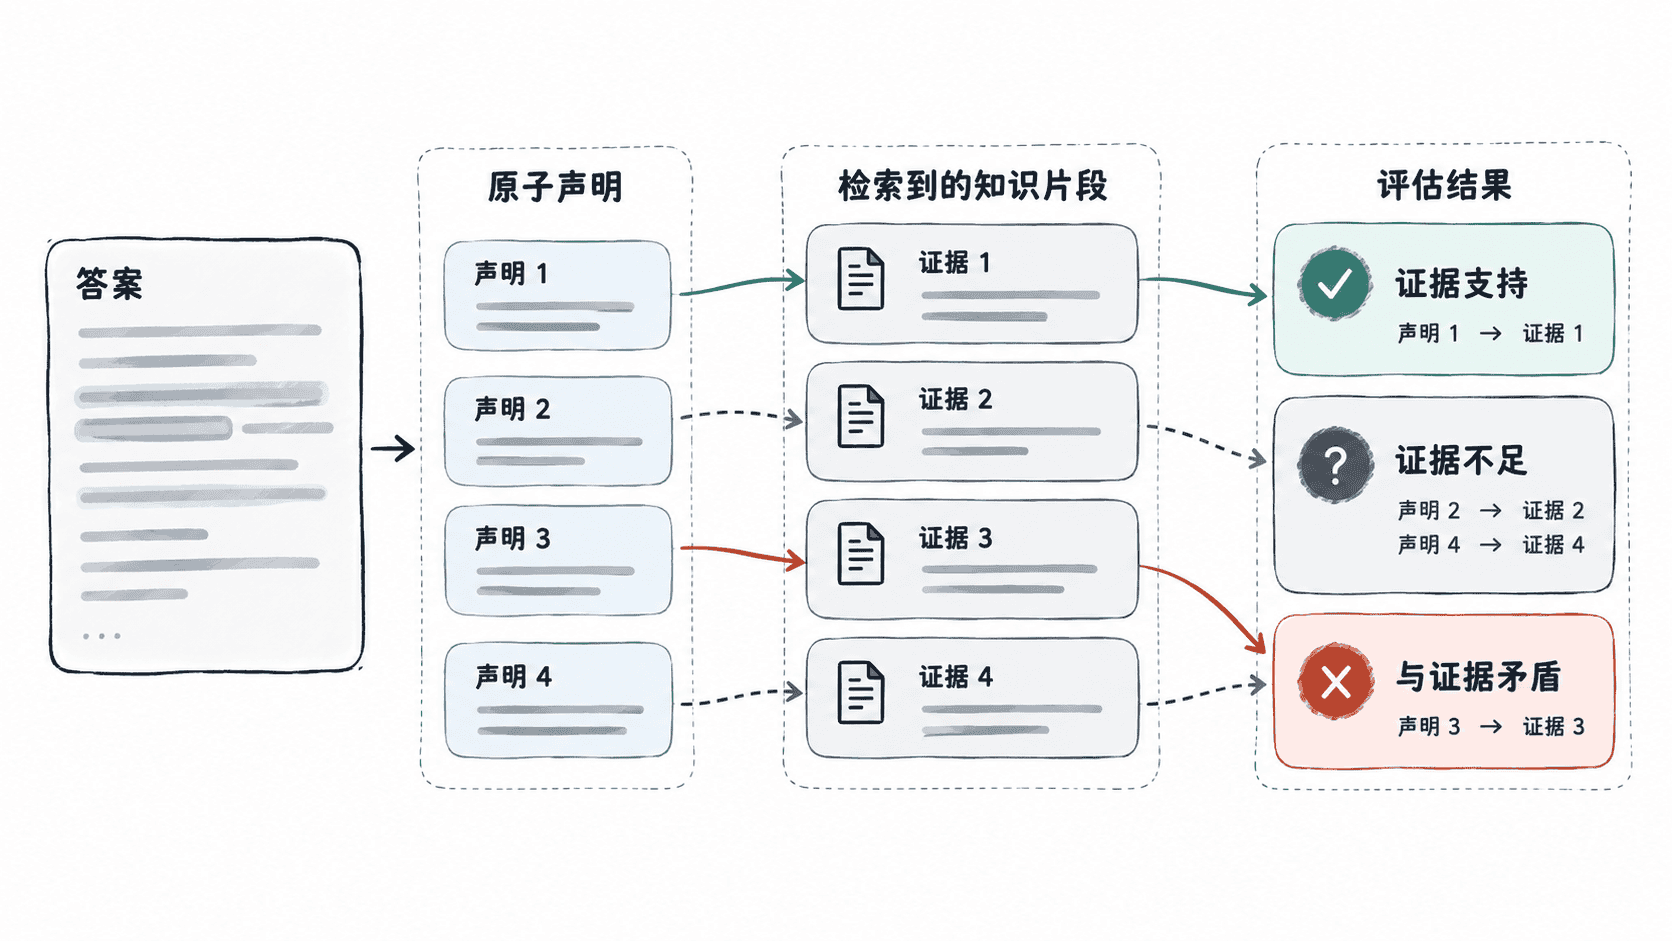
不要直接给整段答案打一个“正确/错误”标签。RAG 答案通常同时包含多个事实,其中一部分有依据,另一部分可能来自模型常识或推断。更稳定的做法是先拆成最小声明,再逐条寻找证据。
例如,知识片段写明“实体商品签收后 30 天内可退货;数字商品一经交付不支持退货”,答案却说“实体商品和数字商品都支持 30 天退货”。这段话至少包含两个声明:实体商品可 30 天退货、数字商品可 30 天退货。前者被支持,后者与资料直接冲突。
用证据标签判定每个声明
建议给每个声明保留证据编号,而不是只保存一个分数。这样当评估变差时,可以直接回看是哪条知识片段没有覆盖问题。
- SUPPORTED:知识片段明确支持声明,语义一致。
- INSUFFICIENT:资料没有足够信息证明或否定声明,常见于模型补充了检索范围之外的事实。
- CONTRADICTED:知识片段给出的事实与声明相反。
可以用“被支持的声明数 ÷ 可核对声明总数”作为一个直观忠实度指标,同时单独统计矛盾率。这里的分数主要用于回归比较,不应替代错误样本检查。
用最小脚本汇总评估结果
下面的脚本假设声明已经由人工或评估模型完成证据判定,它只负责汇总标签,避免把“判定质量”和“指标计算”混在一起。
claims = [
    {"text": "实体商品支持 30 天退货", "label": "SUPPORTED"},
    {"text": "数字商品支持 30 天退货", "label": "CONTRADICTED"},
    {"text": "退款会在 24 小时内到账", "label": "INSUFFICIENT"},
    {"text": "数字商品交付后不能退货", "label": "SUPPORTED"},
]

total = len(claims)
supported = sum(item["label"] == "SUPPORTED" for item in claims)
contradicted = sum(item["label"] == "CONTRADICTED" for item in claims)

# 忠实度只统计被证据直接支持的声明。
faithfulness = supported / total
contradiction_rate = contradicted / total

print(f"faithfulness={faithfulness:.2f}")
print(f"contradiction_rate={contradiction_rate:.2f}")
预期输出
faithfulness=0.50
contradiction_rate=0.25
这两个值实际会随样本和标注规则变化。更重要的是同时保存声明文本、标签和证据编号,这样才能定位问题来自检索缺失、上下文截断,还是生成模型越界补充。
把忠实度评估接入回归流程
一个可复用的评估样本至少应固定用户问题、检索片段和模型答案。先拆分声明,再为每个声明绑定证据并打标签,最后汇总指标和错误样本。模型或提示词更新后,用同一批样本重跑,才能判断变化是否真实。
当低分主要来自 INSUFFICIENT 时,应优先检查召回、切块和上下文是否缺证据;当 CONTRADICTED 明显升高时,应重点检查知识版本冲突、提示词约束和生成阶段是否忽略了已给出的资料。