
大模型应用开发 / 系统课时
开展回归测试
开展回归测试
RAG 系统一旦修改模型、提示词、索引或检索策略,就可能在某些问题上悄悄退化。回归测试的目标,是用固定评测集重复执行同一套指标,并把新版本与基线版本自动比较,在上线前暴露效果下降。
学习目标
- 建立可重复执行的 RAG 回归评测基线
- 自动比较检索质量、回答质量与性能指标
- 用明确门禁阻止明显退化的版本进入生产环境
把每次变更变成可比较实验
回归测试首先要固定测试条件。评测集中的问题、标准答案或关键事实、相关文档标识以及指标计算方式都不应随着被测版本一起修改,否则新旧版本失去可比性。
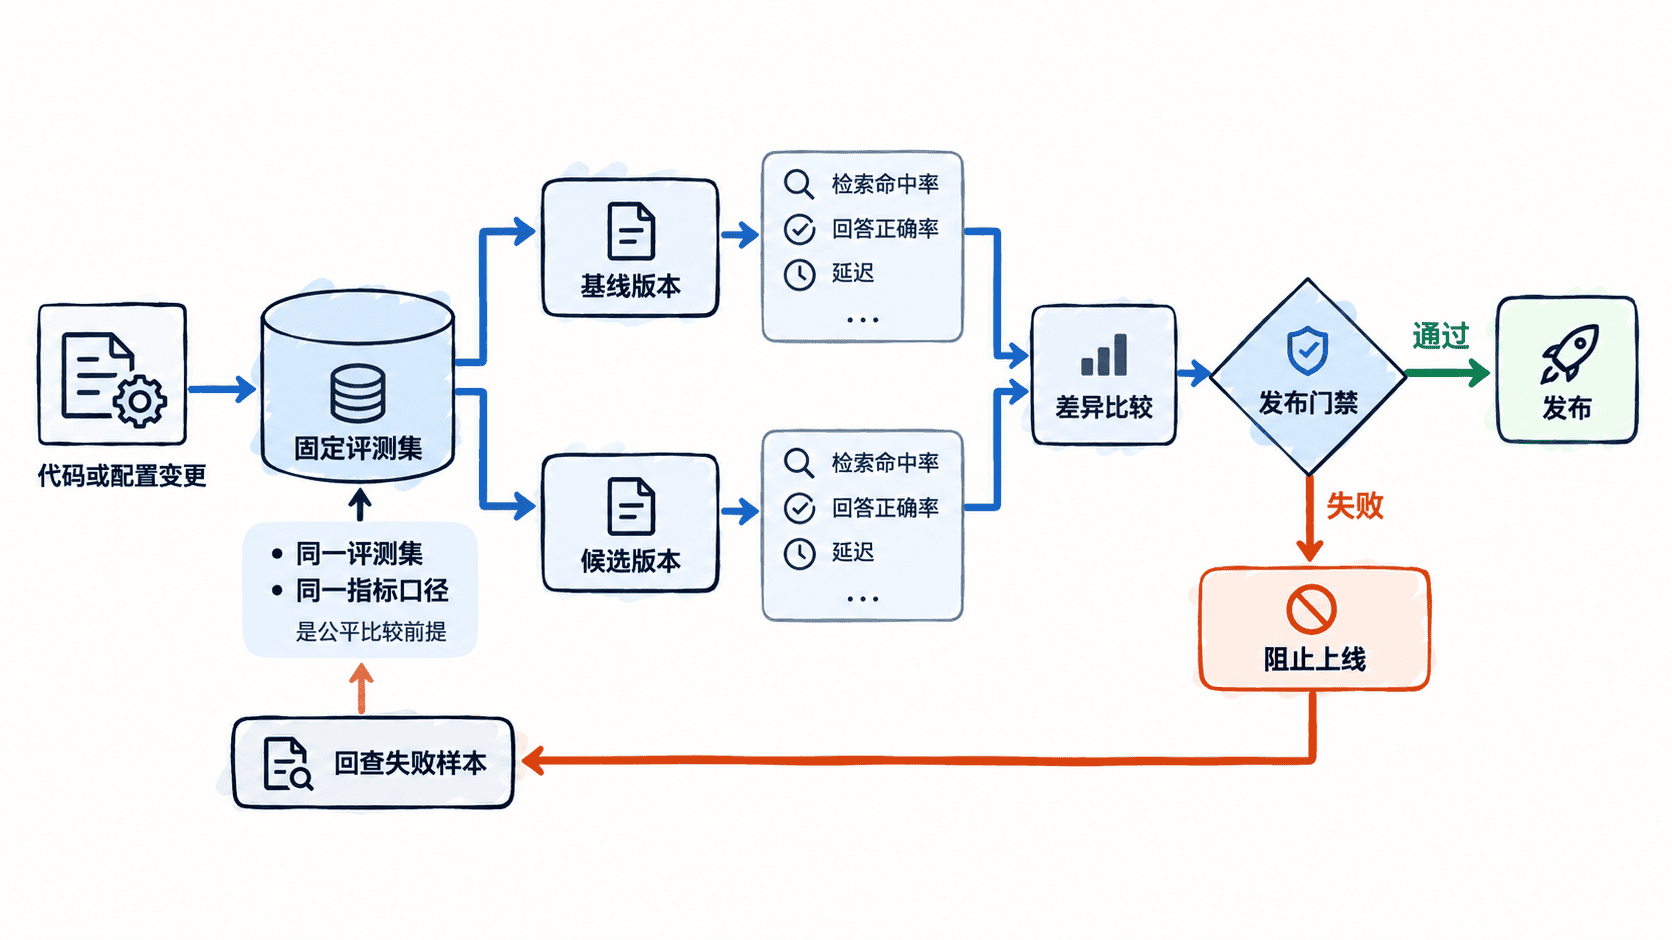
一次完整执行应分别运行基线版本和候选版本。两者使用同一批问题,只允许模型、提示词、索引版本或检索参数等目标变量发生变化,再计算指标差异并应用门禁。
建立最小指标门禁
不要只比较一个总分。RAG 至少应同时观察检索和生成两个阶段,并额外关注性能成本。例如检索命中率没有下降,但回答正确率下降,可能意味着提示词或模型退化;正确率上升而延迟翻倍,也可能不满足生产要求。
下面的可运行脚本使用三条固定样本,对基线版本与候选版本的离线结果进行评分,并根据阈值决定是否允许继续发布。
from statistics import mean

CASES = [
    {"id": "q1", "gold_doc": "doc-a", "keyword": "向量"},
    {"id": "q2", "gold_doc": "doc-b", "keyword": "重排"},
    {"id": "q3", "gold_doc": "doc-c", "keyword": "引用"},
]

baseline = [
    {"docs": ["doc-a", "doc-x"], "answer": "使用向量检索。", "latency_ms": 620},
    {"docs": ["doc-b", "doc-y"], "answer": "先检索再重排。", "latency_ms": 590},
    {"docs": ["doc-c", "doc-z"], "answer": "返回相关片段。", "latency_ms": 610},
]

candidate = [
    {"docs": ["doc-a", "doc-x"], "answer": "使用向量检索。", "latency_ms": 640},
    {"docs": ["doc-b", "doc-y"], "answer": "先检索再重排。", "latency_ms": 620},
    {"docs": ["doc-c", "doc-z"], "answer": "回答需要附带引用。", "latency_ms": 630},
]


def score(results):
    retrieval_hits = 0
    answer_hits = 0
    for case, result in zip(CASES, results):
        retrieval_hits += case["gold_doc"] in result["docs"]
        answer_hits += case["keyword"] in result["answer"]
    return {
        "retrieval_hit_rate": retrieval_hits / len(CASES),
        "answer_accuracy": answer_hits / len(CASES),
        "avg_latency_ms": mean(item["latency_ms"] for item in results),
    }


base = score(baseline)
new = score(candidate)
passed = (
    new["retrieval_hit_rate"] >= base["retrieval_hit_rate"]
    and new["answer_accuracy"] >= base["answer_accuracy"]
    and new["avg_latency_ms"] <= base["avg_latency_ms"] + 100
)

print(f"baseline={base}")
print(f"candidate={new}")
print("gate=PASS" if passed else "gate=FAIL")
预期输出
baseline={'retrieval_hit_rate': 1.0, 'answer_accuracy': 0.6666666666666666, 'avg_latency_ms': 606.6666666666666}
candidate={'retrieval_hit_rate': 1.0, 'answer_accuracy': 1.0, 'avg_latency_ms': 630}
gate=PASS
真实项目中应把示例里的离线结果替换为实际 RAG 链路运行产生的数据,并把脚本放入持续集成流程。只要门禁返回失败,流水线就应保留指标报告和失败样本,而不是继续自动发布。
设计能长期使用的回归集
测试集既要包含高频正常问题,也要保留历史故障样本和边界问题。索引变更时尤其要覆盖同义表达、长文档、多文档冲突、无答案问题以及容易召回相似错误片段的查询。
指标阈值也应区分方向。正确率、召回率通常要求不下降或达到最低值;延迟、成本通常要求不超过上限。对于存在随机性的模型,可以固定温度和随机种子,并重复运行关键样本,避免一次偶然输出决定发布结果。
从总分继续追到失败样本
门禁只回答“能不能上线”,定位还需要逐样本差异。建议为每条失败记录保留问题、基线答案、候选答案、召回文档及其排名、指标变化和被测版本标识。这样才能判断问题来自索引内容、召回排序、提示词还是模型本身。
可靠的回归测试最终应形成固定闭环:变更触发评测,候选版本与稳定基线使用同一数据集执行,指标自动比较,退化时阻断发布并留下可定位的失败样本。这样优化 RAG 才从人工试答变成可持续验证的工程流程。