
大模型原理与训练 / 系统课时
调好温度与蒸馏损失权重
调好温度与蒸馏损失权重
本节解决蒸馏训练中的两个核心旋钮:温度决定教师分布有多“软”,蒸馏权重决定学生更听教师还是更听真实标签。你将用验证集识别过度平滑、蒸馏信号过弱和教师偏差放大的现象,并选出稳定组合。
学习目标
- 判断 Temperature 对软目标信息量和训练信号的影响。
- 用统一定义混合监督损失与蒸馏损失,避免权重方向混淆。
- 根据验证集任务指标选择稳定组合,而不是只比较训练总损失。
明确两个超参数各控制什么
设 表示蒸馏损失权重,采用下面的统一定义:
因此 表示只看真实标签, 表示只模仿教师。不同代码库有时会把 alpha 定义成监督损失权重,方向恰好相反,所以调参前必须先确认实现公式。
Temperature 控制教师分布的平滑程度。 接近教师原始输出;适度增大 会暴露次优 Token 的相对偏好;过大时概率趋于均匀,类别之间的可辨别信号会变弱。即使 KL 外乘了 ,也只能补偿梯度尺度,不能恢复已经被过度平滑掉的结构信息。
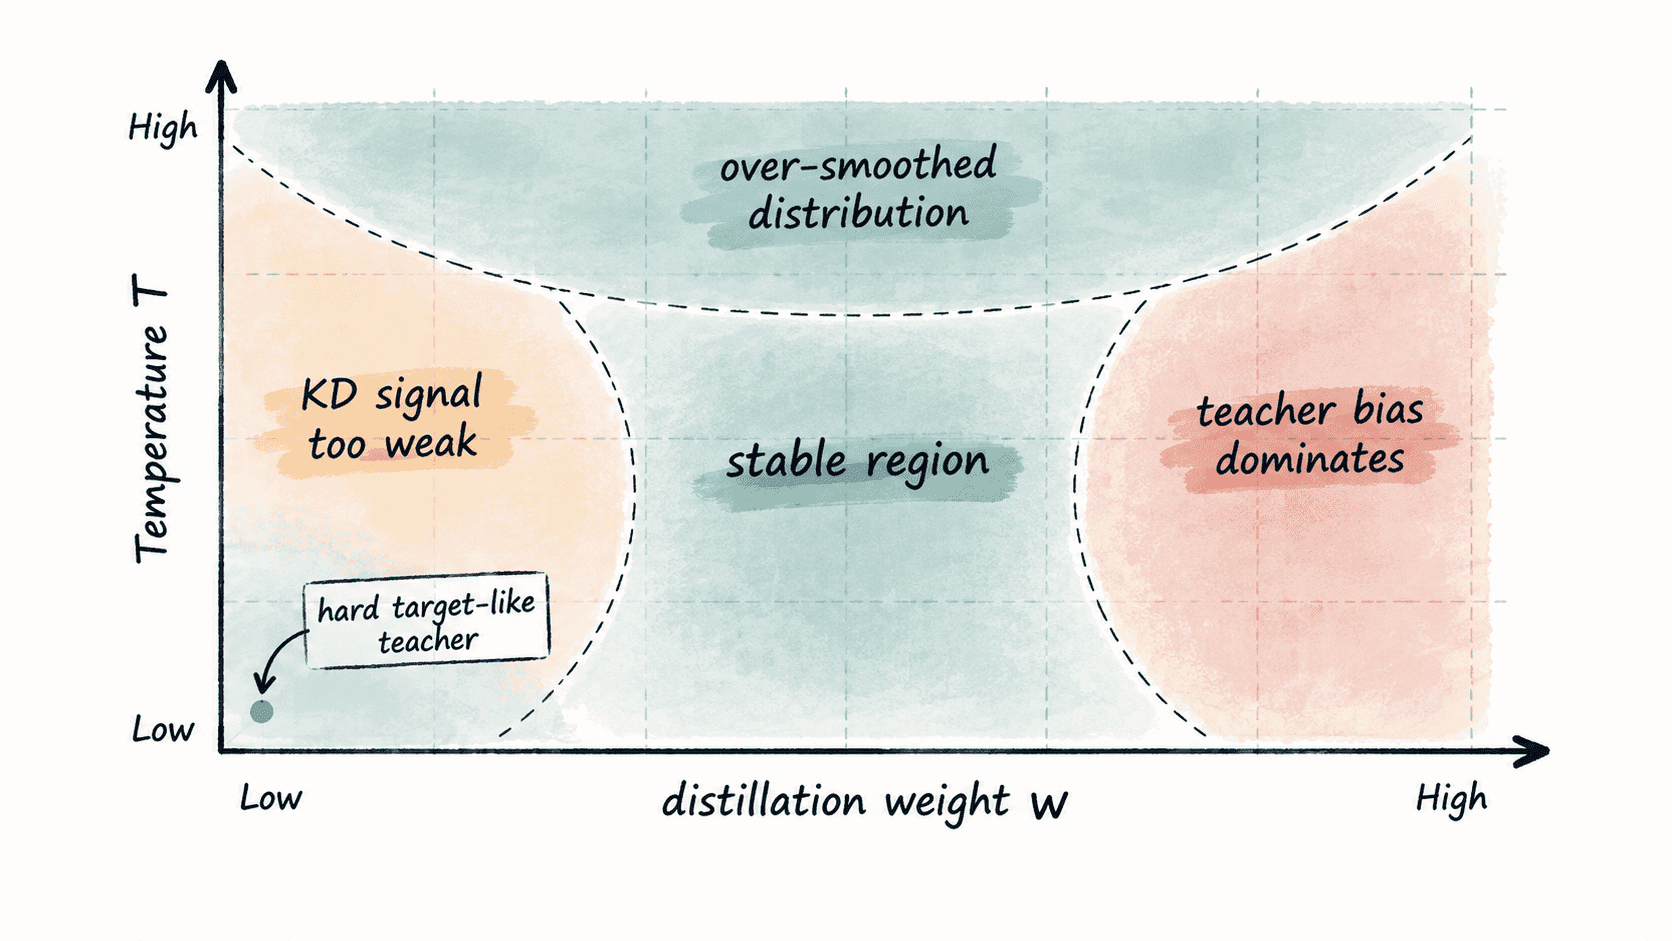
先识别三类失衡现象
温度过高时,教师分布会变得过平,训练中常见现象是 KD 损失变化很小、学生对类别间细微差异不再敏感,验证指标也没有随教师一致率提升。相反,温度太低时,软目标接近硬标签,蒸馏带来的“暗知识”会减少。
学生“学不动教师”通常先检查 是否太小,其次检查温度是否让分布过平,以及 KD 与监督损失的数值量级是否严重失衡。若训练集 KD 持续下降,但学生与教师输出仍没有明显靠近,还应检查掩码、对齐位置和教师输出是否正确。
教师并不等于真实答案。若 太高,学生可能越来越像教师,同时真实标签上的验证指标反而下降。这是教师偏差被放大的典型信号。此时应优先降低蒸馏权重,而不是继续追求更低的 KD 损失。
用验证集做小范围搜索
不要直接比较不同 下的“训练总损失”,因为权重变化后目标函数本身已经变了。更可靠的依据是固定验证集上的任务指标,例如准确率、困惑度或真实标签交叉熵,并同时观察教师一致率是否出现“更像教师但任务更差”的反向变化。
实践中可以先取少量离散候选,例如 T = [1, 2, 4, 8]、w = [0.2, 0.5, 0.8]。先粗扫,再围绕最优区域补邻近点;最后至少用多个随机种子复测最有希望的两三个组合,避免把偶然波动当作最佳超参数。
下面的可运行脚本演示如何从已经完成的实验记录中选择稳定组合:先保留准确率距离最优值不超过 0.003 的候选,再选真实标签验证交叉熵最低者。
records = [
    {"temperature": 1.0, "kd_weight": 0.2, "val_ce": 0.490, "val_accuracy": 0.806},
    {"temperature": 2.0, "kd_weight": 0.5, "val_ce": 0.451, "val_accuracy": 0.822},
    {"temperature": 4.0, "kd_weight": 0.5, "val_ce": 0.438, "val_accuracy": 0.827},
    {"temperature": 4.0, "kd_weight": 0.8, "val_ce": 0.462, "val_accuracy": 0.819},
    {"temperature": 8.0, "kd_weight": 0.5, "val_ce": 0.479, "val_accuracy": 0.811},
    {"temperature": 2.0, "kd_weight": 0.8, "val_ce": 0.447, "val_accuracy": 0.825},
]

allowed_accuracy_drop = 0.003
best_accuracy = max(item["val_accuracy"] for item in records)

stable_candidates = [
    item
    for item in records
    if item["val_accuracy"] >= best_accuracy - allowed_accuracy_drop
]

best = min(stable_candidates, key=lambda item: item["val_ce"])

print(f"best_temperature={best['temperature']}")
print(f"best_kd_weight={best['kd_weight']}")
print(f"val_accuracy={best['val_accuracy']:.3f}")
print(f"val_ce={best['val_ce']:.3f}")
预期输出
best_temperature=4.0
best_kd_weight=0.5
val_accuracy=0.827
val_ce=0.438
这里的数值只是示例实验记录,不能直接迁移到真实模型;真正可迁移的是选择原则:先用任务指标圈出高质量区域,再用更稳定的验证损失、多个随机种子和训练曲线判断哪个组合更可靠。
用现象反推下一步调整
当高温度候选普遍变差时,先向较低温度收缩搜索范围;当提高 后教师一致率上升但真实标签指标下降时,降低蒸馏权重;当低 与纯监督训练几乎没有差异时,再逐步提高蒸馏权重,而不是一次跳到接近 1。
一个稳定组合通常不是某个孤立尖点,而是在相邻 Temperature 和权重附近都保持较好表现的区域。选择这种“宽而稳”的参数区间,比追逐单次实验中的最高分更适合后续放大数据规模和上线训练。