
大模型原理与训练 / 系统课时
用 KL 散度对齐输出分布
用 KL 散度对齐输出分布
本节解决蒸馏中最容易写错的一步:把教师与学生的 Token Logits 变成可比较的软分布,并只在有效 Token 上计算 KL 散度。完成后,你能得到一个可反向传播、不会被 Padding 稀释的蒸馏损失。
学习目标
- 从教师和学生 Logits 构造带温度的软目标分布。
- 用有效 Token 掩码排除 Padding,并按有效数量归一化损失。
- 正确使用 KL 散度与 缩放,避免方向、维度和梯度处理错误。
从 Logits 构造可比较的软分布
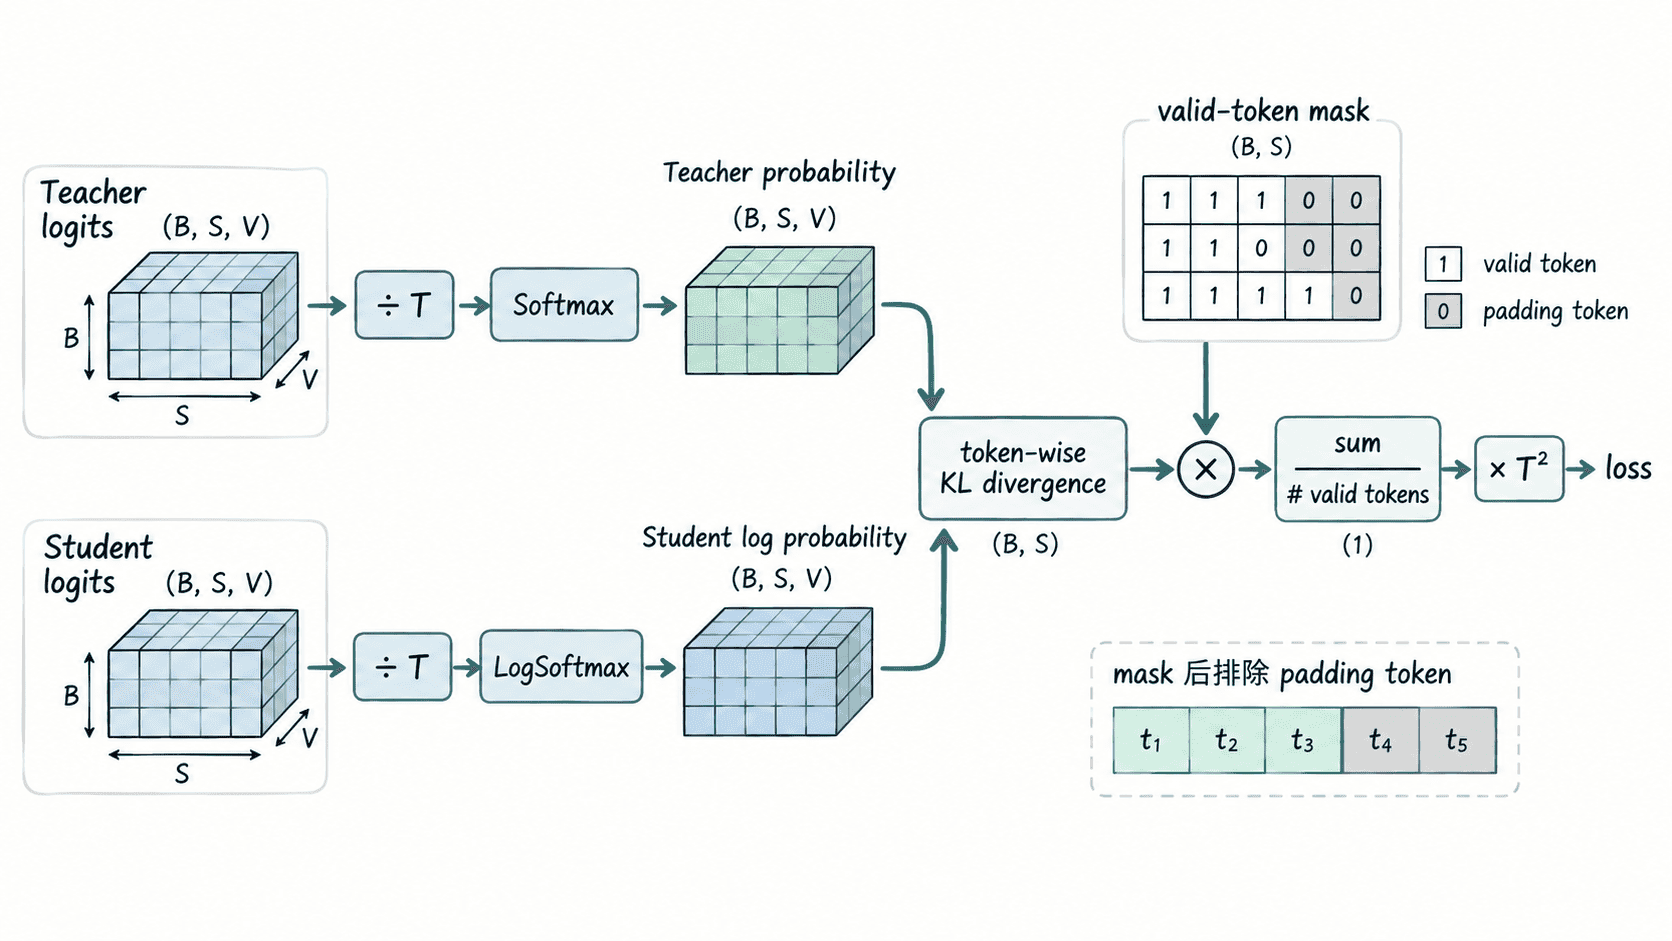
教师输出的 Logits 不是概率。设教师 Logits 为 、学生 Logits 为 、温度为 ,先在词表维度上做温度缩放。教师形成目标分布 ,学生形成对数概率 。
蒸馏通常最小化从教师分布到学生分布的 KL 散度:
这里对每个 Token 的词表维度求和,因此输入形状若为 [batch, seq, vocab],逐 Token 的 KL 结果就是 [batch, seq]。教师分布应作为固定目标,不让梯度回传到教师模型。
用掩码只统计有效 Token
Padding 位置通常没有学习意义,但若直接对所有序列位置取平均,短样本会被大量 Padding 稀释。正确顺序是先得到每个 Token 的 KL,再乘 [batch, seq] 掩码,最后除以掩码中有效位置的数量,而不是除以固定的 batch * seq。
如果训练数据还用 -100 屏蔽提示词或其他不监督位置,应使用真正的监督掩码,例如 labels.ne(-100),而不是只看 attention_mask。对自回归语言模型做 next-token 训练时,还要保证教师 Logits、学生 Logits、标签和掩码在移位后指向同一批预测位置。
可运行实现
下面的 PyTorch 示例包含 2 个有效 Token 和 2 个 Padding Token。第三、第四个位置即使教师与学生分布差异较大,也不会进入最终蒸馏损失。
import torch
import torch.nn.functional as F

teacher_logits = torch.tensor([[
    [5.0, 1.0, 0.0],
    [1.0, 3.0, 0.5],
    [0.2, 0.2, 0.2],
    [0.2, 0.2, 0.2],
]])

student_logits = torch.tensor([[
    [3.0, 1.5, 0.5],
    [1.2, 2.0, 0.3],
    [2.0, 0.0, 0.0],
    [2.0, 0.0, 0.0],
]], requires_grad=True)

valid_token_mask = torch.tensor([[1, 1, 0, 0]], dtype=torch.float32)
temperature = 2.0

teacher_prob = F.softmax(teacher_logits / temperature, dim=-1)
student_log_prob = F.log_softmax(student_logits / temperature, dim=-1)

# 先在 vocab 维度求和,保留每个 token 的 KL。
token_kl = F.kl_div(
    student_log_prob,
    teacher_prob,
    reduction="none",
).sum(dim=-1)

# 只统计有效 token,并用 T^2 补偿温度缩放带来的梯度幅度变化。
valid_count = valid_token_mask.sum().clamp_min(1.0)
kd_loss = (token_kl * valid_token_mask).sum() / valid_count
kd_loss = kd_loss * (temperature ** 2)

kd_loss.backward()

print(f"valid_tokens={int(valid_count.item())}")
print(f"kd_loss={kd_loss.item():.6f}")
print(f"student_grad_l1={student_logits.grad.abs().sum().item():.6f}")
预期输出
valid_tokens=2
kd_loss=0.358874
student_grad_l1=0.761225
输出说明掩码后只剩 2 个有效位置,且学生 Logits 获得了非零梯度,因此这段 KL 可以直接并入训练目标。
检查最常见的实现错误
torch.nn.functional.kl_div 的第一个参数必须是对数概率,第二个参数才是教师概率;把两个普通概率直接传入会得到错误含义。reduction="batchmean" 也不知道哪些序列位置是 Padding,因此 Token 级任务更适合先保留逐位置结果,再显式掩码和归一化。
温度大于 1 时,分布会变软,教师在非最大类别上的相对偏好更容易暴露。常见做法在 KL 外乘 ,用于补偿温度缩放导致的梯度量级变化。这个缩放不能替代验证集调参,但能让不同温度下的损失尺度更可比。
最终应把“同一预测位置的教师分布、学生分布和有效掩码”作为一个整体检查;只要三者有一处错位,数值仍可能正常下降,但学生学到的就是错误目标。