
大模型原理与训练 / 系统课时
核对量化模型格式与元数据
核对量化模型格式与元数据
量化权重能否部署,关键不只是“文件都在”,而是配置、Tokenizer、权重分片和量化方法能形成一致契约。本节用一套目录预检方法确认模型是否可被推理后端正确识别,并在启动服务前暴露缺分片、错标量化方法等问题。
学习目标
- 识别量化模型目录中配置、Tokenizer、Safetensors 分片各自承担的职责
- 核对
quantization_config与实际量化方法是否一致 - 用脚本在部署前发现缺文件、缺索引和量化元数据异常
把模型目录看成一个可验证契约
config.json 决定模型架构以及量化元数据,Tokenizer 文件负责把文本稳定映射为 token,Safetensors 保存真实权重;多分片模型还依赖索引把参数名映射到具体分片。推理后端通常先读取这些元数据,再选择对应的加载器和量化内核,因此目录名里写着 “AWQ” 或 “GPTQ” 并不能代替配置。
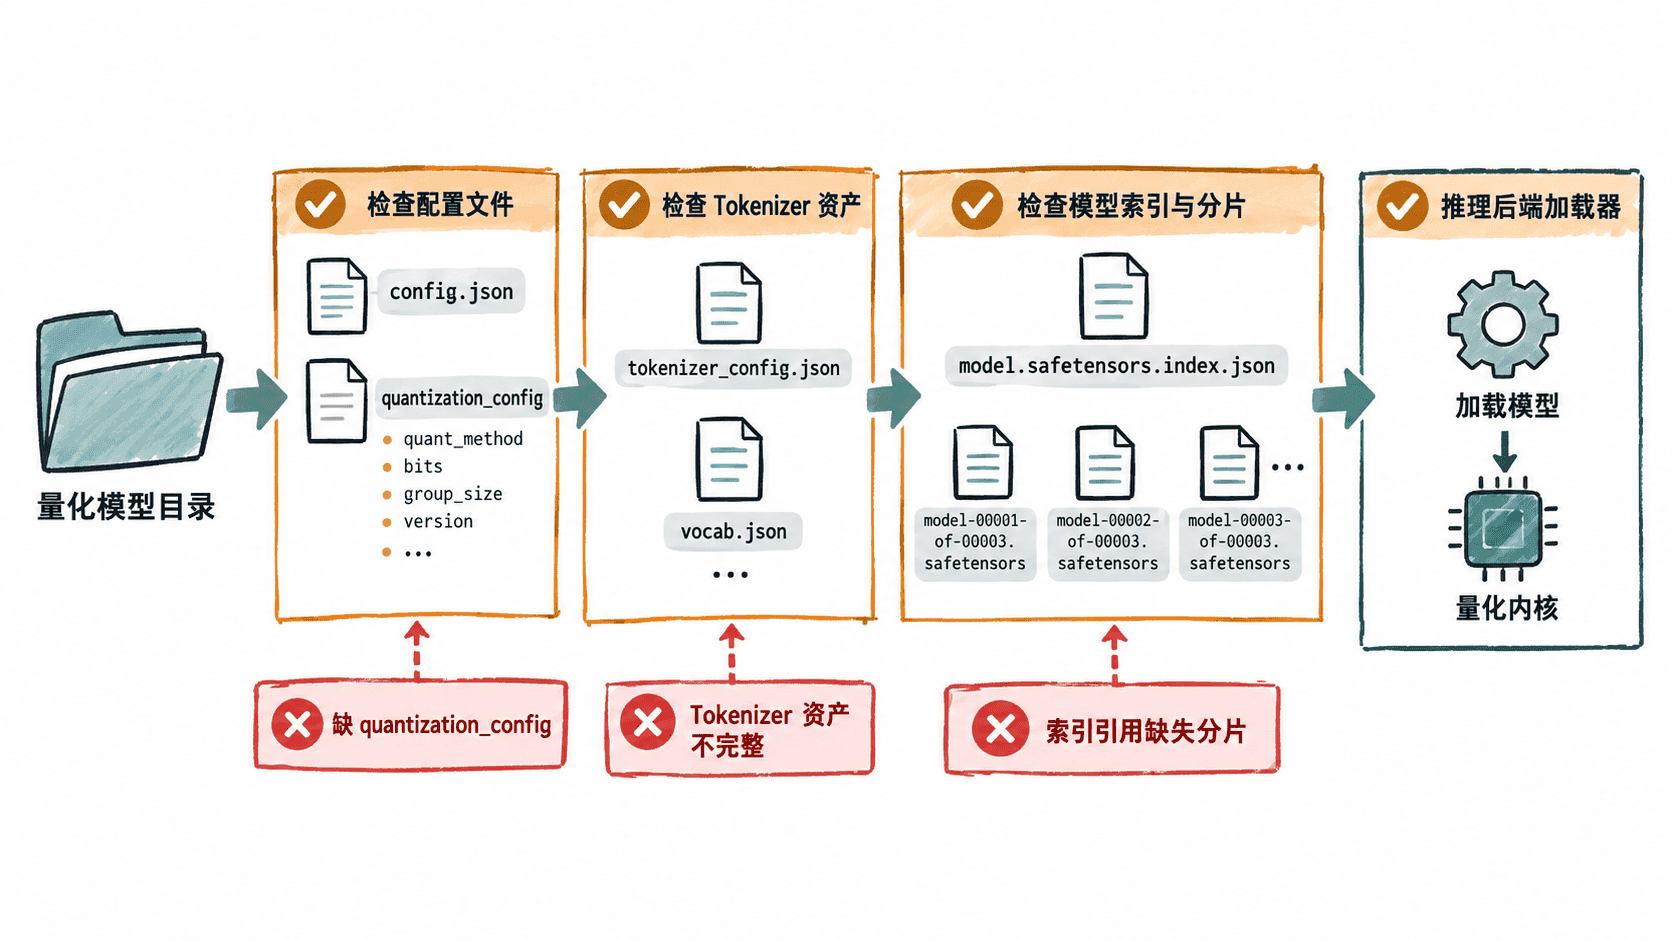
检查时不要只确认文件名存在,还要确认字段之间互相吻合。AWQ、GPTQ 等方法的配置字段会有差异,但最重要的是量化方法标识与权重真实格式一致;手工把 quant_method 改成另一个值不会转换权重,只会让后端用错误方式解释文件。
| 检查对象 | 重点确认 | 常见故障 |
|---|---|---|
config.json |
架构信息、quantization_config |
后端按普通精度模型加载或直接拒绝 |
quantization_config |
quant_method、位宽、分组等方法参数 |
量化内核与权重格式不匹配 |
| Tokenizer | tokenizer_config.json 与实际词表资产 |
加载失败或 token 映射异常 |
| Safetensors | 分片文件与索引引用一致 | 启动时报告缺权重文件 |
运行一次目录预检
下面脚本只依赖 Python 标准库,适合在把模型交给 vLLM 等后端之前运行。示例默认检查 /models/llama-awq;实际部署时把它替换为自己的 <PATH>。
set -euo pipefail

MODEL_DIR="${MODEL_DIR:-/models/llama-awq}"

python - "$MODEL_DIR" <<'PY'
import json
import sys
from pathlib import Path

root = Path(sys.argv[1])
errors = []

config_path = root / "config.json"
if not config_path.is_file():
    raise SystemExit("missing config.json")

config = json.loads(config_path.read_text(encoding="utf-8"))
qconfig = config.get("quantization_config")
if not isinstance(qconfig, dict):
    qconfig = {}
    errors.append("quantization_config missing")

quant_method = qconfig.get("quant_method")
if not quant_method:
    errors.append("quant_method missing")

tokenizer_config = root / "tokenizer_config.json"
if not tokenizer_config.is_file():
    errors.append("tokenizer_config.json missing")

tokenizer_candidates = ["tokenizer.json", "tokenizer.model", "vocab.json"]
tokenizer_assets = [name for name in tokenizer_candidates if (root / name).is_file()]
if not tokenizer_assets:
    errors.append("tokenizer vocabulary asset missing")

weights = sorted(root.glob("*.safetensors"))
if not weights:
    errors.append("no safetensors weights found")

index_path = root / "model.safetensors.index.json"
missing_shards = []
if index_path.is_file():
    index = json.loads(index_path.read_text(encoding="utf-8"))
    referenced = sorted(set(index.get("weight_map", {}).values()))
    missing_shards = [name for name in referenced if not (root / name).is_file()]
    if missing_shards:
        errors.append("index references missing shards")
elif len(weights) > 1:
    errors.append("multiple safetensors files but no model.safetensors.index.json")

print(f"quant_method={quant_method}")
print(f"bits={qconfig.get('bits')}")
print(f"group_size={qconfig.get('group_size')}")
print(f"tokenizer_assets={','.join(tokenizer_assets) or '<NONE>'}")
print(f"safetensors_files={len(weights)}")
print(f"index_present={index_path.is_file()}")
print(f"missing_shards={len(missing_shards)}")

if errors:
    print("status=FAIL")
    for item in errors:
        print(f"error={item}")
    raise SystemExit(1)

print("status=OK")
PY
对于一个 4-bit、group_size=128、三分片且元数据完整的 AWQ 示例,预期输出如下。分片数量、Tokenizer 文件和量化参数会随模型变化。
quant_method=awq
bits=4
group_size=128
tokenizer_assets=tokenizer.json
safetensors_files=3
index_present=True
missing_shards=0
status=OK
判断结果是否足够上线
status=OK 只说明包结构自洽,不代表推理数值一定正确。部署前还应确认当前推理后端支持该 quant_method、模型架构和 GPU 架构,并用一次真实生成请求做最终验证。
如果脚本报告多个 Safetensors 文件却没有索引,不要凭文件名顺序猜测加载关系;应重新导出或补回与权重匹配的索引。若 quantization_config 缺失,也应回到原始量化产物或导出流程恢复元数据,而不是根据仓库名手工猜一个方法标识。