
大模型原理与训练 / 系统课时
用 4 位权重进一步压缩显存
用 4 位权重进一步压缩显存
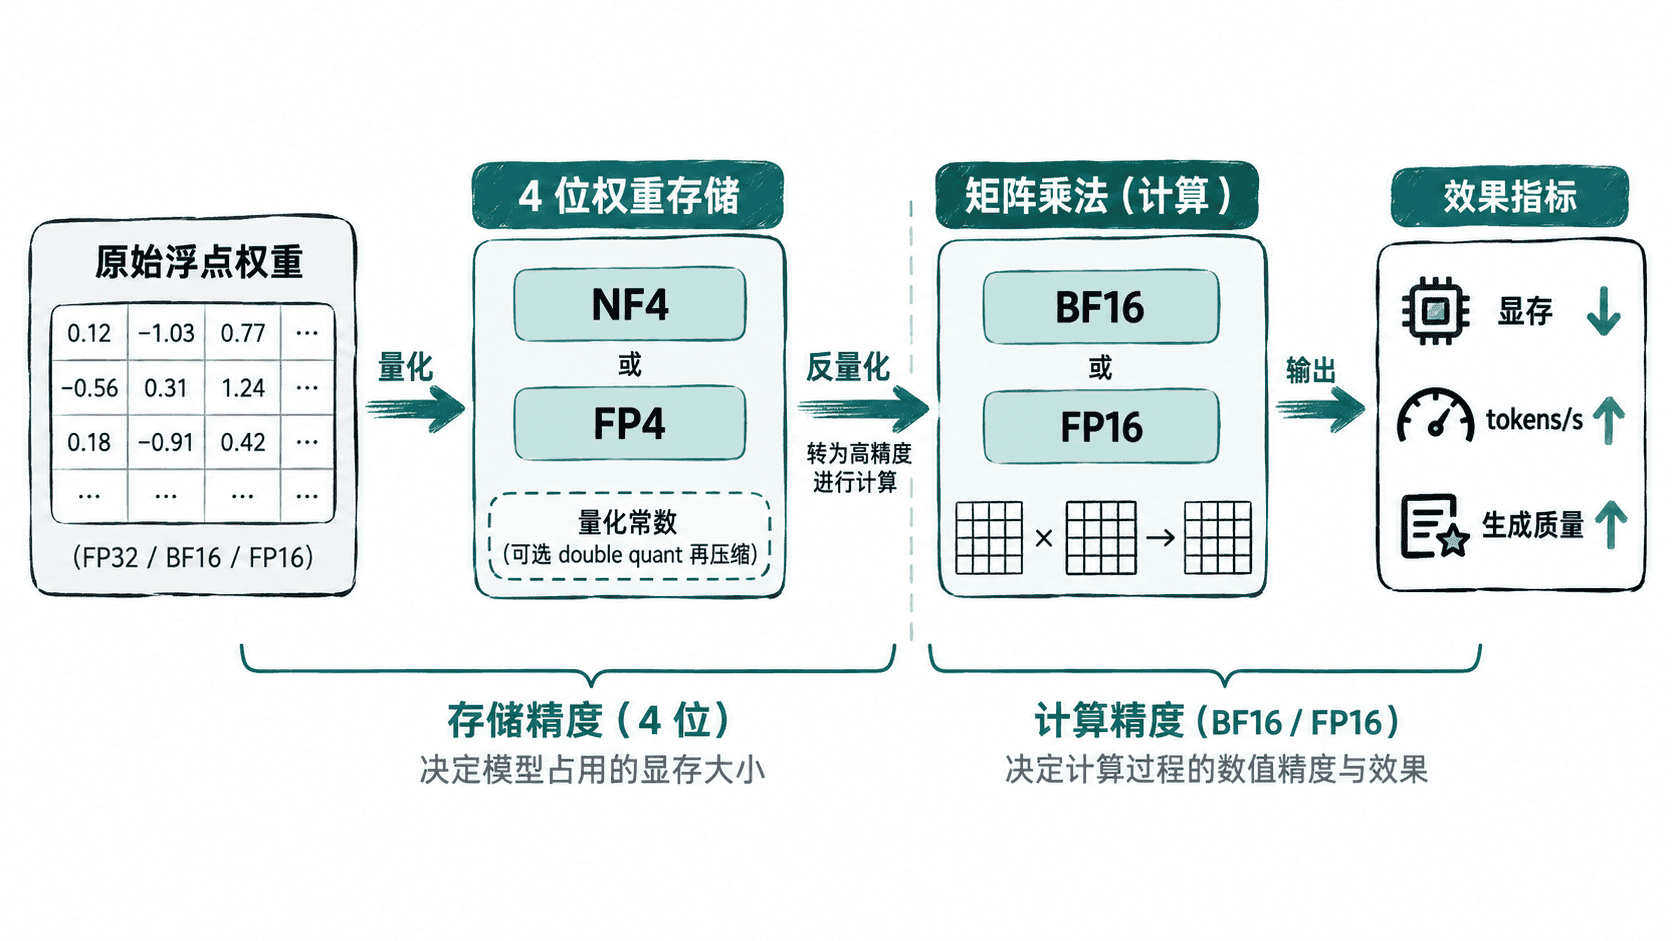
本节把 bitsandbytes 4 位加载拆成三个可控变量:权重量化类型、计算精度和双重量化,并用同一脚本记录显存、吞吐与生成文本。你会看到 4 位解决的是“权重怎么存”,而 BF16/FP16 决定的是“矩阵乘法用什么精度算”,两者不能混为一谈。
学习目标
- 用
load_in_4bit、bnb_4bit_quant_type与bnb_4bit_compute_dtype完成 4 位模型加载。 - 区分 NF4/FP4、计算 dtype 与 double quant 对存储和计算的不同作用。
- 用统一基准记录 4 位权重的显存、速度和输出变化,并建立质量验收边界。
4 位存储不等于 4 位计算
bitsandbytes 会把线性层权重压到 4 位表示,常见量化类型是 nf4 与 fp4;执行矩阵乘法时,仍会按 bnb_4bit_compute_dtype 使用 BF16、FP16 等计算精度。也就是说,权重存储精度负责节省显存,计算 dtype 更直接影响内核支持、数值范围和速度。
NF4 针对近似正态分布的权重设计,尤其常用于 QLoRA 训练;对纯推理而言,不应把“NF4”理解成任何模型上都必然质量更高或更快。bnb_4bit_use_double_quant=True 则会继续量化第一层量化所需的常数,可再节约一部分存储,但最好把它作为单独变量测量。
用一个基准切换 INT4、INT8 与 FP16
下面脚本默认运行 INT4,并允许用 --mode 切换 fp16、int8、int4。--quant-type 选择 nf4 或 fp4,--compute-dtype 选择 fp16 或 bf16,--double-quant 用于开启双重量化。这样每次只改一个变量,就能避免把多种优化叠在一起后无法解释结果。
import argparse
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "facebook/opt-125m"
PROMPT = "Machine learning deployment is"

def reset_peaks():
    for index in range(torch.cuda.device_count()):
        torch.cuda.reset_peak_memory_stats(index)

def total_peak_mib():
    total = 0
    for index in range(torch.cuda.device_count()):
        total += torch.cuda.max_memory_allocated(index)
    return total / 1024**2

def synchronize_all():
    for index in range(torch.cuda.device_count()):
        with torch.cuda.device(index):
            torch.cuda.synchronize()

def resolve_compute_dtype(name):
    if name == "bf16":
        if not torch.cuda.is_bf16_supported():
            raise SystemExit("This GPU does not report BF16 support.")
        return torch.bfloat16
    return torch.float16

def load_model(args):
    kwargs = {"device_map": "auto", "dtype": torch.float16}

    if args.mode == "int8":
        kwargs["quantization_config"] = BitsAndBytesConfig(load_in_8bit=True)
    elif args.mode == "int4":
        kwargs["quantization_config"] = BitsAndBytesConfig(
            load_in_4bit=True,
            bnb_4bit_quant_type=args.quant_type,
            bnb_4bit_compute_dtype=resolve_compute_dtype(args.compute_dtype),
            bnb_4bit_use_double_quant=args.double_quant,
        )

    return AutoModelForCausalLM.from_pretrained(MODEL_ID, **kwargs)

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--mode", choices=["fp16", "int8", "int4"], default="int4")
    parser.add_argument("--quant-type", choices=["nf4", "fp4"], default="nf4")
    parser.add_argument("--compute-dtype", choices=["fp16", "bf16"], default="fp16")
    parser.add_argument("--double-quant", action="store_true")
    args = parser.parse_args()

    if not torch.cuda.is_available():
        raise SystemExit("This benchmark requires CUDA for VRAM measurement.")

    tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
    torch.cuda.empty_cache()
    reset_peaks()

    model = load_model(args)
    load_peak = total_peak_mib()
    footprint = model.get_memory_footprint() / 1024**2
    inputs = tokenizer(PROMPT, return_tensors="pt").to(next(model.parameters()).device)

    # 预热后再计时,减少首次 kernel 初始化对吞吐的干扰。
    with torch.inference_mode():
        model.generate(**inputs, max_new_tokens=32, do_sample=False)
    synchronize_all()
    reset_peaks()

    started = time.perf_counter()
    with torch.inference_mode():
        output = model.generate(**inputs, max_new_tokens=32, do_sample=False)
    synchronize_all()
    elapsed = time.perf_counter() - started

    new_tokens = output.shape[-1] - inputs["input_ids"].shape[-1]
    print(f"mode={args.mode}")
    print(f"quant_type={args.quant_type if args.mode == 'int4' else 'n/a'}")
    print(f"compute_dtype={args.compute_dtype if args.mode == 'int4' else 'n/a'}")
    print(f"double_quant={args.double_quant if args.mode == 'int4' else 'n/a'}")
    print(f"runtime_footprint_mib={footprint:.1f}")
    print(f"load_peak_allocated_mib={load_peak:.1f}")
    print(f"generate_peak_allocated_mib={total_peak_mib():.1f}")
    print(f"tokens_per_second={new_tokens / elapsed:.2f}")
    print("text=" + tokenizer.decode(output[0], skip_special_tokens=True))

if __name__ == "__main__":
    main()
预期输出
mode=int4
quant_type=nf4
compute_dtype=fp16
double_quant=False
runtime_footprint_mib=<MIB>
load_peak_allocated_mib=<MIB>
generate_peak_allocated_mib=<MIB>
tokens_per_second=<TOKENS_PER_SECOND>
text=<TEXT>
这些动态值依赖 GPU、驱动、库版本和缓存状态。第一次记录默认 INT4 后,再分别改变一个参数复测:例如只改计算 dtype,或只开启 double quant;不要同时改 NF4、BF16 和双重量化,否则无法判断是哪一个变量造成差异。
选择 NF4、计算精度与双重量化
若目标是推理,先用模型自己的验证集比较 NF4 与 FP4,而不是只看单条文本。量化类型影响权重近似方式,模型分布不同,误差也不同。若后续还要做 QLoRA,NF4 通常更符合其训练设计;纯推理场景则以实测质量与内核表现为准。
计算精度优先选硬件原生支持的类型。支持 BF16 的 GPU 可测试 bf16,它拥有比 FP16 更大的指数范围;不支持时使用 FP16。这里的选择不会把 4 位权重“变回 16 位存储”,而是在计算时决定中间运算精度。
双重量化适合在显存极紧时继续压缩量化元数据。它节约的是量化常数相关存储,不意味着整个模型再减半。开启前后应分别记录 footprint 与吞吐;若节省很小,就没有必要为了配置复杂度强行开启。
为什么 4 位不一定更快
4 位最稳定的收益通常是减少权重占用,而不是线性提升速度。推理还要付出解包、反量化和专用 kernel 的成本;小模型、短序列或小 batch 下,这些固定开销甚至可能盖过显存带宽收益。只有在同一硬件、相同 batch、相同输入长度和相同生成长度下比较 tokens_per_second,速度结论才有意义。
同样,generate_peak_allocated_mib 不只包含权重,还包含激活、KV Cache 和临时缓冲区。长上下文场景里,KV Cache 可能逐渐成为主要显存来源,因此把权重从 8 位降到 4 位,并不会让端到端峰值显存也精确减半。
用质量门槛决定是否上线
最低限度要固定一批代表性输入,同时保存 FP16、INT8、INT4 的输出与任务指标。分类或抽取任务优先比较准确率、F1 等可量化指标;开放式生成可以结合自动评测与人工抽检。单个提示词文本没变化,只能证明这个样本通过,不能替代验证集。
若 INT4 让模型装进目标 GPU,却导致关键任务指标跌出阈值,正确做法不是继续调低精度,而是换量化方案、保留敏感模块高精度或回到 8 位。4 位上线的判据应同时满足容量、吞吐和质量三项约束;只赢显存而守不住质量,就不算完成部署优化。