
大模型原理与训练 / 系统课时
保留对量化敏感的高精度层
保留对量化敏感的高精度层
全模型统一低比特并不总是最优方案。这一节用逐层消融测量“只量化某一层”带来的输出误差,再把最敏感位置保留为高精度,同时计算额外的权重存储成本。最终得到的是基于测量结果的混合精度策略,而不是固定白名单。
学习目标
- 用逐层量化消融定位对低比特误差最敏感的模块
- 判断输入输出层、归一化层等候选位置是否值得保留高精度
- 量化混合精度方案相对全低比特路径增加的存储代价
先建立可比较的敏感度基线
逐层敏感度测试的核心是只改变一个变量。先用完整浮点模型在同一批代表性输入上得到基线输出,再复制模型,每次只把一个候选层切到目标低位宽,其余层保持原状。量化模型与基线之间的误差越大,该层越值得进入高精度候选集合。
可以先使用输出 MSE、余弦相似度或 logits 差异做快速筛查,但最终决策应回到任务指标,例如分类准确率、困惑度或生成质量。用于筛查的数据也必须覆盖真实输入分布,否则得到的“敏感层”很可能只是校准批次的偶然结果。
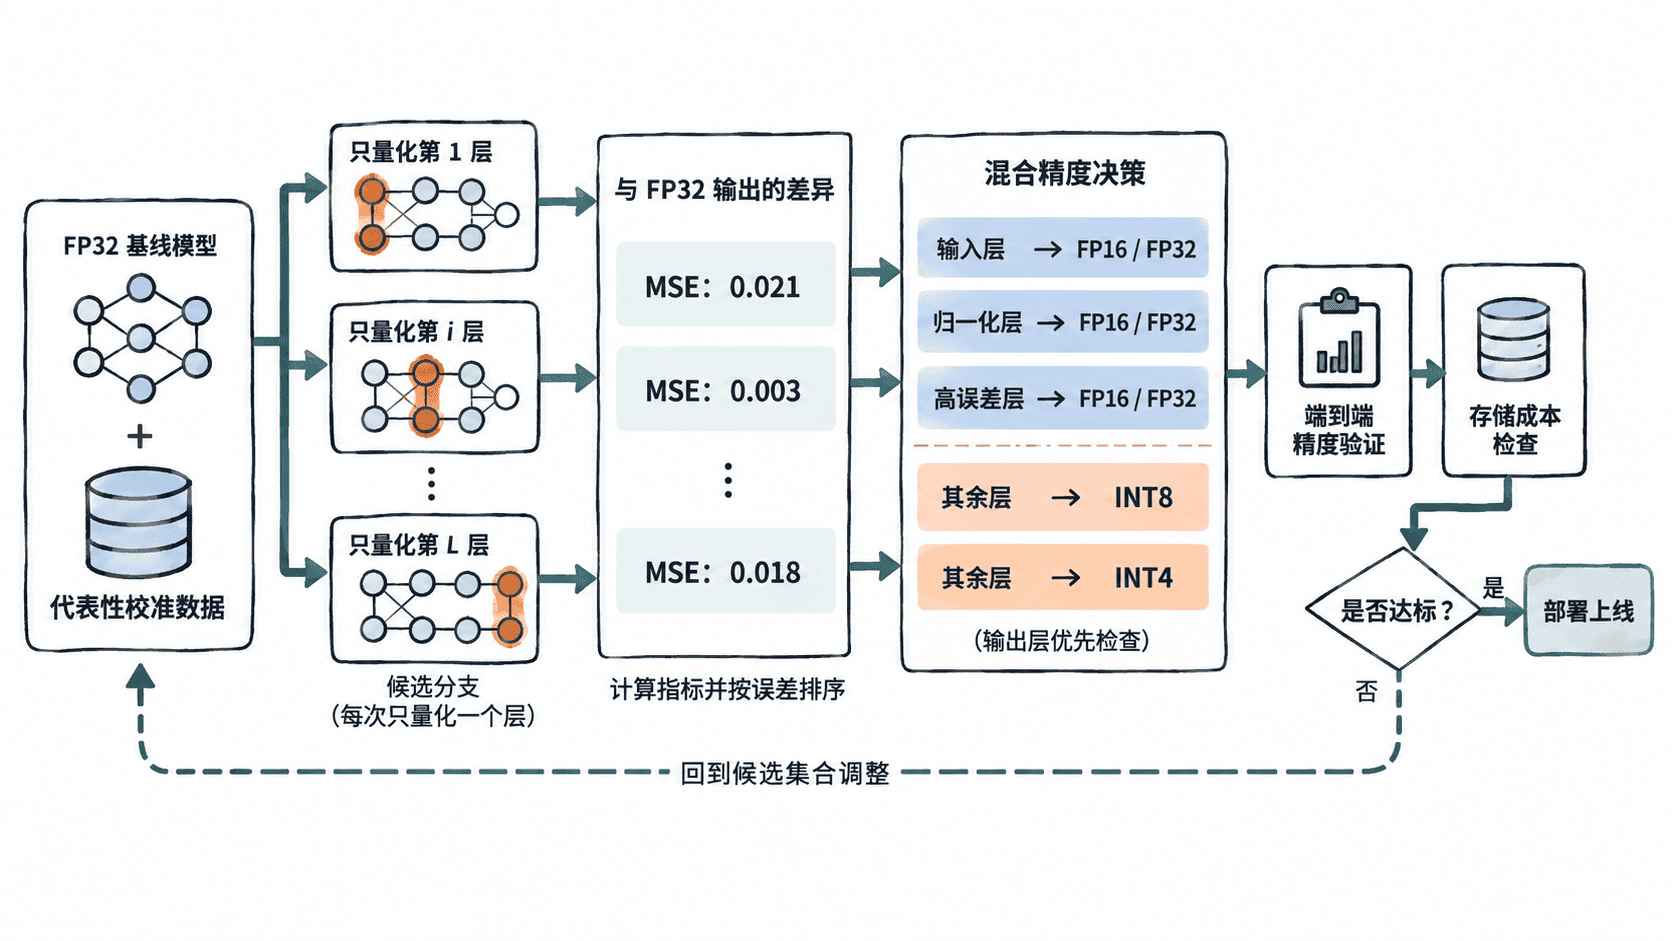
用逐层消融找出敏感权重
下面的完整示例构造包含三个 Linear 层和一个 LayerNorm 的小模型。每次只把一个 Linear 的权重量化到 INT4 网格,通过输出 MSE 排序;LayerNorm 则故意保持高精度。示例的成本统计只计算三个矩阵权重,不包含 bias 和 LayerNorm 参数。
import copy
import torch
from torch import nn


torch.manual_seed(7)


class TinyNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(8, 16)
        self.norm = nn.LayerNorm(16)
        self.act = nn.GELU()
        self.fc2 = nn.Linear(16, 8)
        self.fc3 = nn.Linear(8, 4)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.act(self.norm(self.fc1(x)))
        x = self.act(self.fc2(x))
        return self.fc3(x)


def quantize_weight_(layer: nn.Linear, bits: int = 4) -> None:
    qmax = 2 ** (bits - 1) - 1
    with torch.no_grad():
        w = layer.weight
        scale = w.abs().max().clamp(min=1e-8) / qmax
        w.copy_(torch.clamp(torch.round(w / scale), -qmax, qmax) * scale)


model = TinyNet().eval()
x = torch.randn(64, 8)

with torch.no_grad():
    baseline = model(x)

errors = {}
weight_counts = {}

for name, module in model.named_modules():
    if not isinstance(module, nn.Linear):
        continue

    candidate = copy.deepcopy(model)
    candidate_layer = dict(candidate.named_modules())[name]
    quantize_weight_(candidate_layer, bits=4)

    with torch.no_grad():
        candidate_output = candidate(x)
        errors[name] = torch.mean((candidate_output - baseline) ** 2).item()

    weight_counts[name] = module.weight.numel()

ranked = sorted(errors.items(), key=lambda item: item[1], reverse=True)
keep_fp32 = {ranked[0][0]}

all_int4_bits = sum(count * 4 for count in weight_counts.values())
all_fp32_bits = sum(count * 32 for count in weight_counts.values())
mixed_bits = sum(
    count * (32 if name in keep_fp32 else 4)
    for name, count in weight_counts.items()
)

print(f'tested_layers={len(errors)}')
print(f'all_errors_nonnegative={all(value >= 0 for value in errors.values())}')
print(f'selected_fp32={next(iter(keep_fp32))}')
print(f'selected_fp32_layers={len(keep_fp32)}')
print(f'extra_storage_bits={mixed_bits - all_int4_bits}')
print(f'mixed_between_int4_and_fp32={all_int4_bits < mixed_bits < all_fp32_bits}')
预期输出
tested_layers=3
all_errors_nonnegative=True
selected_fp32=<LAYER>
selected_fp32_layers=1
extra_storage_bits=<BITS>
mixed_between_int4_and_fp32=True
具体层名和额外 bit 数由本次误差排序决定;在真实模型中还会随权重、校准数据和量化方式变化。这里最重要的是测试过程始终只改一个候选层,因此误差能够归因到该层,而混合精度成本也能直接从参数量和位宽计算出来。
哪些位置应该优先检查
输入附近的投影层会直接改变后续所有特征,因此误差可能被层层传播;输出投影或分类头直接决定最终 logits,小幅数值偏差也可能改变排序。它们值得优先测试,但不能未经测量就永久保留 FP32。
LayerNorm、RMSNorm 等归一化模块通常参数量很小,却包含均值、方差或归一化缩放等对数值范围敏感的计算。在许多部署方案中,让归一化计算继续使用 FP16、BF16 或 FP32,只牺牲很少的压缩收益,却能降低数值风险。具体是否需要如此仍应以目标硬件和端到端验证为准。
把精度收益和混合精度代价放在一起
保留高精度层会同时增加权重存储、显存占用和潜在的类型转换开销。对于包含 n 个参数的层,从 INT4 改回 FP32,相比纯 INT4 会为每个参数额外增加 28 bit;如果只保留参数量很小的敏感模块,成本通常可控,但保留大型矩阵时压缩比会迅速下降。
因此不要按照“误差最大的若干层”机械地全部回退。更实用的做法是从误差最高的层开始逐个恢复高精度,每次重新执行端到端任务评估,并记录模型大小、峰值显存和推理延迟。当任务指标已经回到目标阈值时停止增加高精度层。
避免把逐层误差当成最终答案
单层消融只能估计局部敏感度。多个低比特层同时存在时,误差可能相互放大,也可能被后续归一化或残差结构部分抵消,因此逐层排名不能直接预测最终混合精度模型的质量。
生产方案应把逐层测试作为搜索起点:先筛出敏感候选,再生成少量混合精度组合,最后使用真实量化后端执行端到端精度、显存和延迟验证。只有同时满足任务指标和部署预算的组合,才是真正可上线的高低精度边界。