
大模型原理与训练 / 系统课时
用 vLLM 启动 GPU 量化服务
用 vLLM 启动 GPU 量化服务
完成模型包预检后,下一步是让量化权重真正进入 GPU,并通过服务接口完成一次生成。本节以 AWQ 模型为例,用 vLLM 启动 OpenAI 兼容服务,同时记录启动日志、加载前后显存并验证 HTTP 请求;GPTQ 模型只应换成与其权重匹配的量化方式。
学习目标
- 用 vLLM 在指定 GPU 上启动 AWQ 或 GPTQ 量化模型
- 记录服务启动日志与加载前后显存,判断模型是否真正进入 GPU
- 通过一次 HTTP 生成请求验证模型名、接口与生成链路
明确启动链路
一次最小可验收部署包含四个对象:量化模型目录、vLLM API 服务、GPU 和调用端。服务先读取模型元数据并加载量化权重,健康检查通过后才接受生成请求;显存采样和日志文件则提供“确实加载成功”的两条证据。
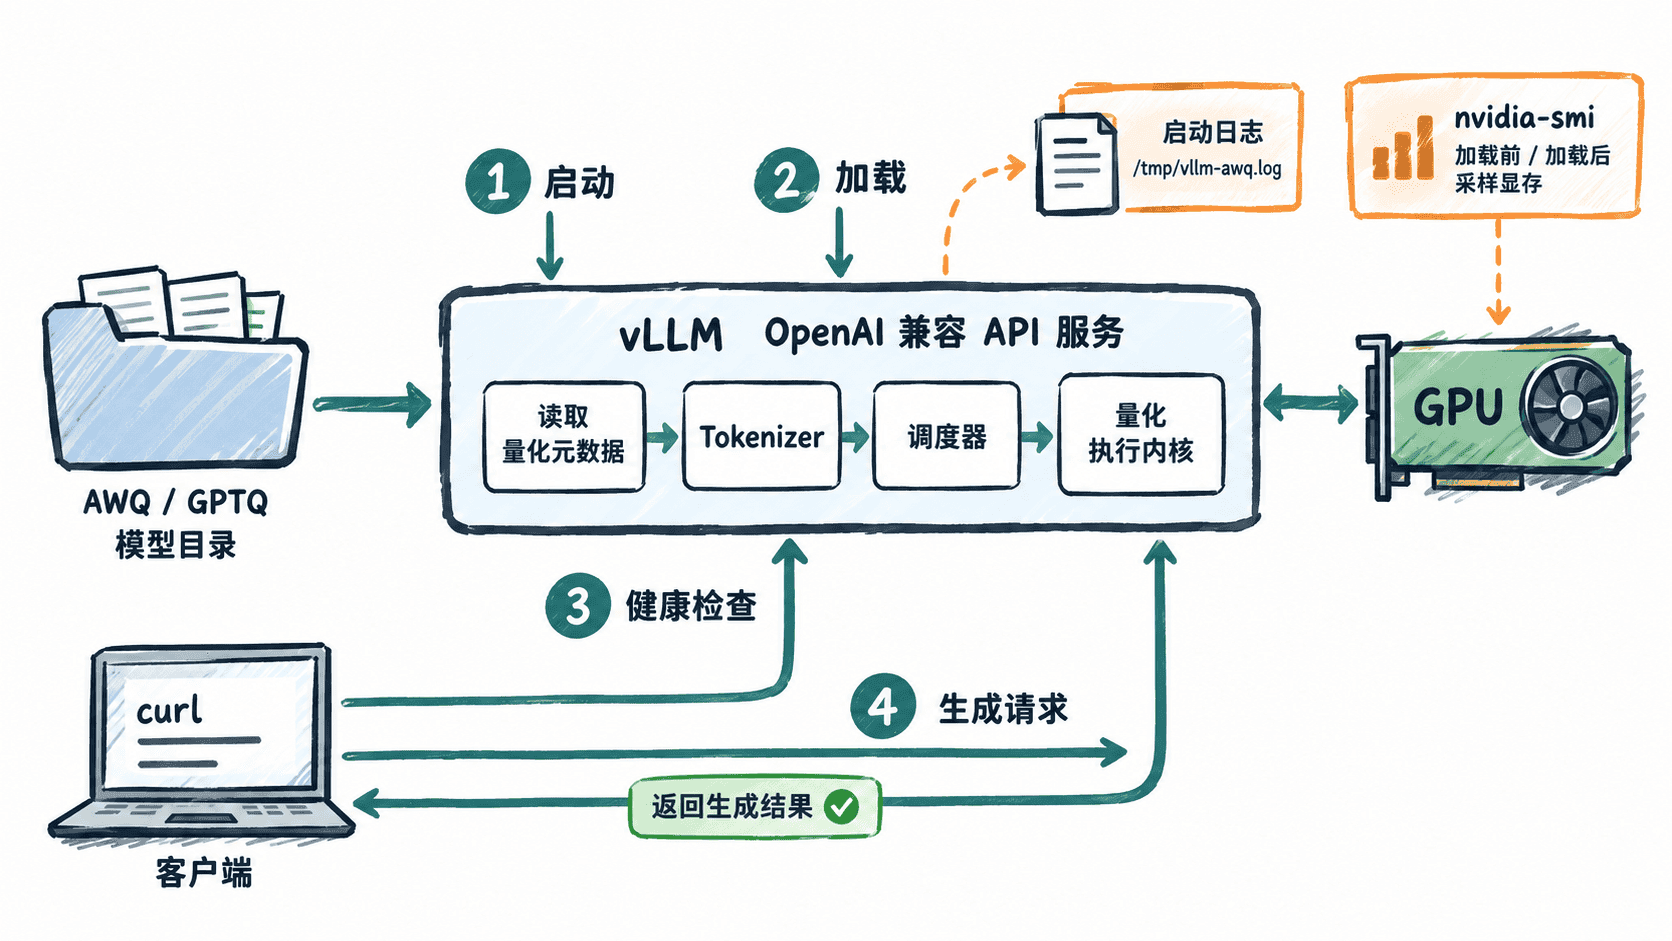
AWQ 示例显式使用 --quantization awq,这样排障时不会把“自动识别失败”和“权重本身不兼容”混在一起。若模型实际是 GPTQ,必须使用与该检查点匹配的 GPTQ 加载方式;不能只改参数名就把 AWQ 权重当成 GPTQ。
启动服务并记录显存
下面脚本假设机器已安装可用的 NVIDIA 驱动、CUDA 兼容的 vLLM,以及一个本地 AWQ 模型。它把服务日志持久写入 /tmp/vllm-awq.log,等待健康检查通过,再采样同一张 GPU 的显存并发起一次生成请求。示例端口是 8000,实际环境可通过 PORT 改成 <PORT>。
set -euo pipefail

MODEL_DIR="${MODEL_DIR:-/models/llama-awq}"
GPU_INDEX="${GPU_INDEX:-0}"
PORT="${PORT:-8000}"
LOG="${LOG:-/tmp/vllm-awq.log}"

command -v vllm >/dev/null
command -v nvidia-smi >/dev/null
test -d "$MODEL_DIR"

before=$(nvidia-smi -i "$GPU_INDEX" --query-gpu=memory.used --format=csv,noheader,nounits)

nohup env CUDA_VISIBLE_DEVICES="$GPU_INDEX"   vllm serve "$MODEL_DIR"   --served-model-name quantized-llm   --quantization awq   --dtype half   --host 127.0.0.1   --port "$PORT"   >"$LOG" 2>&1 &

pid=$!
echo "$pid" > /tmp/vllm-awq.pid

ready=0
for _ in $(seq 1 120); do
  if curl -fsS "http://127.0.0.1:${PORT}/health" >/dev/null; then
    ready=1
    break
  fi
  if ! kill -0 "$pid" 2>/dev/null; then
    echo "vLLM exited early; inspect $LOG"
    exit 1
  fi
  sleep 1
done

if [ "$ready" -ne 1 ]; then
  echo "health check timed out; inspect $LOG"
  exit 1
fi

after=$(nvidia-smi -i "$GPU_INDEX" --query-gpu=memory.used --format=csv,noheader,nounits)
delta=$((after - before))

http_code=$(curl -sS   -o /tmp/vllm-response.json   -w '%{http_code}'   "http://127.0.0.1:${PORT}/v1/completions"   -H 'Content-Type: application/json'   -d '{"model":"quantized-llm","prompt":"用一句话说明量化模型部署的主要收益。","max_tokens":32,"temperature":0}')

python - "$http_code" <<'PY'
import json
import sys

status = int(sys.argv[1])
payload = json.load(open("/tmp/vllm-response.json", encoding="utf-8"))
choices = payload.get("choices", [])
text = choices[0].get("text", "") if choices else ""

print(f"http_status={status}")
print(f"model={payload.get('model')}")
print(f"choice_count={len(choices)}")
print(f"text_nonempty={bool(text.strip())}")
PY

printf 'gpu_memory_before_mib=%s\n' "$before"
printf 'gpu_memory_after_mib=%s\n' "$after"
printf 'gpu_memory_delta_mib=%s\n' "$delta"
printf 'server_pid=%s\n' "$pid"
printf 'startup_log=%s\n' "$LOG"
预期输出的固定判据如下;显存、进程 ID 等动态值会因机器和模型不同而变化。
http_status=200
model=quantized-llm
choice_count=1
text_nonempty=True
gpu_memory_before_mib=<MiB>
gpu_memory_after_mib=<MiB>
gpu_memory_delta_mib=<MiB>
server_pid=<ID>
startup_log=/tmp/vllm-awq.log
用日志和显存判断是否真的成功
HTTP 200 只能证明接口返回成功,还要结合日志与显存确认加载路径。gpu_memory_delta_mib 应体现模型与运行时占用了额外显存;如果同一 GPU 上已有其他进程,这个差值只是粗略观测,不应直接当成模型权重大小。
启动失败时先查看 /tmp/vllm-awq.log 的最后几十行,再回到模型元数据核对量化方式。若日志提示量化格式、模型架构或内核不受支持,应更换兼容的检查点或 vLLM 环境,而不是继续调大显存利用率;若是 OOM,再考虑缩短最大上下文、降低并发或换用显存更大的 GPU。
切换到 GPTQ 时不要混用格式
GPTQ 部署的核心变化是“模型本身必须是 GPTQ 检查点,并使用与之匹配的量化加载方式”。最容易犯的错误,是拿同一个 AWQ 目录只把启动参数改成 GPTQ;这不会完成格式转换,反而会让加载器按错误布局解释权重。
服务验收至少要同时满足:健康检查通过、生成接口返回 200、返回模型名正确、生成文本非空、日志中没有导致进程退出的异常。满足这组条件后,才值得继续做并发、吞吐、首 Token 延迟和更长期的稳定性压测。