
大模型原理与训练 / 系统课时
识别异常值造成的量化误差
识别异常值造成的量化误差
异常值会把量化范围拉得很宽,使大量正常权重或激活只能挤在少数整数码值上。本节用一个可运行例子观察 Scale、码值利用率和重建误差的变化,再判断裁剪、分组量化与敏感层保留高精度分别适合什么情况。
学习目标
- 解释极端权重或激活为什么会放大量化误差
- 用重建误差比较异常值处理前后的量化效果
- 根据异常值分布选择裁剪、分组或混合精度策略
异常值为什么会浪费整数码值
以对称 INT8 量化为例,若一个张量共用同一个 Scale,通常会用绝对值最大的元素确定量化范围。只要出现一个远大于其余元素的异常值,Scale 就会变大,而靠近零的正常值只能映射到很少几个整数。
例如大部分权重位于 -0.2 到 0.2,但其中一个值达到 8.0。为了让 8.0 不溢出,INT8 的 127 个正码值必须覆盖到 8,正常权重之间原本细小的差异就容易被舍入掉。
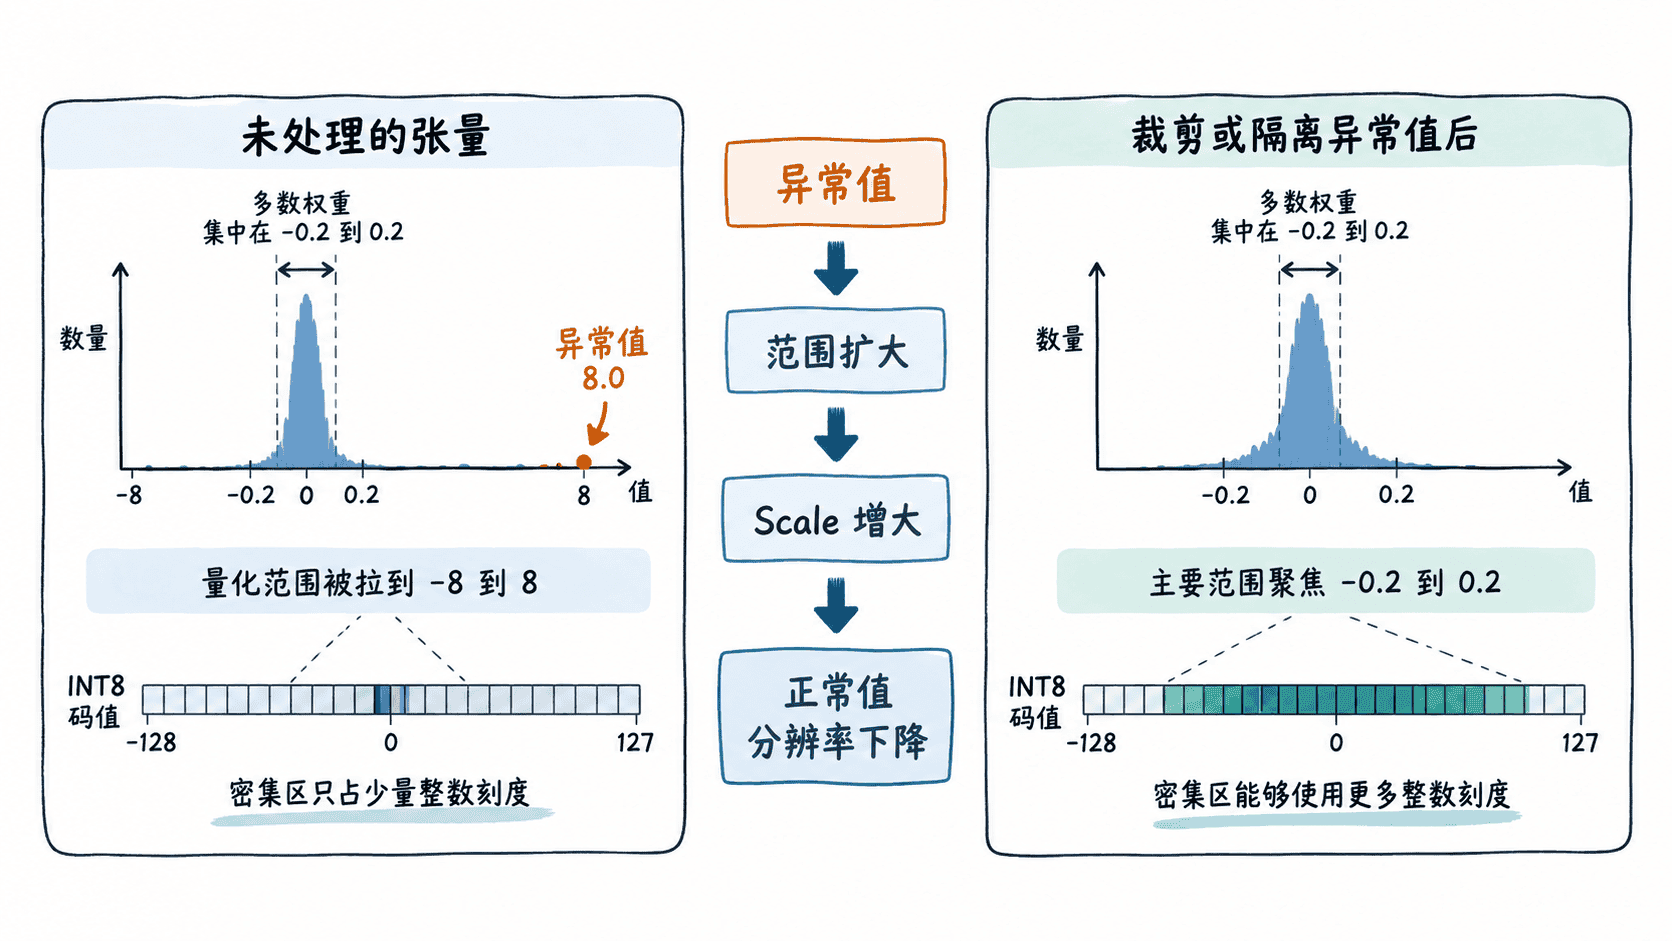
下面直接模拟量化再反量化,并只统计前五个正常值的均方误差。裁剪后的异常值会失真,但正常值获得了更细的量化分辨率。
weights = [0.12, -0.09, 0.05, -0.18, 0.15, 8.0]

def quant_dequant(values, clip=None):
    bound = max(abs(x) for x in values) if clip is None else clip
    scale = bound / 127
    codes, restored = [], []

    # 先限制范围,再执行对称 INT8 量化与反量化。
    for x in values:
        clipped = max(-bound, min(bound, x))
        q = max(-127, min(127, round(clipped / scale)))
        codes.append(q)
        restored.append(q * scale)
    return scale, codes, restored

def mse(actual, restored):
    return sum((a - b) ** 2 for a, b in zip(actual, restored)) / len(actual)

for name, clip in [('baseline', None), ('clipped', 0.2)]:
    scale, codes, restored = quant_dequant(weights, clip)
    inlier_error = mse(weights[:5], restored[:5])
    print(f'{name} scale={scale:.6f} codes={codes} inlier_mse={inlier_error:.8f}')
预期输出
baseline scale=0.062992 codes=[2, -1, 1, -3, 2, 127] inlier_mse=0.00031827
clipped scale=0.001575 codes=[76, -57, 32, -114, 95, 127] inlier_mse=0.00000014
这里的关键不是裁剪一定更好,而是异常值处理改变了误差分配:未处理时保护了 8.0,却牺牲大量普通值;裁剪后普通值更准确,但 8.0 被截断到 0.2。真实模型需要用最终任务指标判断这笔交换是否值得。
根据异常值形态选择缓解策略
| 策略 | 适合的异常值形态 | 主要代价 |
|---|---|---|
| 裁剪 | 极少数尖峰明显偏离主体分布 | 被裁剪元素产生饱和误差 |
| 分组量化 | 异常值集中在少数通道或局部权重组 | Scale 数量增加,内核实现更复杂 |
| 敏感层保留高精度 | 少数层量化后任务质量明显下降 | 显存和计算节省低于全量低精度 |
裁剪阈值不能只看单个张量截图。权重量化可以统计各层的分布和重建误差;激活量化还要使用有代表性的校准数据,因为异常激活可能只在某些输入长度、主题或格式下出现。
分组量化的核心是缩小共享 Scale 的范围。例如一个通道包含异常值时,不必让整个大矩阵都共享它的 Scale,而可以让较小的组分别确定范围。组越小通常越能隔离异常值,但元数据、反量化开销和硬件内核支持也更重要。
用误差定位真正的敏感位置
不要只根据最大值决定策略。先记录各层量化前后的重建误差或相似度,再用留出数据运行完整模型,确认误差是否传导到最终质量指标。某层数值误差较大但任务指标稳定时,没有必要立即恢复高精度。
如果质量下降集中在少数层,可以让这些层继续使用 FP16 或 BF16,其余层保持 INT8 或更低精度。这样通常比为了几个异常层而整体提高精度更经济。
最后还要在目标硬件上验证吞吐和延迟。更细的分组虽然可能降低误差,但如果部署引擎缺少对应高效内核,理论上的精度收益可能换来明显的推理性能损失。异常值处理的最终目标,是在任务质量、模型体积和真实硬件性能之间找到可验证的平衡点。