
大模型原理与训练 / 系统课时
判断权重与激活该量化到几位
判断权重与激活该量化到几位
位宽选择不能只看“模型能不能压得更小”。Weight-Only 主要降低权重读取带宽,Weight-Activation 还要求激活与矩阵乘算子共同支持低精度。本文把 BF16、INT8 与 INT4 拆开判断,给出从精度、带宽、算力到 Kernel 支持的选择顺序。
学习目标
- 区分 Weight-Only 与 Weight-Activation 量化的收益来源
- 判断 BF16、INT8、INT4 对带宽、算力和误差的影响
- 根据硬件与算子支持选择可落地的位宽组合
先区分 Weight-Only 和 Weight-Activation
Weight-Only 只压缩权重,激活仍以 BF16 或 FP16 等高精度参与计算。它最直接的收益是减少权重显存与读取带宽,常用于大模型解码阶段,因为此时单 token 推理经常更受内存带宽限制。
Weight-Activation 则进一步把激活也量化到 INT8 等低精度,使矩阵乘可以进入整数或混合精度 Tensor Core 路径。收益可能更大,但校准更难,异常激活也更容易造成精度损失,且必须有端到端 Kernel 支持。
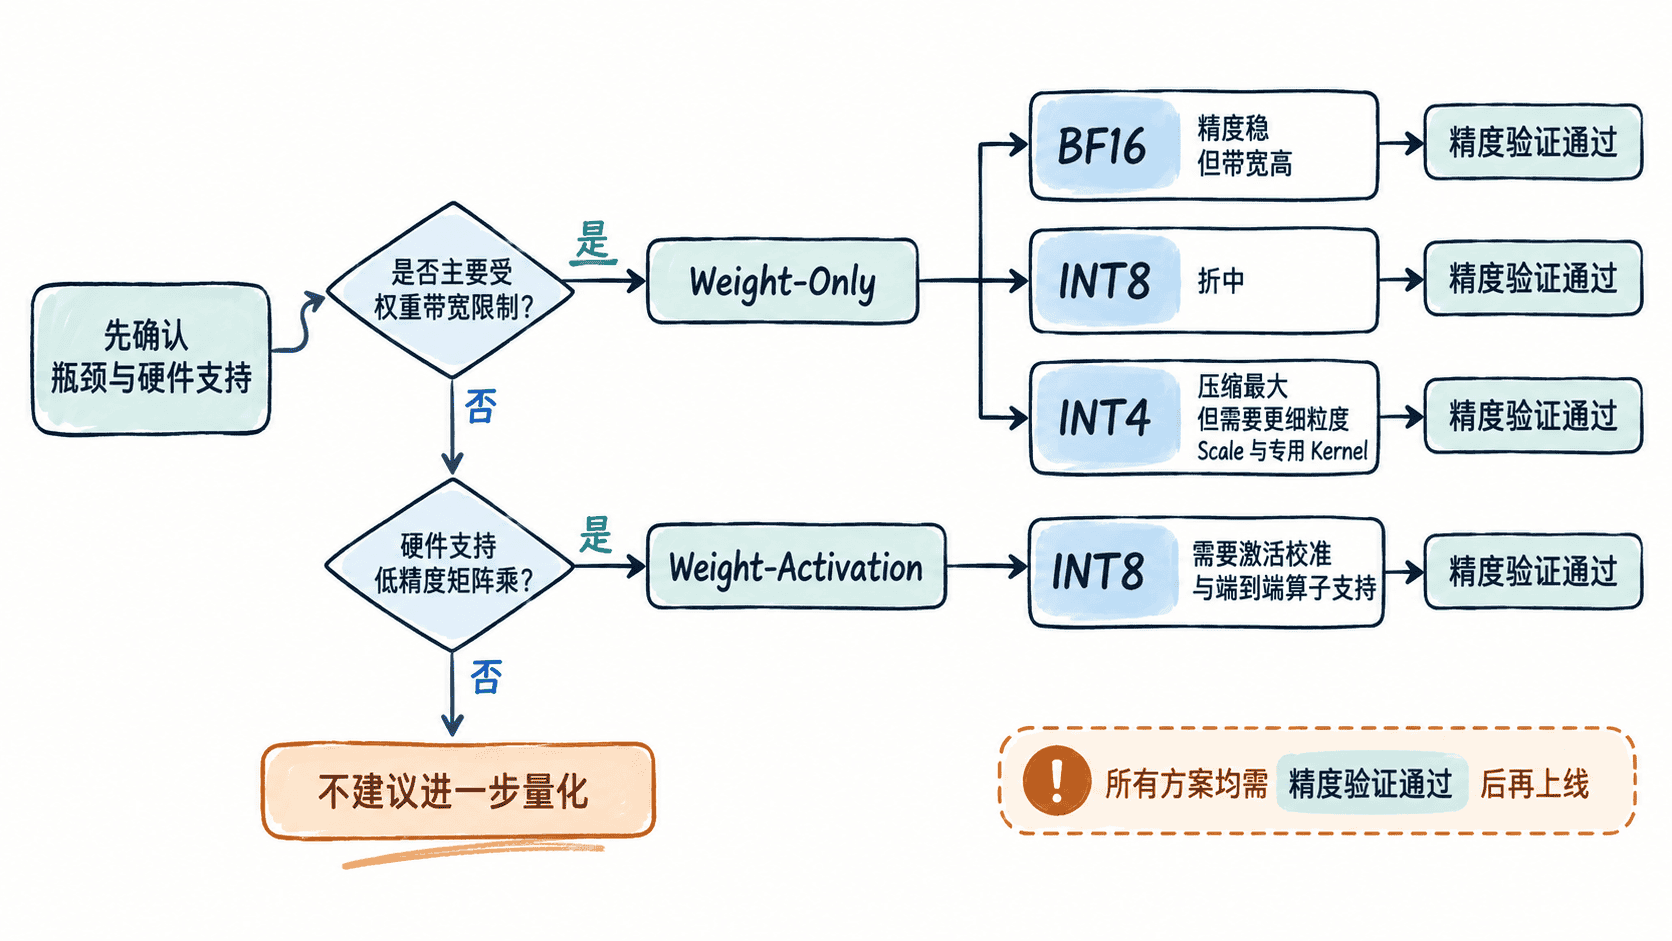
两者最容易混淆的地方是:权重从 BF16 压到 INT4,并不代表矩阵乘就变成纯 INT4 运算。很多 Weight-Only Kernel 会在计算过程中按组反量化权重,再与高精度激活做混合计算。
BF16、INT8 和 INT4 各自解决什么问题
BF16 的优势是动态范围大、工程风险低,适合精度敏感、硬件带宽充足或后端缺少高效量化 Kernel 的场景。它通常是量化实验的基准线,而不是“失败后的退路”。
INT8 把权重体积大致降到 BF16 的一半;如果权重和激活都能进入高效 INT8 Kernel,还能同时获得带宽和算力收益。它常是生产部署里最稳健的量化档位。
INT4 进一步把权重体积压到 BF16 的约四分之一,尤其适合参数量大、解码阶段受显存带宽限制的模型。但 4 bit 的可表示级数更少,通常需要 Group-Wise、异常值处理或量化感知方法来控制误差。
用瓶颈决定是否继续降位宽
选择位宽时先判断当前瓶颈。如果模型连 BF16 权重都放不进显存,INT8 或 INT4 的容量收益就是硬约束;如果模型已经能放下,但解码吞吐受 HBM 带宽限制,Weight-Only INT4 往往值得优先验证。
如果工作负载更偏 Prefill,大批量矩阵乘占比高,算力而不是带宽可能成为主要瓶颈。这时仅压权重未必带来等比例提速,Weight-Activation INT8 只有在目标 GPU、推理框架和关键算子都能走高效低精度 Kernel 时才有意义。
| 方案 | 权重占用 | 激活量化 | 典型收益 | 主要风险 |
|---|---|---|---|---|
| BF16 | 高 | 否 | 精度稳定、兼容性最好 | 显存和带宽压力大 |
| INT8 Weight-Only | 中 | 否 | 降低权重带宽 | 加速受 Kernel 与反量化开销影响 |
| INT8 W-A | 中 | 是 | 同时利用带宽与整数算力 | 校准和算子覆盖要求高 |
| INT4 Weight-Only | 最低 | 否 | 大幅降低显存与解码带宽 | 误差更敏感,依赖专用 Kernel |
按支持矩阵做最终决定
生产选择可以遵循一个简单顺序:先保留 BF16 基线,再验证 INT8;只有当容量或带宽仍不满足目标时,再下探 INT4。每下降一个位宽,都要重新测任务质量、首 token 延迟、每 token 延迟、吞吐与峰值显存,不能只看模型文件大小。
最终目标不是追求最低位宽,而是找到满足质量阈值的最低可用精度。对多数部署任务,BF16 是稳定基线,INT8 是常见折中,INT4 则更适合显存或带宽压力明显、且后端已有成熟 Weight-Only Kernel 的场景。