
大模型原理与训练 / 系统课时
用 GPTQ 完成离线权重量化
用 GPTQ 完成离线权重量化
GPTQ 适合“模型已经训练好、上线前再压缩”的场景。本节用一份小型校准集完成 4 位权重量化,理解它为何利用二阶信息近似来补偿量化误差,并把结果保存成可由 GPTQ 感知型推理后端重新加载的目录。
学习目标
- 解释 GPTQ 如何借助校准激活和 Hessian 近似降低逐步量化误差
- 使用
GPTQConfig完成 4 位分组量化并导出模型 - 根据
group_size、damp_percent、desc_act和目标后端做工程取舍
GPTQ 在优化什么
普通权重量化通常只关心“量化后的权重离原权重有多远”,但同样大小的权重误差,对模型输出的影响可能完全不同。GPTQ 会让一批代表性文本通过模型,收集层输入,并用输入协方差构造二阶敏感度的近似;量化某一列权重后,再利用剩余自由度补偿已经引入的输出误差。
可以把目标理解为:不是单独最小化权重差,而是尽量减小校准输入下的层输出变化。工程实现不会显式构造整个大模型的完整 Hessian,而是在逐层、逐组量化时使用可计算的二阶近似和阻尼项。
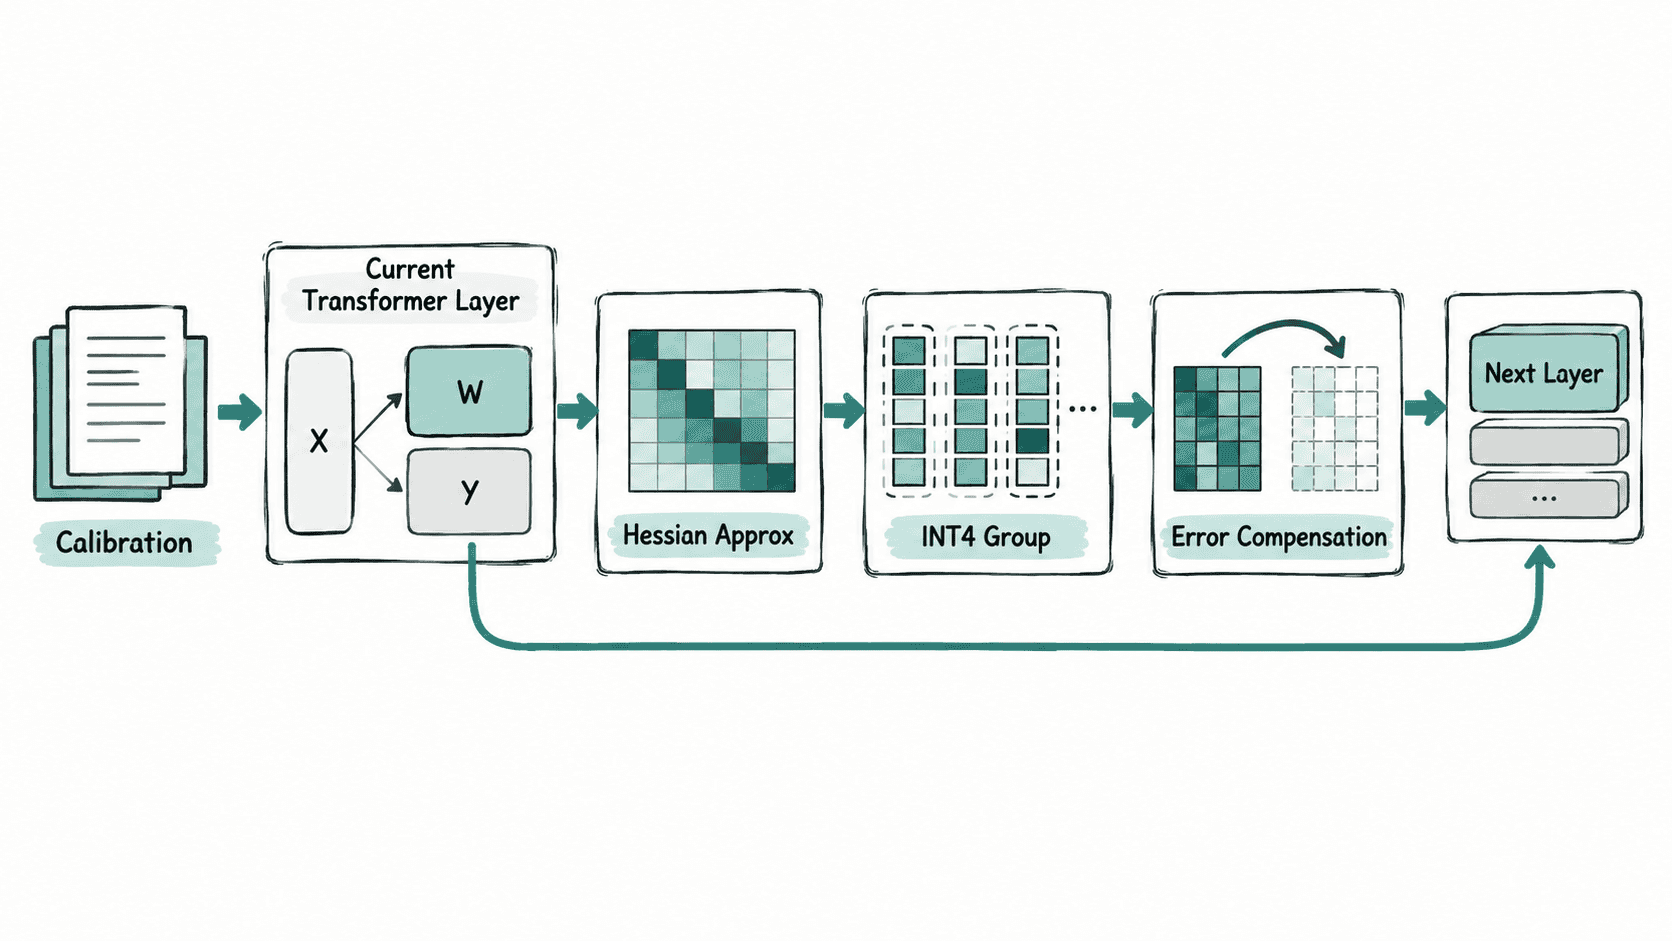
完成一次 4 位离线量化
准备支持当前模型与硬件的 transformers、accelerate、optimum 和 gptqmodel 环境。下面用较小的 facebook/opt-125m 演示完整路径;真实项目应把 calibration_data 换成与线上请求长度、语言和任务分布接近的文本。
from pathlib import Path

from transformers import AutoModelForCausalLM, AutoTokenizer, GPTQConfig

model_id = "facebook/opt-125m"
output_dir = Path("./opt-125m-gptq")

tokenizer = AutoTokenizer.from_pretrained(model_id)
calibration_data = [
    "Quantization reduces model memory while trying to preserve output quality.",
    "A useful calibration set should resemble the prompts seen in production.",
    "Grouped weight quantization trades metadata overhead for lower quantization error.",
]

gptq_config = GPTQConfig(
    bits=4,
    dataset=calibration_data,
    tokenizer=tokenizer,
    group_size=128,
    damp_percent=0.1,
    desc_act=False,
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    quantization_config=gptq_config,
)

# 若量化时发生过设备切分,保存前统一移到 CPU,避免留下分片设备状态。
model.to("cpu")
model.save_pretrained(output_dir)
tokenizer.save_pretrained(output_dir)

print(f"saved: {output_dir}")
预期输出
saved: opt-125m-gptq量化过程本身可能打印进度条或后端日志,具体内容会随版本和硬件变化;验收时只需要确认脚本正常结束,并且输出目录包含模型配置、分词器文件和量化权重文件。
调参数时先看工程含义
bits=4 决定主要权重使用 4 位表示;位宽越低,压缩越强,但可表达的量化等级越少。group_size=128 表示每 128 个权重共享一组量化参数,较小分组通常更容易控制误差,却会增加 scale/zero-point 等元数据和部分内核开销。
damp_percent 给二阶矩阵加入阻尼,核心作用是提高数值稳定性;它不是“质量越大越好”的旋钮。desc_act 也称 act-order,开启后会优先处理激活更显著的列,可能改善困数量化质量,但会改变某些内核的兼容性或推理效率,因此必须和目标后端一起验证。
导出后先验证兼容性
GPTQ 并不是单一文件格式的同义词。当前工具链可能区分 GPTQ 格式版本、对称或非对称量化,以及 Marlin 等推理内核;一个目录能够被 transformers 保存,不代表任意推理引擎都能直接加载。
上线前至少做三项检查:确认 config.json 中记录了 GPTQ 量化配置;用目标推理后端真正加载一次,而不是只看文件是否存在;对固定验证集比较量化前后困惑度、任务指标或业务回归集,并同时记录显存与吞吐。只有“能加载、质量过线、性能有收益”同时成立,这份 GPTQ 模型才算可交付。