
大模型原理与训练 / 系统课时
识别蒸馏与量化适用边界
识别蒸馏与量化适用边界
这节课解决一个上线前最容易做错的决策:模型变慢或显存不够时,究竟该蒸馏、直接量化、做量化感知训练,还是根本不该压缩。你将从质量、显存、吞吐、硬件和训练预算出发,得到一套可执行的选择边界。
学习目标
- 区分蒸馏、训练后量化与量化感知训练分别改变了什么。
- 根据质量、显存、吞吐和训练成本选择压缩路线。
- 识别压缩收益很小或质量风险过高时应保留原模型的情况。
先把上线约束变成决策条件
压缩不是目标,满足上线约束才是目标。开始前至少明确四个量:允许的质量下降、单实例显存上限、目标吞吐或延迟,以及可使用的训练资源。若连这些边界都没有,任何“压缩率更高”的结论都缺少业务意义。
| 方法 | 主要改变 | 是否需要训练 | 典型收益 | 主要风险 |
|---|---|---|---|---|
| 蒸馏 | 用教师模型训练更小的学生模型 | 是 | 参数量、计算量和显存同时下降 | 学生容量不足会损失能力,训练数据质量决定上限 |
| 训练后量化 PTQ | 将已训练权重或激活映射到更低精度 | 通常否,仅需校准或量化处理 | 改造快,显存和模型体积下降明显 | 某些层对低精度敏感,质量可能突然恶化 |
| 量化感知训练 QAT | 训练时模拟量化误差,再导出低精度模型 | 是 | 在低比特目标下通常比 PTQ 更容易保住质量 | 训练成本高,部署端还必须支持对应量化格式与算子 |
三种路线分别解决什么问题
蒸馏适合“原模型计算量本身太大”的情况。它不仅改变数值精度,还会改变模型容量,因此有机会从根本上减少参数、计算量和推理时延。代价是要重新训练学生模型,并接受学生模型能力上限可能低于教师模型的事实。
PTQ适合“模型结构可以保留,但存储或显存需要快速下降”的情况。它通常不要求重新训练,最适合先做低成本试验。若目标硬件具备成熟的 INT8、INT4 或权重量化内核,PTQ 还可能带来吞吐提升;没有对应内核时,模型虽然更小,速度却未必更快。
QAT适合“PTQ 已经压到目标位宽,但质量损失超过预算”的情况。训练过程让模型提前适应量化误差,因此能换回一部分质量,不过它不会自动解决硬件不支持的问题,也不能保证所有任务都恢复到原模型水平。
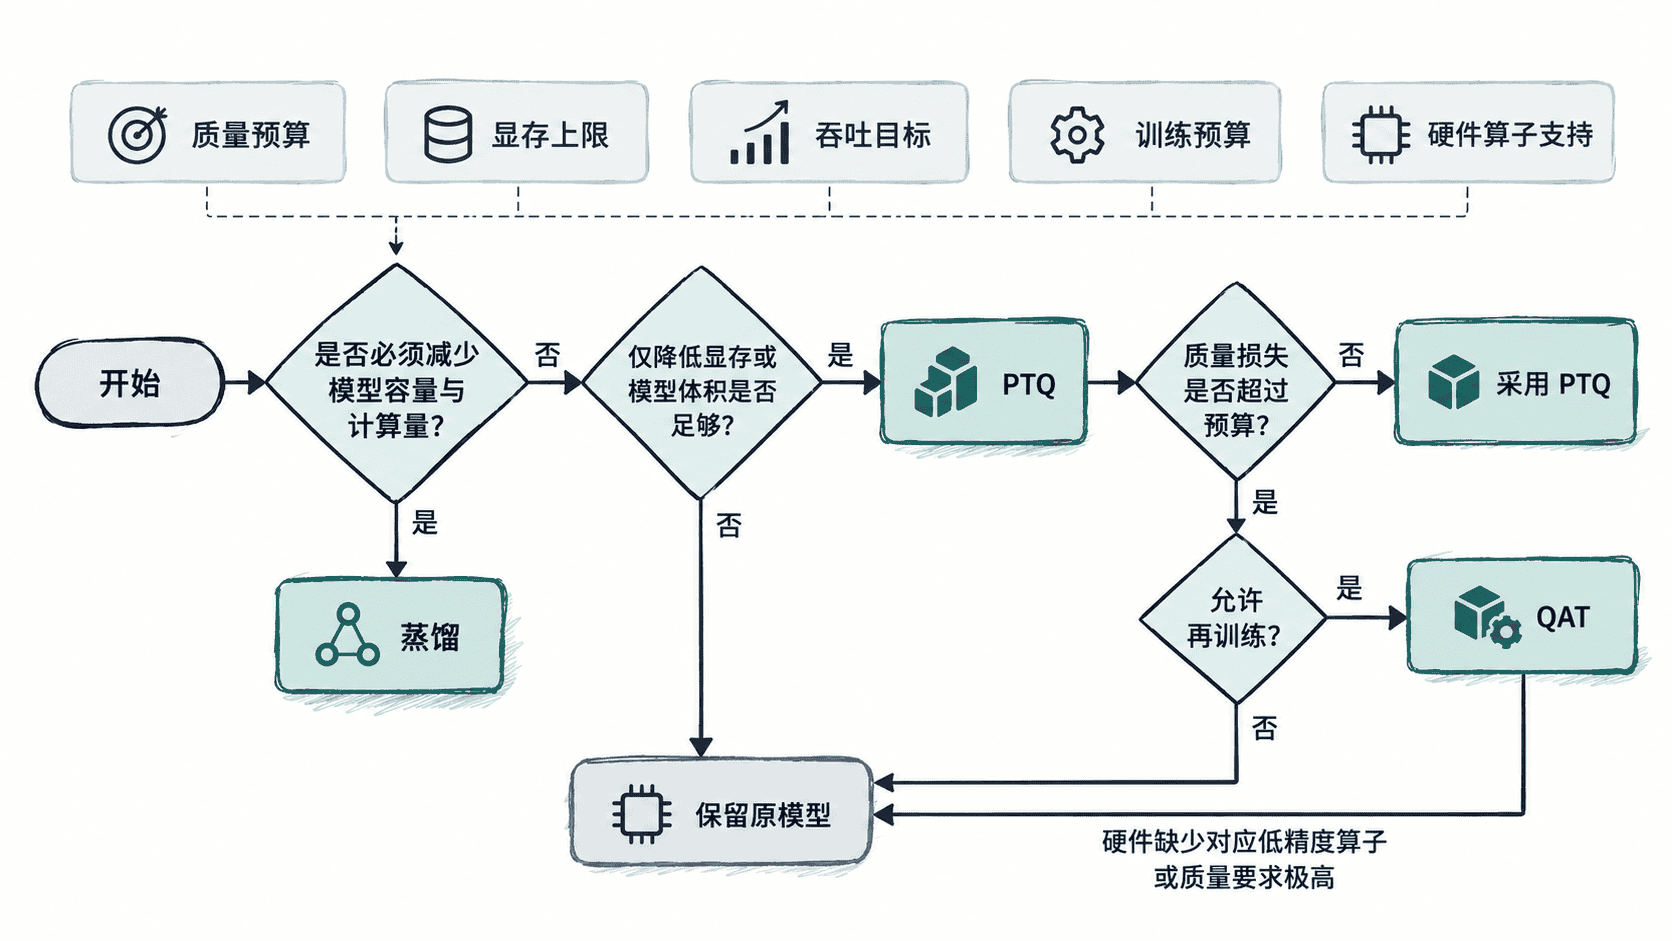
用上线约束做最终选择
可以按“先便宜、后昂贵”的顺序试验:如果只是显存超限,先测 PTQ;若 PTQ 达不到质量线,再判断是否值得投入 QAT;如果目标设备连原模型计算量都承受不了,单纯量化往往不够,应考虑蒸馏或直接选择更小的基础模型。
什么时候应保留原模型
当原模型已经满足显存和延迟目标、请求量很低且硬件富余,压缩带来的工程复杂度可能大于成本收益。对于高风险任务,如果允许的质量下降接近零,而蒸馏或量化没有稳定通过回归测试,也应优先保留原模型。
另一个常见边界是部署链路不支持目标格式。例如量化工具能导出 INT4 权重,但线上推理引擎会回退到高精度算子,这时只增加了转换和维护成本。最终决策应以同一评测集和同一硬件上的质量、峰值显存、首 Token 延迟与吞吐实测为准,而不是以压缩方法的理论优势为准。