
大模型原理与训练 / 系统课时
用 SFT 预热学生模型
用 SFT 预热学生模型
软标签蒸馏之前,学生模型如果连输出格式和基本任务行为都不稳定,后续蒸馏信号很容易被噪声淹没。本节用一个最小因果语言模型 SFT 流程先学习教师回答,并保留训练前后的损失与固定评测输出作为对照。
学习目标
- 理解 SFT 预热在蒸馏流程中的职责和停止条件
- 正确构造“提示不计损失、教师回答计损失”的因果语言模型标签
- 记录训练前后损失、固定评测输出和可复用检查点
预热只解决基本行为
SFT 预热的目标不是把学生模型一次训练到最终质量,而是先消除最明显的行为差距:回答格式不稳定、指令跟随失败、固定字段缺失或经常输出无关内容。达到这个起点后,再引入教师 logits、偏好分数或其他软信号,优化过程通常更稳定。
必须保留预热前的基线结果。至少记录相同数据上的监督损失,以及一组固定评测提示的原始生成结果。否则即使训练后感觉“更像教师”,也无法判断变化来自 SFT、解码参数还是评测提示本身。
把教师回答转换成监督标签
因果语言模型通常把“提示 + 教师回答”拼成一个序列,但损失只计算教师回答部分。提示 token 的标签应设为 -100,让 PyTorch 的交叉熵忽略它们;补齐产生的 padding token 同样需要屏蔽。
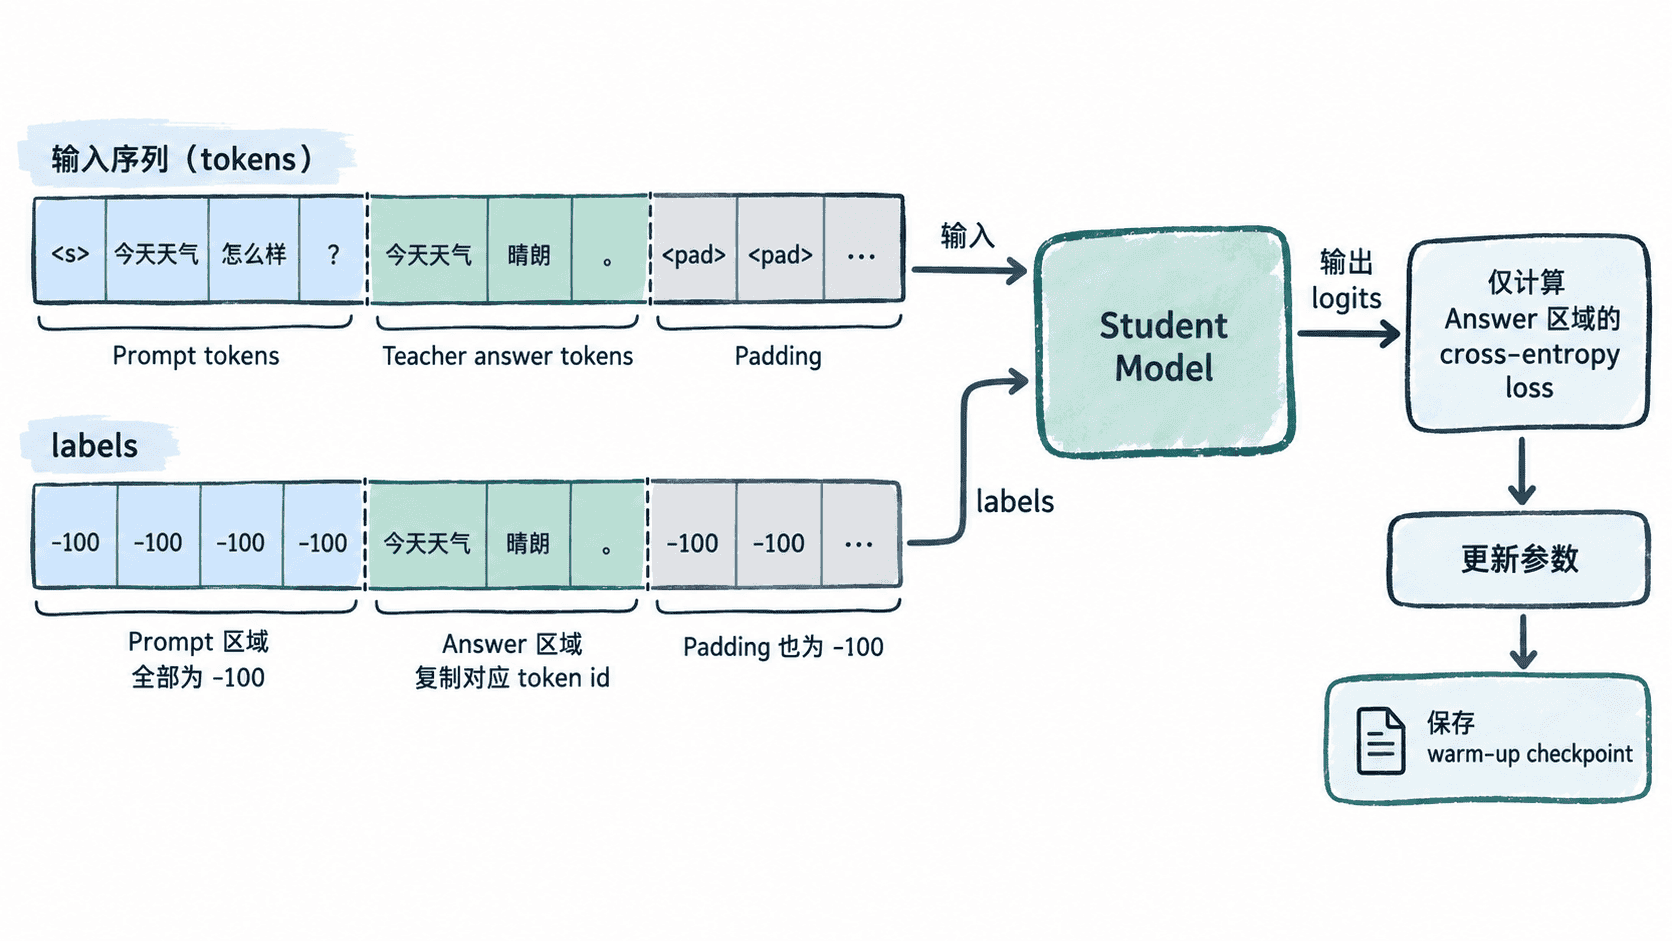
这个遮罩很关键。如果提示部分也参与损失,模型会花容量去复述输入,而不是集中学习教师回答的格式和任务行为。对聊天模型还应先使用目标学生模型自己的 chat template,再计算回答起点,避免手工拼接特殊 token。
运行最小 SFT 并保存对照
下面的示例默认使用一个很小的公开 GPT-2 测试模型,只用于验证 SFT 数据管线;真实项目应把 STUDENT_MODEL 指向你的学生模型或本地检查点。示例会先记录基线损失和固定提示输出,再训练若干轮,最后保存同一评测提示的训练后输出、损失与 checkpoint。需要预先安装 torch 和 transformers。
import json
import os
import random

import torch
from torch.nn.utils.rnn import pad_sequence
from torch.utils.data import DataLoader
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = os.getenv("STUDENT_MODEL", "sshleifer/tiny-gpt2")
OUTPUT_DIR = "student-sft-warmup"
COMPARISON_PATH = "sft_comparison.json"
SEED = 20260913
EVAL_PROMPT = "Question: classify 'password reset fails' as billing, technical, or other.\nAnswer:"

SAMPLES = [
    ("Question: classify 'cannot log in' as billing, technical, or other.\nAnswer:",
     " technical"),
    ("Question: classify 'charged twice' as billing, technical, or other.\nAnswer:",
     " billing"),
    ("Question: classify an empty message as billing, technical, or other.\nAnswer:",
     " other"),
]

random.seed(SEED)
torch.manual_seed(SEED)

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

model = AutoModelForCausalLM.from_pretrained(MODEL_ID)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)

def encode_sample(prompt: str, answer: str) -> dict[str, torch.Tensor]:
    prompt_ids = tokenizer(prompt, add_special_tokens=False)["input_ids"]
    full_ids = tokenizer(
        prompt + answer + tokenizer.eos_token,
        add_special_tokens=False,
        truncation=True,
        max_length=128,
    )["input_ids"]
    input_ids = torch.tensor(full_ids, dtype=torch.long)
    labels = input_ids.clone()
    # 只让教师回答区域参与监督损失。
    labels[: min(len(prompt_ids), len(labels))] = -100
    return {"input_ids": input_ids, "labels": labels}

encoded = [encode_sample(prompt, answer) for prompt, answer in SAMPLES]

def collate(batch):
    lengths = [len(x["input_ids"]) for x in batch]
    input_ids = pad_sequence(
        [x["input_ids"] for x in batch],
        batch_first=True,
        padding_value=tokenizer.pad_token_id,
    )
    labels = pad_sequence(
        [x["labels"] for x in batch],
        batch_first=True,
        padding_value=-100,
    )
    # 由真实长度构造 mask,避免把序列末尾的真实 EOS 当成 padding。
    attention_mask = torch.zeros_like(input_ids)
    for row, length in enumerate(lengths):
        attention_mask[row, :length] = 1
    return {
        "input_ids": input_ids.to(device),
        "labels": labels.to(device),
        "attention_mask": attention_mask.to(device),
    }

loader = DataLoader(encoded, batch_size=3, shuffle=True, collate_fn=collate)

def evaluate_loss() -> float:
    model.eval()
    losses = []
    with torch.no_grad():
        for batch in loader:
            losses.append(model(**batch).loss.item())
    return sum(losses) / len(losses)

def generate_text(prompt: str) -> str:
    model.eval()
    batch = tokenizer(prompt, return_tensors="pt").to(device)
    with torch.no_grad():
        output = model.generate(
            **batch,
            max_new_tokens=12,
            do_sample=False,
            pad_token_id=tokenizer.eos_token_id,
        )
    generated = output[0, batch["input_ids"].shape[1]:]
    return tokenizer.decode(generated, skip_special_tokens=True)

before_loss = evaluate_loss()
before_text = generate_text(EVAL_PROMPT)
optimizer = torch.optim.AdamW(model.parameters(), lr=5e-4)

model.train()
for _ in range(20):
    for batch in loader:
        optimizer.zero_grad()
        loss = model(**batch).loss
        loss.backward()
        optimizer.step()

after_loss = evaluate_loss()
after_text = generate_text(EVAL_PROMPT)

model.save_pretrained(OUTPUT_DIR)
tokenizer.save_pretrained(OUTPUT_DIR)

# 用同一提示和确定性解码保留预热前后的可比证据。
with open(COMPARISON_PATH, "w", encoding="utf-8") as f:
    json.dump(
        {
            "eval_prompt": EVAL_PROMPT,
            "before_loss": before_loss,
            "after_loss": after_loss,
            "before_text": before_text,
            "after_text": after_text,
        },
        f,
        ensure_ascii=False,
        indent=2,
    )

print(f"saved={OUTPUT_DIR}")
print(f"comparison={COMPARISON_PATH}")
预期输出:
saved=student-sft-warmup
comparison=sft_comparison.json
sft_comparison.json 中的损失和生成文本取决于模型、设备与库版本,因此实际值可能不同。在这组极小训练样本上,训练后损失通常应下降;若没有下降,应先检查学习率、标签遮罩、截断位置和样本格式,而不是直接增加训练轮数。
用固定评测集决定是否进入蒸馏
训练损失下降只证明模型更贴合训练样本,不能替代质量评测。应使用预热前已经冻结的评测提示,比较至少三项:结构格式通过率、核心任务正确率、无关内容或拒答行为是否恶化。生成参数也要固定,否则解码变化会污染前后对比。
当学生模型已经稳定遵循格式、基础任务正确率明显提升,而且继续增加 SFT 步数主要带来训练损失下降却不再改善固定评测集时,就应保存该 checkpoint 作为软标签蒸馏起点。这个检查点、训练数据版本、随机种子和评测结果必须一起保留,后续才能判断蒸馏阶段究竟贡献了多少增益。