
大模型原理与训练 / 系统课时
定位量化后的质量突然下降
定位量化后的质量突然下降
量化后指标突然下滑时,第一目标不是立刻重做量化,而是先证明“只有权重精度变化”。本节用冻结对照条件、原模型复现和分层排查,把 Tokenizer、生成参数、评测集变化与真正的量化误差分开,再定位校准、粒度和敏感层问题。
学习目标
- 建立原模型与量化模型的严格 A/B 对照,先排除推理配置和评测链路漂移。
- 按 Tokenizer、生成参数、评测集、校准数据、量化粒度和敏感层逐层定位。
- 用原模型复现结果判断问题属于服务配置、评测流程还是量化本身。
先冻结所有对照条件
真正可比较的 A/B 测试,只允许模型权重或量化方式不同。两边应使用同一批 Prompt、同一 Chat Template、同一 Tokenizer 版本、同一停止词、同一上下文长度和同一生成参数;评测脚本、数据清洗规则与评分器也必须固定。
尤其要先检查 temperature、top_p、max_tokens、停止条件和系统提示词。一次模板变化就可能让输出格式整体漂移,表现得像量化质量下降。若服务支持随机种子,也应固定种子;若不支持,优先用 temperature=0 做第一轮可复现实验。
用同一请求做原模型与量化模型 A/B
下面脚本向两个 OpenAI 兼容服务发送完全相同的请求,并打印两边输出及字符串相似度。相似度只是烟雾测试,不是最终质量指标;它的用途是快速确认两边是否已经出现大幅行为分叉,再继续跑正式评测集。
import difflib
import json
import os
import urllib.request

BASE_URL = os.environ.get("BASE_URL", "http://127.0.0.1:8000/v1/chat/completions")
QUANT_URL = os.environ.get("QUANT_URL", "http://127.0.0.1:8001/v1/chat/completions")
BASE_MODEL = os.environ.get("BASE_MODEL", "base-model")
QUANT_MODEL = os.environ.get("QUANT_MODEL", "quant-model")

prompt = "请用不超过五句话解释为什么校准数据会影响后训练量化效果。"

def call(url, model):
    payload = {
        "model": model,
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0.0,
        "max_tokens": 128,
        "stream": False,
    }
    req = urllib.request.Request(
        url,
        data=json.dumps(payload).encode("utf-8"),
        headers={"Content-Type": "application/json"},
        method="POST",
    )
    with urllib.request.urlopen(req, timeout=120) as resp:
        data = json.loads(resp.read().decode("utf-8"))
    return data["choices"][0]["message"]["content"]

base_text = call(BASE_URL, BASE_MODEL)
quant_text = call(QUANT_URL, QUANT_MODEL)
similarity = difflib.SequenceMatcher(None, base_text, quant_text).ratio()

print("BASE:")
print(base_text)
print("\nQUANT:")
print(quant_text)
print(f"\nSTRING_SIMILARITY={similarity:.3f}")
预期输出
BASE:
<BASE_OUTPUT>

QUANT:
<QUANT_OUTPUT>

STRING_SIMILARITY=<SCORE>
<SCORE> 只用于发现明显分叉,不能直接代表语义质量。若原模型在同一服务链路、同一评测脚本下也复现了质量下降,优先排查 Tokenizer、模板、生成参数或评测集;只有原模型稳定而量化模型显著变差时,才进入量化层面的定位。
按层排查而不是同时改参数
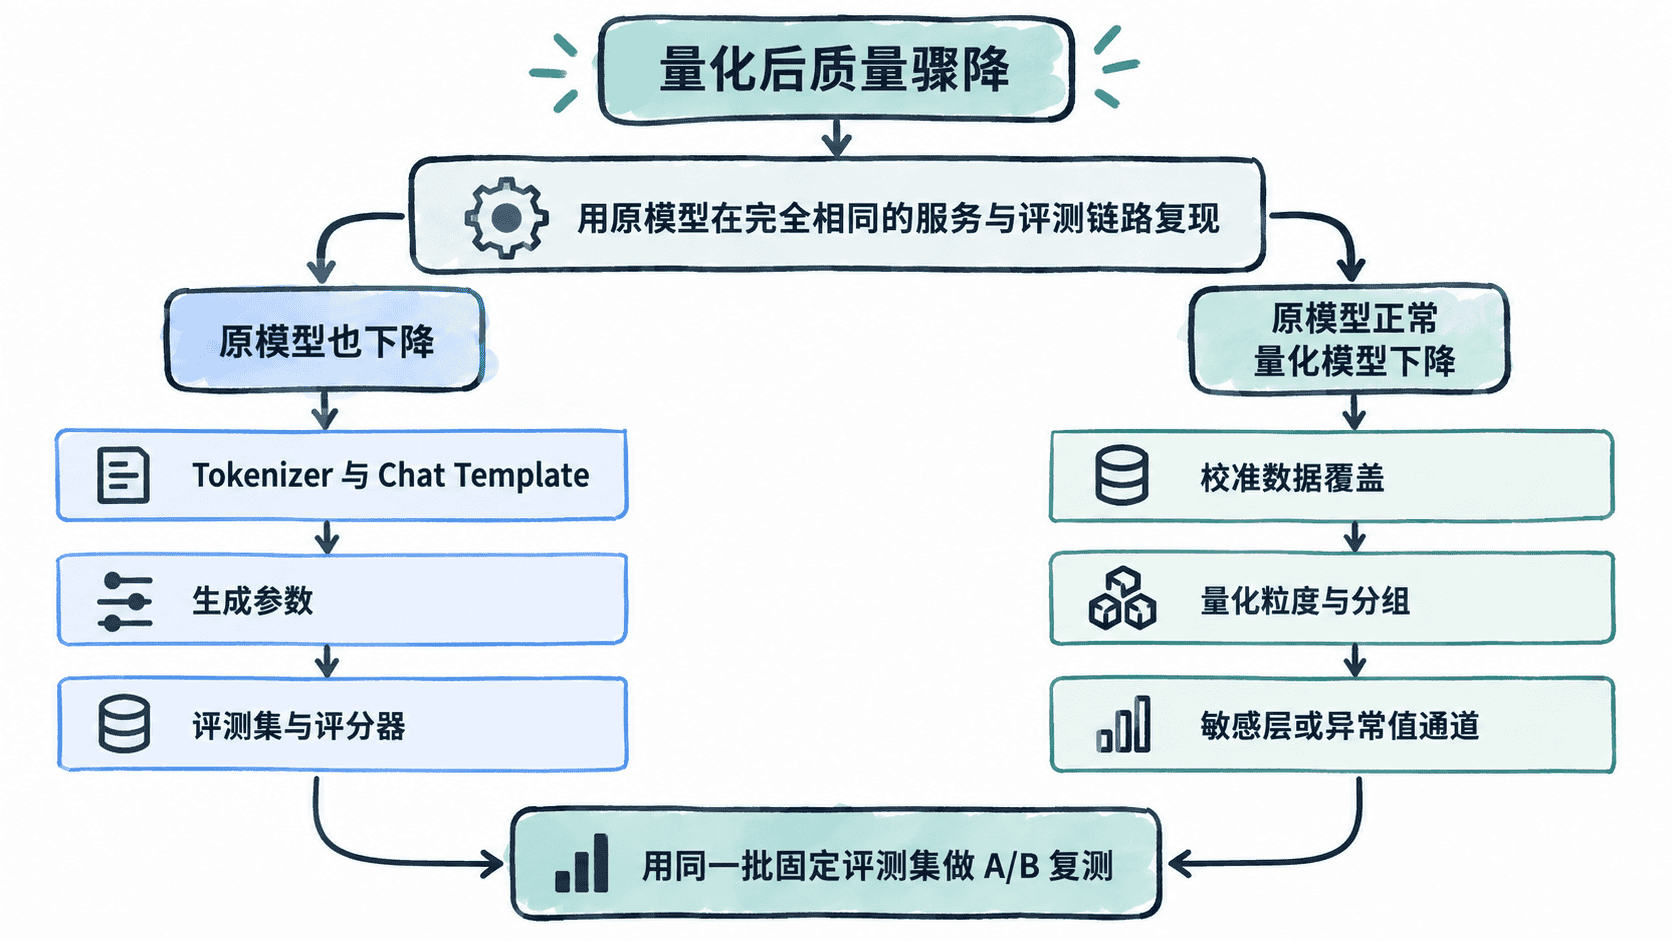
先查最容易制造“假量化问题”的配置层。Tokenizer 或 Chat Template 不一致会改变分词、角色边界和特殊 Token;生成参数变化会改变随机性、长度和停止位置;评测集版本或评分规则变化则会直接改变指标口径。任何一项不一致,都应先恢复一致再重新对比。
如果这些条件已经一致,再看量化输入本身。校准数据要覆盖真实输入分布和典型长度,过窄的数据会让缩放因子只适应少数模式。量化粒度过粗时,少量大幅值会拖累同组其他权重;某些层或通道对精度更敏感,也可能成为整体质量下降的主要来源。
用原模型复现完成二分
原模型复现是整个定位过程的分水岭。出现问题时,可以按下面三种结果判断下一步:
| 复现结果 | 更可能的问题 | 下一步 |
|---|---|---|
| 原模型和量化模型都下降 | 服务配置、Tokenizer、模板、评测链路 | 固定推理参数并回滚评测环境 |
| 原模型正常,量化模型下降 | 量化误差 | 检查校准、粒度、敏感层 |
| 离线两者正常,线上量化服务下降 | 在线服务路径 | 对比网关参数、模板拼接、上下文截断 |
这一步的价值在于把搜索空间迅速减半。若没有原模型对照,很容易一边改校准集、一边改生成参数,最后即使指标恢复,也无法知道真正的根因。
确认是量化误差后再修
校准数据问题应先用更贴近生产分布的数据重新校准,并覆盖长短输入、领域术语和常见格式。粒度问题可尝试更细的分组、按通道量化或提高部分权重的精度;敏感层问题则适合做逐层回退实验,把少量高敏感层保留为 FP16/BF16,再观察指标是否明显恢复。
修复时一次只改一个变量,并始终回到同一份固定评测集做 A/B。只要原模型基线、Tokenizer、生成参数和评测口径保持不变,就能判断改动究竟是在修复量化误差,还是只是改变了推理行为。