
大模型原理与训练 / 系统课时
选择逐张量逐通道或分组量化
选择逐张量逐通道或分组量化
量化粒度决定了“多少个数共用一个 Scale”。粒度越粗,元数据少、算子实现简单,但极端值更容易把整体量化范围拉大;粒度越细,误差通常更小,却要保存更多 Scale,并依赖后端是否能高效读取。本文给出可直接用于大模型权重量化的选择方法。
学习目标
- 说清 Per-Tensor、Per-Channel 与 Group-Wise 的 Scale 作用范围
- 判断粒度变化对误差、元数据和推理效率的影响
- 根据权重分布与后端能力选择合适粒度
Scale 粒度决定了什么
线性量化本质上要为一组浮点值确定 Scale,并把它们映射到有限整数范围。若整张张量只共享一个 Scale,任意一个异常大值都可能扩大整个张量的量化步长;若拆成更小的组,不同区域可以各自使用更贴近本地分布的 Scale。
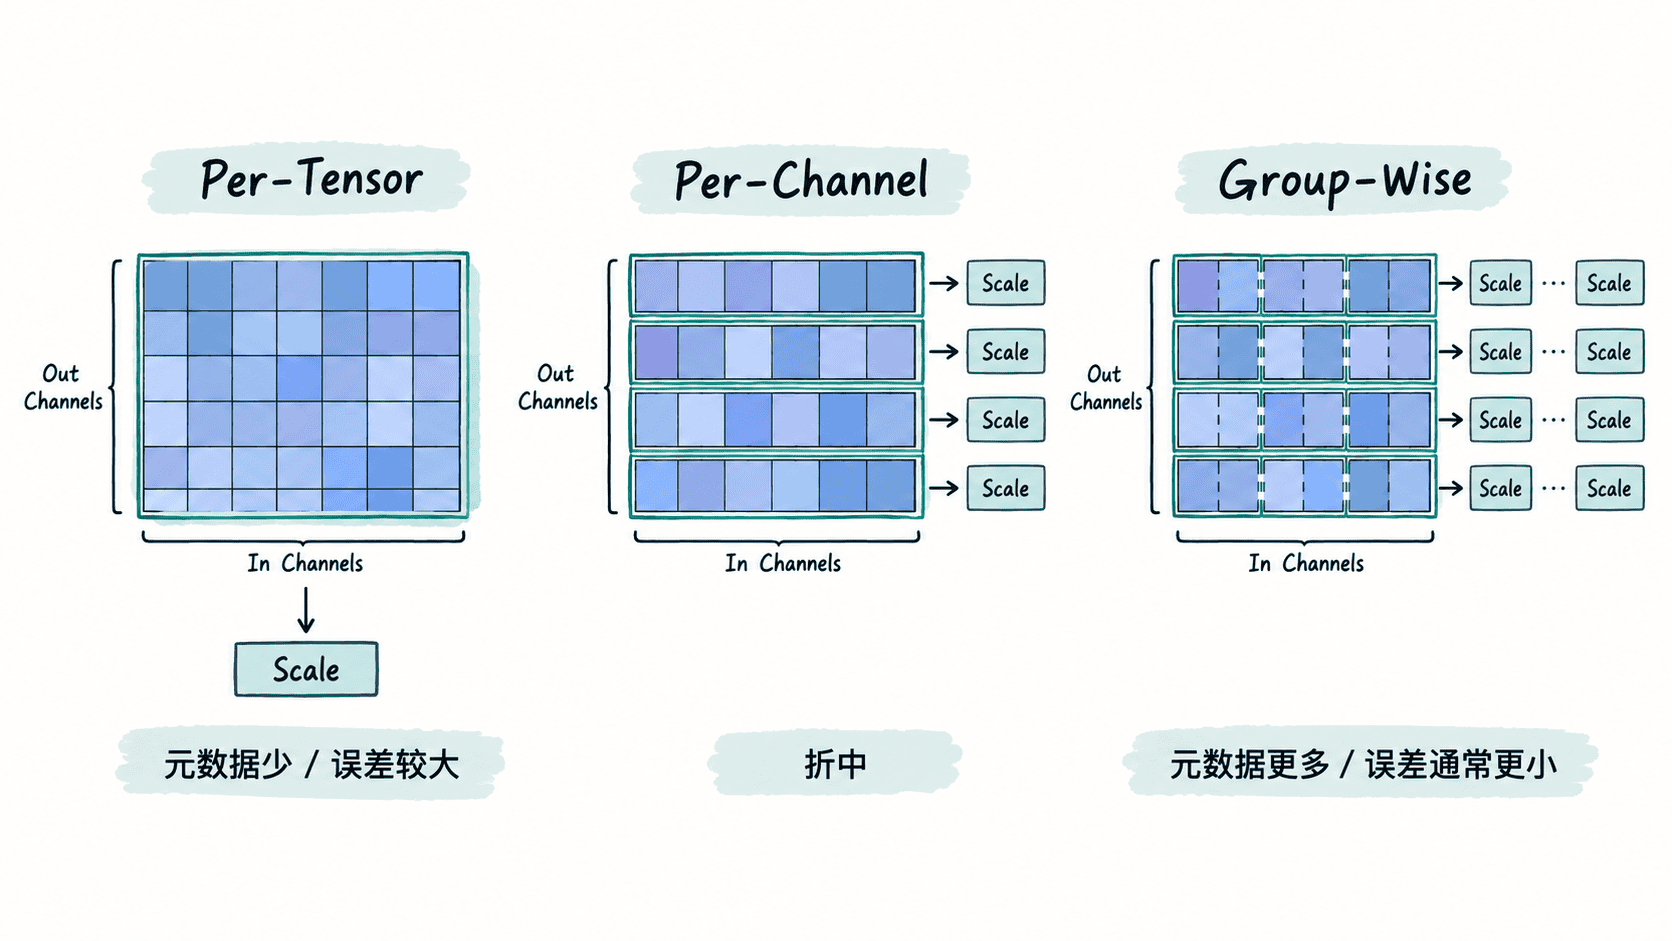
Per-Tensor 最粗,通常只保存一个 Scale;Per-Channel 常按输出通道各自保存 Scale;Group-Wise 则在通道内部继续按固定组大小切分,例如每 128 个权重共享一个 Scale。组越小,Scale 越能贴近局部数值范围。
三种粒度怎么权衡
| 粒度 | Scale 数量 | 量化误差 | 元数据与访问开销 | 常见用途 |
|---|---|---|---|---|
| Per-Tensor | 最少 | 通常最高 | 最低 | 激活、简单后端、分布较均匀的张量 |
| Per-Channel | 中等 | 通常较低 | 中等 | 卷积权重、部分线性层权重 |
| Group-Wise | 最多 | 通常最低 | 较高 | 大模型 INT4/低比特 Weight-Only |
这里的“误差更低”不是绝对结论。如果同一通道内部数值已经很集中,继续把 group size 从 128 降到 32,收益可能很小,但 Scale 数量会增加四倍。低比特量化尤其容易受异常值影响,因此 INT4 比 INT8 更常需要 Group-Wise。
用元数据开销算清代价
假设一个线性层有 4096×4096 个权重,采用对称量化,每个 Scale 用 16 bit 保存。Per-Tensor 只需 1 个 Scale;若按 4096 个输出通道做 Per-Channel,需要 4096 个 Scale;若每个输出通道再按 group size 128 切分,则需要 4096×32 个 Scale。
Scale 本身通常不会成为主要显存占用,但它会进入读取路径。权重位宽越低,Scale、Zero Point、索引和反量化计算在总成本中的占比越明显,因此“误差最小”并不等于“吞吐最高”。
选择时先看这三个条件
优先从精度约束开始:如果 Per-Tensor 已满足任务误差预算,就没有必要细分。若低比特下少数通道出现明显离群值,先尝试 Per-Channel;如果单个通道内部仍存在较大的局部动态范围,再进入 Group-Wise,并从较大的 group size 向下收紧。
然后检查推理后端。某些 GPU Kernel 只对特定 group size 有融合实现,理论上更细的分组若触发额外反量化或不连续访存,实际速度可能更差。最终选择应同时满足“误差可接受”和“后端原生支持”两个条件。
真正需要优化的不是 Scale 数量本身,而是在目标硬件上用最粗、仍能满足精度预算的粒度。这样既避免为极少数异常值付出过多元数据与算子成本,也能把低比特压缩的带宽收益保留下来。