
大模型原理与训练 / 系统课时
用 AWQ 保护显著权重通道
用 AWQ 保护显著权重通道
AWQ 也是训练后权重量化,但它不把所有通道视为同等重要,而是根据校准激活寻找更敏感的通道,再通过等价缩放和裁剪降低这些通道的量化误差。本节完成一次 4 位 AWQ 校准与导出,并说明它与普通 4 位分组量化的关键差别。
学习目标
- 解释 AWQ 为什么用激活统计判断显著权重通道
- 完成 4 位 AWQ 校准、权重打包与模型导出
- 比较 AWQ 与普通 4 位权重量化在质量、体积和加载方式上的差异
AWQ 保护的不是“最大权重”
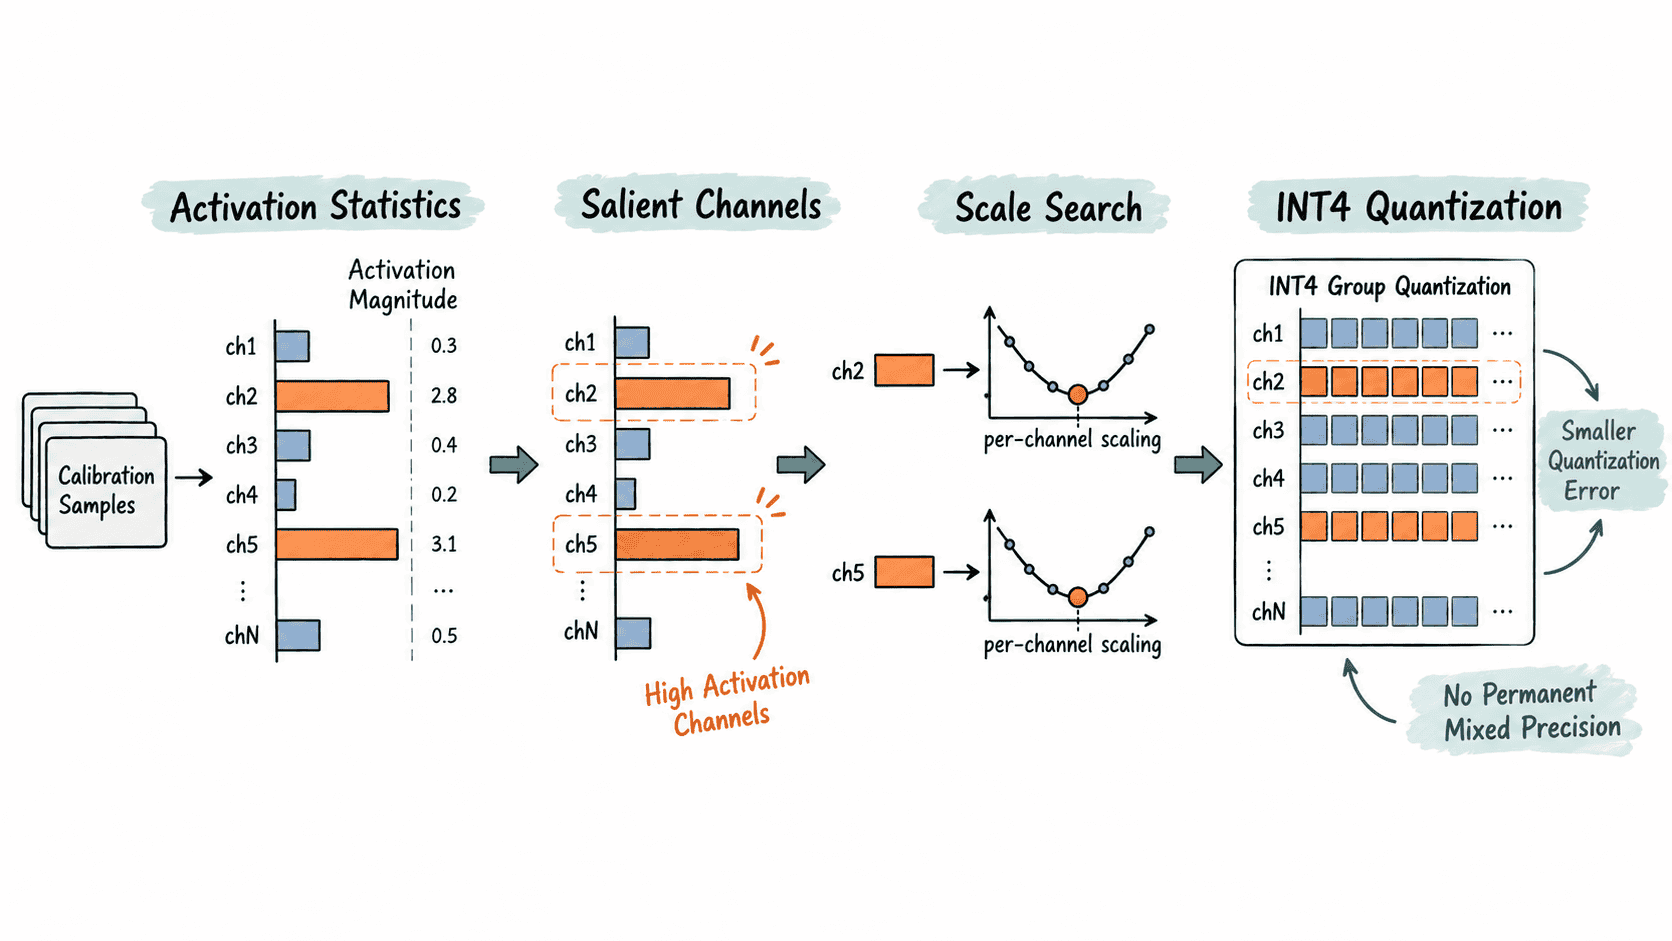
某个权重值很大,并不代表它对真实请求一定最重要。AWQ 会让校准样本前向通过模型,观察输入激活的尺度;若某些输入通道经常产生较大的激活,那么这些通道上的权重误差更容易放大到层输出。
AWQ 的核心做法不是把显著权重永久留在高精度,而是搜索每通道缩放系数,让敏感通道在进入 4 位量化网格前得到更合适的数值范围,同时对相邻算子做等价变换以保持原模型函数近似不变。这样仍可保持规则的低位宽权重布局,便于使用高效内核。
完成 AWQ 校准与导出
下面使用 AutoAWQ 的经典接口展示完整流程,便于把“校准、搜索缩放、打包、导出”串成一次可复现实验。生产环境应先确认模型架构、量化工具与目标推理后端支持同一种 AWQ 检查点格式;示例模型也可替换为你本地已验证兼容的 Causal LM。
from pathlib import Path

from awq import AutoAWQForCausalLM
from transformers import AutoTokenizer

model_id = "facebook/opt-125m"
output_dir = "./opt-125m-awq"

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoAWQForCausalLM.from_pretrained(model_id)

quant_config = {
    "zero_point": True,
    "q_group_size": 128,
    "w_bit": 4,
    "version": "GEMM",
}

calibration_data = [
    "Activation statistics should resemble real production prompts.",
    "AWQ uses activation information to protect sensitive weight channels.",
    "The exported checkpoint still uses regular low-bit packed weights.",
]

model.quantize(
    tokenizer,
    quant_config=quant_config,
    calib_data=calibration_data,
)
model.save_quantized(output_dir)
tokenizer.save_pretrained(output_dir)

print(f"saved: {output_dir}")
预期输出
saved: ./opt-125m-awq底层库可能额外打印校准和打包进度,具体日志取决于版本。验证重点是量化流程无异常结束,并且导出目录同时保存模型配置、分词器和 AWQ 量化权重。
和普通 4 位权重量化怎么比
| 维度 | 普通 4 位分组权重量化 | AWQ |
|---|---|---|
| 量化依据 | 主要依据权重范围选择 scale/zero-point | 额外利用校准激活识别敏感通道并搜索缩放 |
| 质量保持 | 对异常通道或敏感通道可能更脆弱 | 通常更重视保护高影响通道 |
| 主体体积 | 约为 4 位权重加少量分组元数据 | 同样以 4 位权重为主,额外缩放元数据很小 |
| 运行时 | 需要支持对应 4 位布局的内核 | 需要识别 AWQ 配置与权重打包格式的加载器或内核 |
两者都可能把 FP16 权重主体压到约四分之一位宽,但模型总目录不会严格缩小到四分之一,因为还存在 embedding、norm、量化参数、配置和可能保留高精度的张量。AWQ 的优势重点是相同低位宽预算下减少质量损失,而不是额外创造一次数量级更高的压缩。
导出后按后端方式加载
AWQ 检查点通常会在模型配置中记录 quant_method=awq、位宽、分组大小和打包版本。兼容的 transformers 或推理引擎会根据这些信息选择 AWQ 线性层和对应内核;因此不能把任意 INT4 权重目录改个名字就当作 AWQ 模型。
上线验收时,先在目标后端做一次真实加载和短生成,再用固定回归集比较原模型与 AWQ 模型的答案质量或任务指标,最后记录显存、首 Token 延迟和解码吞吐。若质量明显下降,优先检查校准数据分布与分组参数;若能加载但没有性能收益,则应检查后端是否真正启用了 AWQ 优化内核,而不是回退到通用反量化路径。