
大模型原理与训练 / 系统课时
调整训练参数让 QAT 稳定收敛
调整训练参数让 QAT 稳定收敛
QAT 把量化误差直接带进训练过程,原本稳定的微调参数因此可能出现损失震荡、梯度尖峰或量化尺度持续漂移。本篇用一个可运行的最小训练环同时观察损失、梯度和量化尺度,并给出从降学习率到冻结观察器的稳定化顺序。
学习目标
- 根据损失、梯度范数和量化尺度判断 QAT 是否稳定收敛
- 使用较低学习率、梯度裁剪和观察器冻结抑制训练震荡
- 通过独立验证集区分真正适应量化噪声与训练集过拟合
先判断是哪一种不稳定
QAT 的损失曲线不能单独看。Fake Quantization 会持续根据张量范围更新量化尺度,尺度变化又会改变下一轮前向传播中的舍入误差,因此至少要把三个信号放在一起观察。
| 信号 | 稳定状态 | 需要警惕的状态 |
|---|---|---|
| 训练损失 | 总体下降,允许小幅抖动 | 连续放大或周期性大幅震荡 |
| 梯度范数 | 有波动但量级受控 | 突然增大数个数量级 |
| 量化尺度 | 前期调整,后期逐渐稳定 | 训练后期仍持续大幅漂移 |
| 验证指标 | 随训练改善或保持 | 训练损失下降但验证指标恶化 |
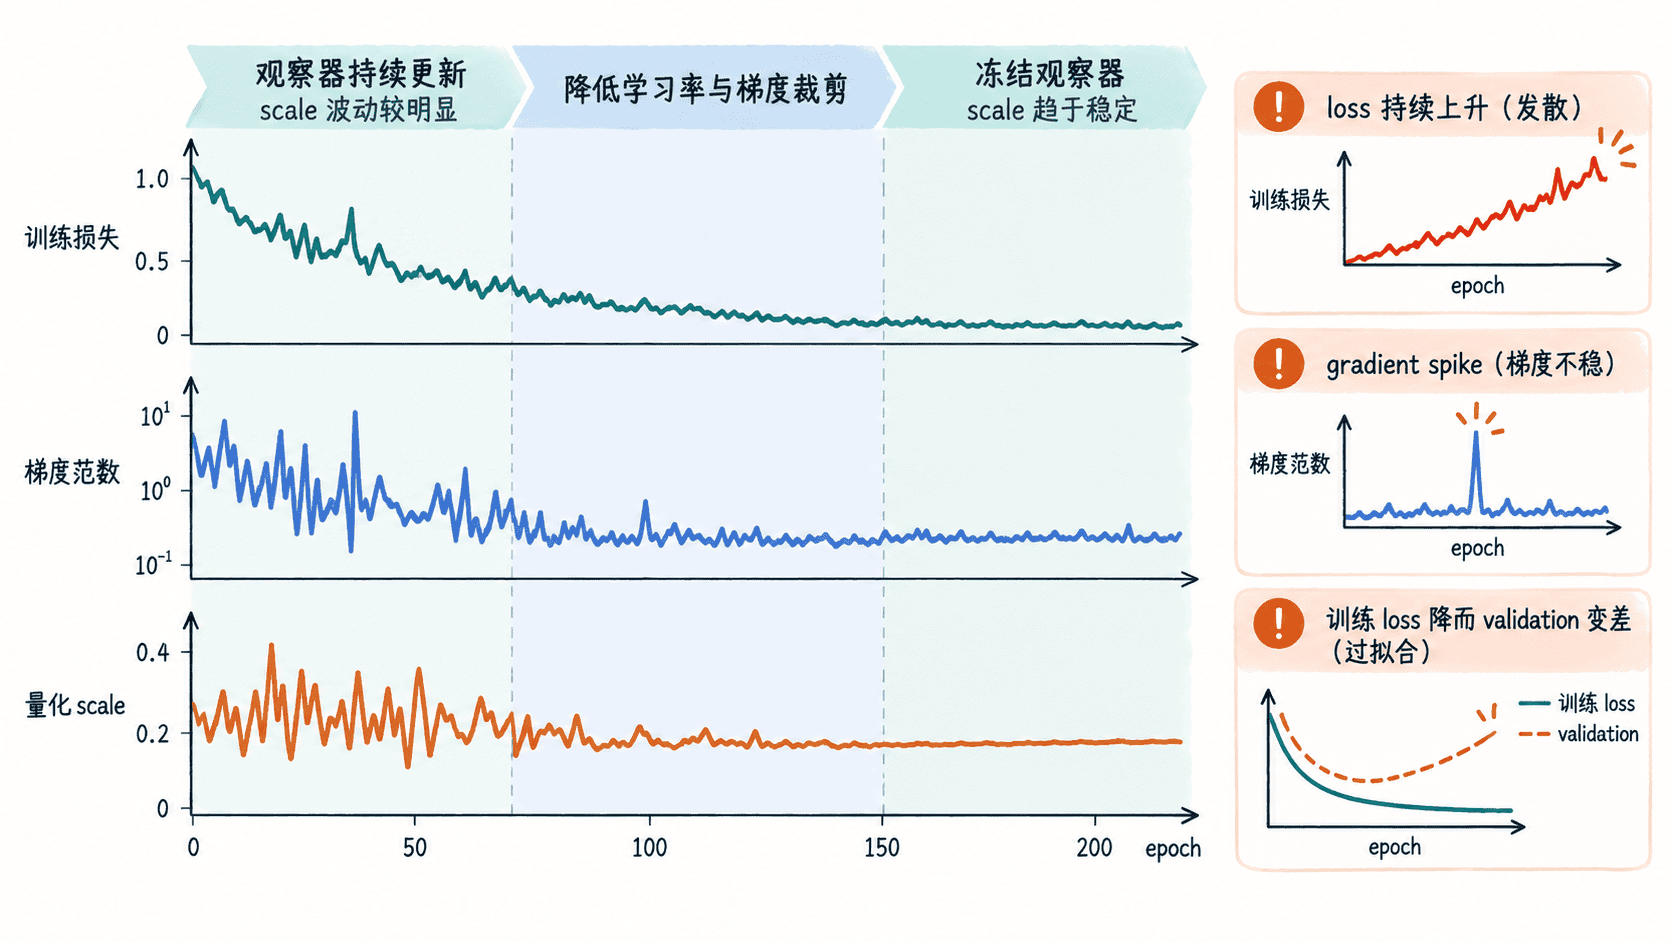
如果损失和梯度一起恶化,优先怀疑优化步长过大;如果损失尚可但量化尺度长期剧烈变化,应先处理观察器;如果只有训练集继续改善而验证集下降,则问题已经从“收敛”转向过拟合。
用较保守的参数跑一个稳定训练环
下面的示例使用对称 INT8 Fake Quantization。量化采用直通估计保留反向梯度,并用指数移动平均更新权重和激活尺度。训练阶段采用较低学习率和梯度裁剪,第 5 个 epoch 起冻结量化尺度,让模型在固定量化网格上继续适应。
import torch
import torch.nn as nn
import torch.nn.functional as F


def fake_quantize(x, scale):
    q = torch.clamp(torch.round(x / scale), -127, 127)
    dequantized = q * scale
    # 前向使用量化后的值,反向对 x 使用直通梯度。
    return x + (dequantized - x).detach()


class FakeQuantLinear(nn.Module):
    def __init__(self, in_features, out_features):
        super().__init__()
        self.linear = nn.Linear(in_features, out_features)
        self.register_buffer("weight_scale", torch.tensor(1.0))
        self.register_buffer("activation_scale", torch.tensor(1.0))
        self.observer_enabled = True

    def update_scale(self, x, name):
        observed = x.detach().abs().amax().clamp_min(1e-8) / 127
        scale = getattr(self, name)
        scale.mul_(0.9).add_(observed * 0.1)

    def forward(self, x):
        if self.observer_enabled:
            self.update_scale(self.linear.weight, "weight_scale")
        weight = fake_quantize(self.linear.weight, self.weight_scale)
        y = F.linear(x, weight, self.linear.bias)
        if self.observer_enabled:
            self.update_scale(y, "activation_scale")
        return fake_quantize(y, self.activation_scale)


class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = FakeQuantLinear(8, 16)
        self.fc2 = FakeQuantLinear(16, 2)

    def forward(self, x):
        return self.fc2(F.relu(self.fc1(x)))

    def freeze_observers(self):
        for module in self.modules():
            if isinstance(module, FakeQuantLinear):
                module.observer_enabled = False


torch.manual_seed(7)
x = torch.randn(800, 8)
target = (x[:, 0] + 0.7 * x[:, 1] - 0.4 * x[:, 2] > 0).long()
train_x, val_x = x[:640], x[640:]
train_y, val_y = target[:640], target[640:]

model = Net()
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4, weight_decay=1e-4)

for epoch in range(1, 9):
    model.train()
    optimizer.zero_grad()
    loss = F.cross_entropy(model(train_x), train_y)
    loss.backward()
    # 裁剪的是全局梯度范数,返回值可直接作为稳定性监控指标。
    grad_norm = torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
    optimizer.step()

    if epoch == 4:
        model.freeze_observers()

    model.eval()
    with torch.no_grad():
        accuracy = (model(val_x).argmax(dim=1) == val_y).float().mean().item()

    print(
        f"epoch={epoch:02d} loss={loss.item():.4f} "
        f"val_acc={accuracy:.3f} grad_norm={float(grad_norm):.3f} "
        f"scale={model.fc1.activation_scale.item():.5f}"
    )
预期输出
epoch=01 loss=<LOSS> val_acc=<ACC> grad_norm=<NORM> scale=<SCALE>
epoch=02 loss=<LOSS> val_acc=<ACC> grad_norm=<NORM> scale=<SCALE>
...
epoch=08 loss=<LOSS> val_acc=<ACC> grad_norm=<NORM> scale=<SCALE><LOSS>、<ACC>、<NORM> 和 <SCALE> 的具体数值会受 PyTorch 版本与运行设备影响。应重点验证 loss 没有持续发散、梯度范数受控,并且冻结观察器后 scale 不再变化。
按症状调整而不是同时改所有参数
发现震荡时,第一步通常是把从浮点微调继承的学习率降低。量化噪声会改变局部优化表面,一次过大的参数更新可能跨过原本可接受的区域;实践中应先逐级降低学习率,而不是同时改学习率、优化器、量化范围和数据增强,否则无法判断是哪项修改真正有效。
梯度偶发尖峰时,可以加入全局梯度裁剪。裁剪阈值不是越小越安全:阈值长期被触发意味着优化器几乎每一步都被改写,此时更应该继续检查学习率、异常样本或量化范围,而不是只依赖裁剪掩盖问题。
量化尺度在训练后期仍快速变化时,可以先让观察器完成一段预热,再冻结统计量。冻结过早会把不成熟的范围固定下来,冻结过晚则使模型始终面对移动的量化网格。判断时应看 scale 是否已经进入窄幅波动区,而不是机械地规定固定 epoch。
用验证集排除“适应得太好”
QAT 的目标不是让训练集上的量化误差无限接近零,而是让模型在未见数据上仍能承受目标位宽的量化误差。每次调整学习率、冻结时点或训练轮数后,都应在固定验证集上比较同一指标。
如果训练损失继续下降而验证指标连续恶化,应减少 QAT 轮数、加强常规正则化或提前停止;如果训练集和验证集都停滞,再检查学习率是否已经过低。只有当验证指标稳定、量化尺度进入稳定区间且梯度没有持续异常时,才说明模型真正适应了量化噪声,可以进入最终转换和部署验证。