
大模型原理与训练 / 系统课时
对比 PTQ 与 QAT 的收益边界
对比 PTQ 与 QAT 的收益边界
PTQ 不需要重新训练,QAT 却要承担训练算力、数据准备和新的验证链路,因此不能只问“QAT 精度是不是更高”。本篇把两者放到同一位宽、同一量化策略和同一推理后端下比较,并用上线质量门槛判断额外训练成本是否值得。
学习目标
- 设计能够公平比较 PTQ 与 QAT 的实验条件
- 从质量、训练成本和部署复杂度判断 QAT 的真实收益
- 根据上线门槛识别应选 PTQ、QAT 或重新选择量化方案的边界
先把比较条件锁死
PTQ 与 QAT 如果使用不同位宽、不同算子覆盖范围或不同推理后端,最终差异就混入了多个变量,无法证明收益来自训练方式本身。最小公平实验应从同一个浮点 checkpoint 出发,并固定以下条件:
- 权重和激活采用相同目标位宽与粒度,例如都测试同一种 W8A8 或 W4A16 配置。
- 可量化算子、跳过算子以及异常层处理策略保持一致。
- 使用同一份验证集和完全一致的质量指标。
- 最终模型进入同一个推理后端,以相同 batch、输入长度和硬件测量延迟与吞吐。
PTQ 可以额外使用校准集确定量化参数;QAT 则在训练阶段通过 Fake Quantization 适应量化误差。两者的流程不同,但最终必须落到同一种可部署量化表示上,再进行质量和性能比较。
把三类成本放进同一张表
只看最终精度通常会高估 QAT 的价值。真正影响上线选择的是质量损失是否越过门槛,以及为了追回这部分质量需要增加多少训练和工程成本。
| 维度 | PTQ | QAT | 判断重点 |
|---|---|---|---|
| 质量 | 直接量化,敏感模型可能掉点明显 | 有机会适应量化噪声、追回质量 | 是否跨过上线门槛 |
| 训练成本 | 通常无需重新训练 | 需要微调数据、算力和训练时间 | 追回的质量是否值得额外成本 |
| 实验周期 | 校准与评估后即可进入部署 | 还要训练、调参、保存与转换 | 交付周期能否接受 |
| 部署复杂度 | 主要验证量化模型兼容性 | 最终格式一致时运行侧可相近 | 不要把训练复杂度误算成运行复杂度 |
| 维护成本 | 流程较短 | 模型升级后可能需要重新执行 QAT | 是否能长期自动化复现 |
这里最重要的边界是:如果 PTQ 已经满足质量门槛,QAT 追回的额外精度通常不会自动转化成上线价值。 此时更短的模型构建链路、更少的训练资源和更容易复现的发布流程往往更重要。
用上线门槛做决策
可以把浮点模型质量记为 ,PTQ 和 QAT 的质量分别记为 与 ,业务允许的最低质量记为 。真正有用的不是单纯比较 ,而是看它们相对 的位置。
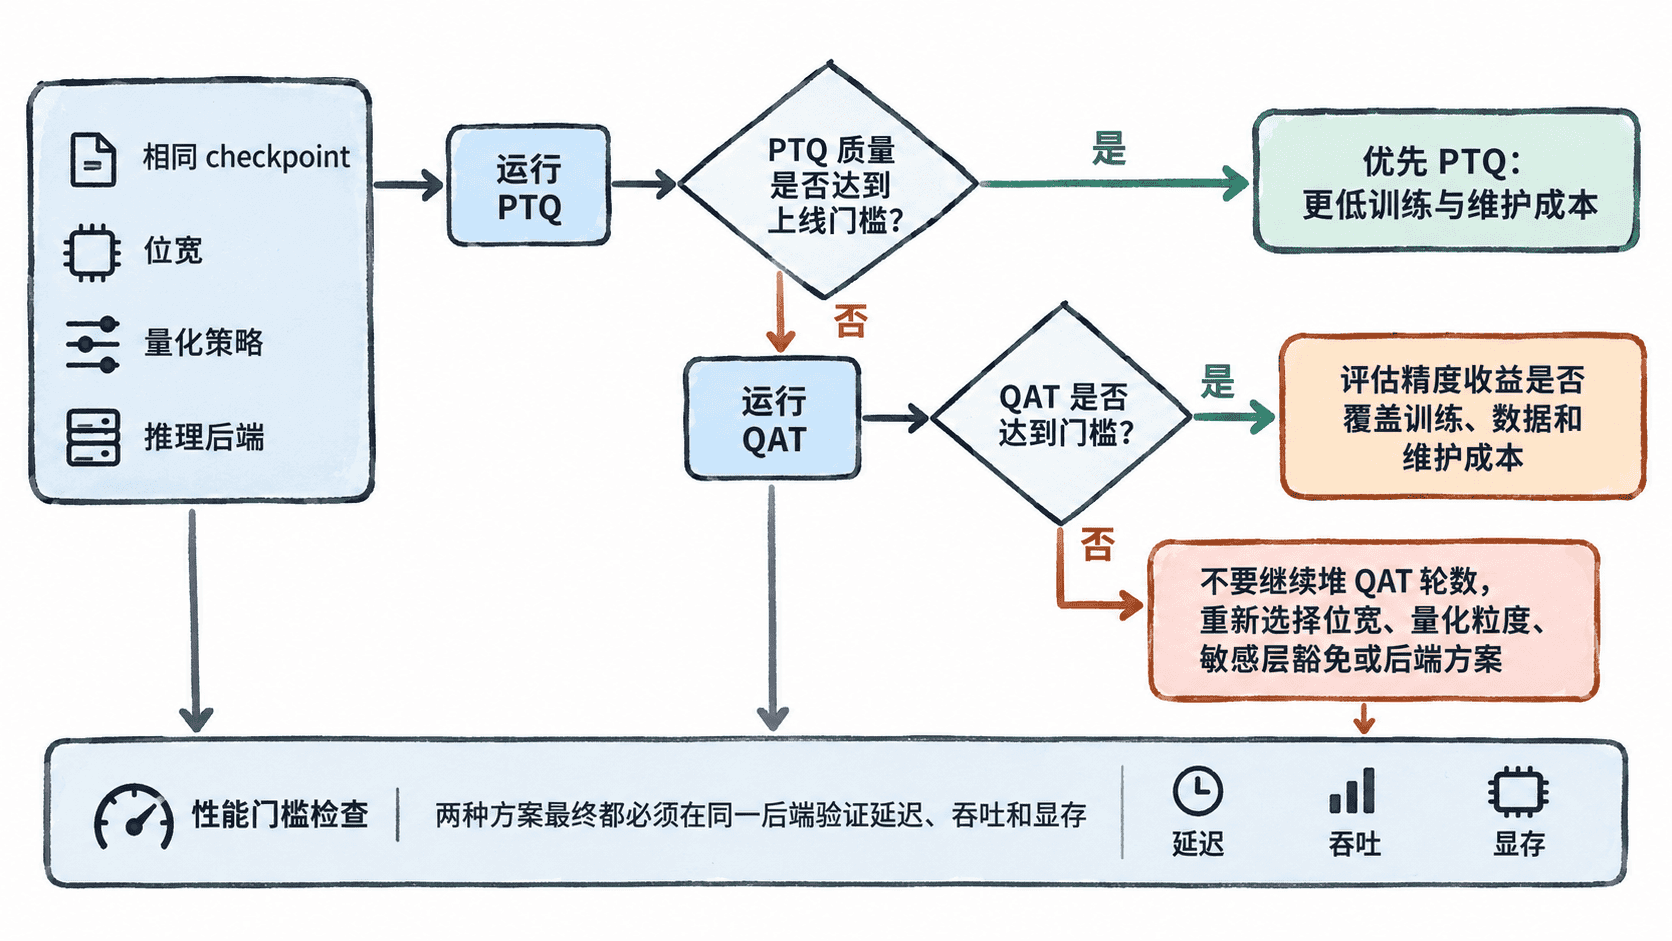
当 时,应先把 PTQ 作为默认候选。QAT 即使还能提升质量,也需要回答一个额外问题:这部分提升是否能改善真实业务指标,还是只让离线评测数字更漂亮。
当 且 时,QAT 才出现最明确的价值区间。它把原本无法上线的低位宽模型拉回质量门槛之上,此时额外训练可以换来显存、带宽或推理成本上的压缩收益。
如果 ,继续增加少量训练轮数通常不是完整策略。更应该重新检查位宽是否过低、哪些层对量化敏感、激活是否存在异常值,以及目标推理后端实际支持哪些量化组合。
不要忽略性能必须重新实测
QAT 改善的是模型对量化数值误差的适应能力,并不保证推理一定比 PTQ 更快。如果二者最终转换成相同量化格式,并由同一后端执行,运行性能往往主要由算子实现、内存访问、批大小和硬件决定。
因此评测记录至少要同时保存质量指标、模型大小、峰值显存、吞吐、目标延迟分位数,以及 PTQ 校准成本或 QAT 训练成本。只有在相同测试条件下,这些数字才可以用于发布决策。
识别真正值得做 QAT 的情况
QAT 更值得投入的典型情况,是目标位宽已经带来明确的部署收益,但 PTQ 恰好因为质量下降无法上线,而 QAT 能稳定追回关键指标。对精度敏感、量化误差集中在少数关键层的模型,也更可能从训练适应中获得实际收益。
相反,如果 PTQ 已经满足全部上线条件,或者 QAT 只能追回很小的离线指标却增加大量训练资源、数据治理和版本维护工作,应优先保留 PTQ。若两者都无法过线,则应把问题提升到量化方案层面,而不是把更多训练轮数继续投入一个本身不合适的位宽配置。