
大模型原理与训练 / 系统课时
用 Fake Quant 注入量化误差
用 Fake Quant 注入量化误差
这一节把 Fake Quant 放进一个可运行的训练前向:权重仍以 FP32 参数参与优化,但激活和权重在计算前经历低比特舍入与反量化。你会验证输出、损失和分布确实发生变化,同时梯度仍能更新浮点权重。
学习目标
- 解释 Fake Quant 为什么能让训练提前看到量化舍入误差
- 实现带直通估计器的最小 Fake Quant 前向并验证梯度更新
- 通过输出误差、损失差和分布变化判断量化噪声是否真正注入
Fake Quant 到底注入什么
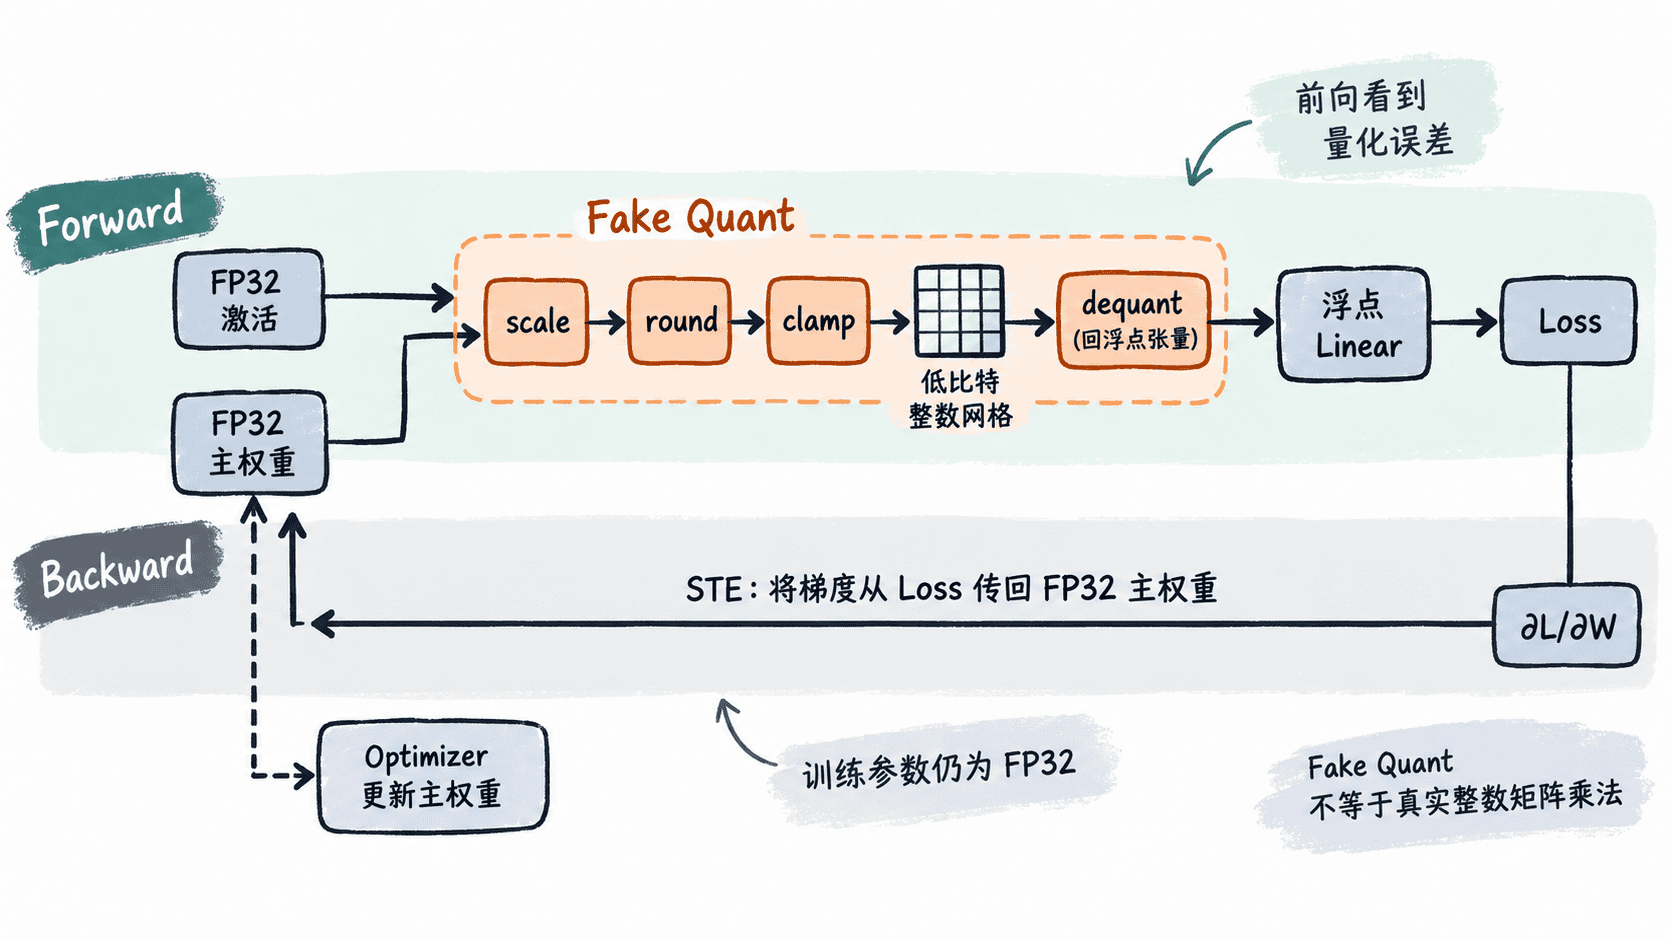
真实低比特推理会把浮点值映射到有限整数网格。Fake Quant 不要求训练阶段真的执行整数矩阵乘法,而是在前向中完成“浮点值 → 舍入和截断 → 反量化为浮点值”,让后续算子接收到带量化误差的张量。
以对称量化为例,先由张量范围得到 scale,再计算 round(x / scale) 并截断到可表示整数范围,最后乘回 scale。反量化后的数据类型仍可为 FP32,但可表示值已经落在离散网格上,因此舍入噪声会进入模型输出和损失。
直接对 round 求导几乎无法训练,所以 QAT 通常使用 Straight-Through Estimator,简称 STE:前向使用量化后的值,反向则近似把梯度直接传给原始浮点张量。优化器因此始终维护浮点主权重,而不是修改整数编码。
可运行的最小实验
下面用 4 bit 对称 Fake Quant 放大量化误差,便于观察。x + (x_q - x).detach() 的前向值等于量化后的 x_q,但反向梯度会沿原始 x 路径传播。示例假设环境已经安装 PyTorch。
import torch
import torch.nn.functional as F
from torch import nn


def fake_quant_ste(x: torch.Tensor, bits: int = 4) -> torch.Tensor:
    qmax = 2 ** (bits - 1) - 1
    scale = x.detach().abs().max().clamp(min=1e-8) / qmax
    x_q = torch.clamp(torch.round(x / scale), -qmax, qmax) * scale
    # 前向使用量化值,反向把梯度近似直接传给浮点张量。
    return x + (x_q - x).detach()


class FakeQuantLinear(nn.Module):
    def __init__(self, weight: torch.Tensor, bias: torch.Tensor):
        super().__init__()
        self.weight = nn.Parameter(weight.clone())
        self.bias = nn.Parameter(bias.clone())

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x_q = fake_quant_ste(x, bits=4)
        w_q = fake_quant_ste(self.weight, bits=4)
        return F.linear(x_q, w_q, self.bias)


w0 = torch.tensor([[0.13, -0.27, 0.44], [0.31, 0.18, -0.52]])
b0 = torch.tensor([0.07, -0.11])
x = torch.tensor([[0.15, -0.40, 0.90], [0.75, 0.20, -0.55]])
target = torch.tensor([[0.20, -0.10], [-0.30, 0.50]])

ref = nn.Linear(3, 2)
with torch.no_grad():
    ref.weight.copy_(w0)
    ref.bias.copy_(b0)

qat = FakeQuantLinear(w0, b0)
optimizer = torch.optim.SGD(qat.parameters(), lr=0.05)

out_fp = ref(x)
out_fq = qat(x)
loss_fp = F.mse_loss(out_fp, target)
loss_fq = F.mse_loss(out_fq, target)

weight_before = qat.weight.detach().clone()
optimizer.zero_grad()
loss_fq.backward()
grad_nonzero = qat.weight.grad.abs().sum().item() > 0
optimizer.step()

print(f'output_mae={(out_fq - out_fp).abs().mean().item():.8f}')
print(f'loss_delta={abs(loss_fq.item() - loss_fp.item()):.8f}')
print(f'std_delta={abs(out_fq.std().item() - out_fp.std().item()):.8f}')
print(f'float_weight_dtype={qat.weight.dtype}')
print(f'grad_nonzero={grad_nonzero}')
print(f'weight_updated={(qat.weight.detach() - weight_before).abs().max().item() > 0}')
预期输出
output_mae=<VALUE>
loss_delta=<VALUE>
std_delta=<VALUE>
float_weight_dtype=torch.float32
grad_nonzero=True
weight_updated=True
前三个数值会受 PyTorch 版本和底层计算实现影响,实际值可能略有差异,但在该示例中应为正数。关键证据是:Fake Quant 改变了输出与损失,同时参数仍是 FP32,并且能够获得非零梯度和完成更新。
训练时如何放置 Fake Quant
实际 QAT 不应随意给所有张量插入相同量化器。权重常使用逐通道或逐张量 Fake Quant,激活则需要根据部署后端选择对称或非对称范围;scale 和 zero point 通常由 Observer 或可学习参数获得,而不是像最小示例一样每次直接取最大绝对值。
典型前向路径是“浮点输入 → 激活 Fake Quant → 量化权重模拟 → 算子 → 下一处激活 Fake Quant”。这样训练看到的数值约束才尽量接近最终 INT8、INT4 等部署路径。若训练阶段的量化粒度、范围或算子融合方式与部署引擎不同,即使训练损失正常,也可能在真正转换后重新出现精度下降。
观察误差而不是只看训练损失
注入是否有效至少要同时观察三类信号:Fake Quant 前后张量误差是否非零、输出均值或标准差等分布统计是否变化、任务损失或验证指标是否发生可解释的偏移。如果所有差异长期都是零,应优先检查 Fake Quant 是否真的启用、量化范围是否过宽,以及目标模块是否实际走过量化路径。
另一方面,量化误差越大并不越好。QAT 的目标是让模型逐渐适应部署时不可避免的离散化约束,而不是人为制造最大噪声。训练稳定后仍应使用与目标硬件一致的位宽、粒度和算子规则完成转换,并用真实量化模型重新验证任务指标。