
大模型原理与训练 / 系统课时
对齐 Tokenizer 与提示模板
对齐 Tokenizer 与提示模板
蒸馏训练里,教师和学生看到的“同一句对话”必须尽量对应到同一组训练位置。本节把特殊 Token、Chat Template、EOS 与截断策略变成可检查的约束,并用脚本定位首个编码差异,避免损失函数在错位 Token 上学习。
学习目标
- 识别特殊 Token、提示模板和截断设置导致的训练目标错位
- 用同一条对话比较教师与学生的编码结果并定位首个差异
- 为蒸馏数据流水线建立可自动失败的 Tokenizer 对齐检查
为什么蒸馏要求位置对齐
如果采用逐 Token 的 Logit 蒸馏,损失默认比较教师第 个位置与学生第 个位置的分布。只要一侧多插入一个 BOS、角色标记不同,或提前写入 EOS,后面的所有位置都会整体偏移,此时即使文本含义相同,KL 散度也在比较不同目标。
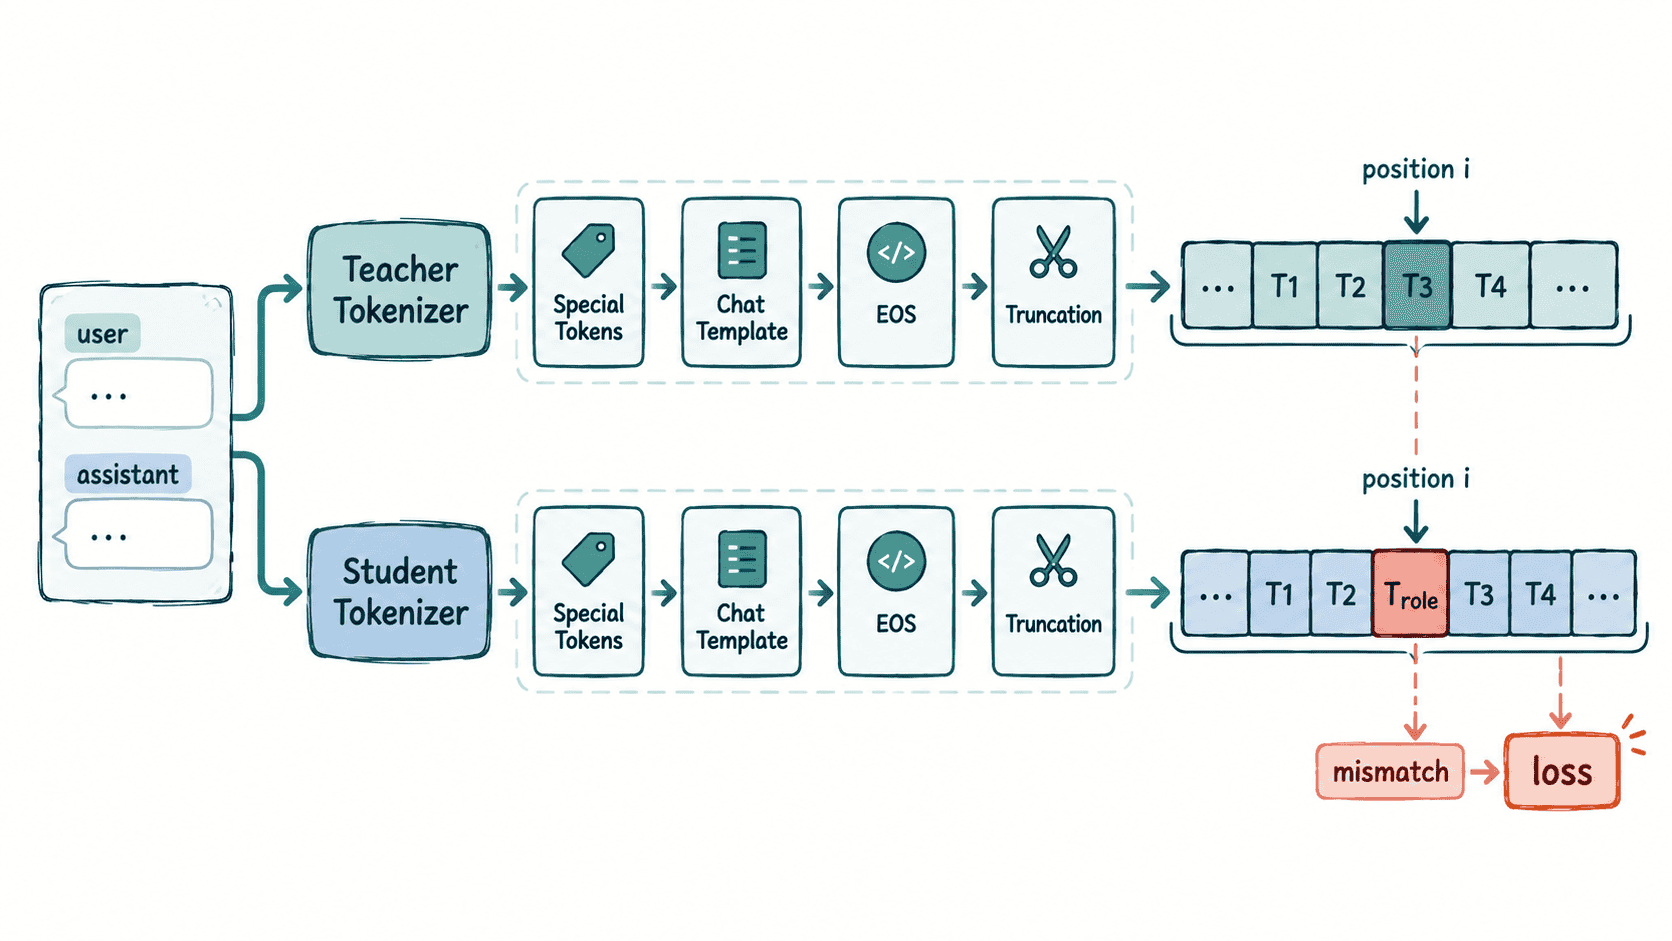
如果教师与学生使用不同词表,问题更根本:两边 Logit 的最后一维都可能不同,无法直接逐词表项计算 KL。此时要么选择共享 Tokenizer 的模型族,要么改用序列级蒸馏、标签蒸馏或显式词表映射,不能仅靠“把文本写成一样”解决。
固定四类对齐项
首先比较特殊 Token,包括 bos_token_id、eos_token_id、pad_token_id、unk_token_id 以及模型自定义的角色结束标记。名称相同但 ID 不同也算不一致,因为蒸馏损失最终处理的是位置与词表索引。
其次比较 chat_template。同一组 messages 可能被渲染成不同的前缀、角色标签和换行格式。模板之外,还要统一是否使用 add_generation_prompt;训练完整问答时通常不应额外追加“等待生成”的 assistant 起始标记。
EOS 需要同时检查“值”和“位置”。完整回答样本应在模板预期的位置结束;若截断后 EOS 被切掉,模型会把一个不完整回答当成正常结束。最后统一 max_length、truncation_side 和实际截断策略,避免教师保留答案尾部、学生却保留提示开头。
用同一条对话做编码对照
下面脚本默认让教师和学生使用同一个 Tokenizer,先建立应当完全对齐的基线。实际项目中可通过环境变量分别传入教师与学生 Tokenizer;<PATH> 可以是本地模型目录,实际路径按环境替换。
import os
from transformers import AutoTokenizer

default_name = "Qwen/Qwen2.5-0.5B-Instruct"
teacher_name = os.environ.get("TEACHER_TOKENIZER", default_name)
student_name = os.environ.get("STUDENT_TOKENIZER", teacher_name)

teacher = AutoTokenizer.from_pretrained(teacher_name)
student = AutoTokenizer.from_pretrained(student_name)

messages = [
    {"role": "user", "content": "把 3 个要点压缩成一句话。"},
    {"role": "assistant", "content": "保留结论、约束和关键数字。"},
]
max_length = 128

def encode(tokenizer):
    # 先由模板生成完整训练文本,再关闭额外 special token 注入,避免重复添加。
    rendered = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=False,
    )
    return tokenizer(
        rendered,
        add_special_tokens=False,
        truncation=True,
        max_length=max_length,
    )["input_ids"]

teacher_ids = encode(teacher)
student_ids = encode(student)

first_diff = next(
    (i for i, (a, b) in enumerate(zip(teacher_ids, student_ids)) if a != b),
    -1,
)
if first_diff == -1 and len(teacher_ids) != len(student_ids):
    first_diff = min(len(teacher_ids), len(student_ids))

print(f"template_match={teacher.chat_template == student.chat_template}")
print(f"eos_match={teacher.eos_token_id == student.eos_token_id}")
print(f"truncation_side_match={teacher.truncation_side == student.truncation_side}")
print(f"token_ids_match={teacher_ids == student_ids}")
print(f"teacher_tokens={len(teacher_ids)}")
print(f"student_tokens={len(student_ids)}")
print(f"first_diff_index={first_diff}")
预期输出
template_match=True
eos_match=True
truncation_side_match=True
token_ids_match=True
teacher_tokens=<N>
student_tokens=<N>
first_diff_index=-1
<N> 取决于 Tokenizer 版本和模板内容;两边 Token 数应相同。若 first_diff_index 不为 -1,先打印该位置前后的 token ID 与解码文本,再检查模板、特殊 Token 和截断设置,不要直接开始训练。
让截断与标签保持一致
对因果语言模型做监督或蒸馏时,常见做法是把提示部分的标签设为 -100,只让回答部分产生监督信号。这个边界必须基于“最终实际送入模型的 token 序列”计算,而不是先按字符串长度猜位置;模板新增的角色标记会让字符位置与 token 位置完全不同。
若教师和学生必须使用不同 Tokenizer,逐位置 Logit 蒸馏通常不再成立。可将教师生成的最终回答作为学生的文本目标,或只蒸馏任务标签、评分与偏好信号,让“语义目标一致”替代“词表位置一致”。
把对齐检查放进流水线闸门
稳定流水线应在训练前为教师和学生记录一份 Tokenizer 签名,至少包含词表大小、关键 special token ID、Chat Template 摘要、truncation_side 和 max_length。再抽取一小批固定样本做双侧编码,只要词表维度、模板或关键位置不满足预期就直接终止任务。
这样做的价值不是保证两个模型一定使用完全相同的 Tokenizer,而是让“是否允许不同”变成显式设计决策:共享词表时才能安全做逐 Token Logit 对齐;不共享词表时,应在损失设计阶段切换到能跨 Tokenizer 对齐的蒸馏目标。