
大模型原理与训练 / 系统课时
做并发压测观察性能退化
做并发压测观察性能退化
本节把单次推理性能变成可上线的并发边界:用固定工作负载逐级增加并发,持续记录延迟分位数、吞吐、排队和显存,找出量化模型从稳定区进入饱和区的拐点,并把它转成服务可承诺的并发范围。
学习目标
- 设计可重复的阶梯式并发压测,避免把请求长度变化误判为并发退化。
- 同时观察排队、P50/P95/P99、吞吐和显存,识别真正的饱和拐点。
- 根据压测结果给线上并发上限留出安全余量,并完成复测验收。
先固定压测口径
并发压测最容易犯的错误,是并发升高的同时输入长度、输出长度或生成参数也在变化。先固定模型版本、量化配置、GPU、提示词、最大输出长度和温度;正式采样前做一轮预热,避免首次加载、CUDA Kernel 初始化和缓存建立污染结果。
每个并发档位至少记录四组信息:服务端排队时间、端到端延迟的 P50/P95/P99、请求吞吐或输出 Token 吞吐、GPU 显存占用。排队时间应优先读取推理服务或网关自身暴露的队列指标,因为客户端总耗时无法准确拆出服务器内部等待。
用阶梯并发跑出延迟与吞吐
下面脚本面向 OpenAI 兼容的 chat/completions 接口,以相同请求分别测试 1、2、4、8、16 并发。通过环境变量替换服务地址和模型名即可运行;如果你的服务不是 OpenAI 兼容协议,需要只改 payload 和响应解析部分。
import concurrent.futures
import json
import os
import time
import urllib.request

URL = os.environ.get(
    "LLM_URL",
    "http://127.0.0.1:8000/v1/chat/completions",
)
MODEL = os.environ.get("MODEL_NAME", "quant-model")
LEVELS = [1, 2, 4, 8, 16]
REQUESTS_PER_LEVEL = 24

payload = {
    "model": MODEL,
    "messages": [{"role": "user", "content": "用三句话解释什么是模型量化。"}],
    "temperature": 0.0,
    "max_tokens": 64,
    "stream": False,
}

def one_request():
    # 每次都发送完全相同的工作负载,避免长度差异影响对比。
    body = json.dumps(payload).encode("utf-8")
    req = urllib.request.Request(
        URL,
        data=body,
        headers={"Content-Type": "application/json"},
        method="POST",
    )
    started = time.perf_counter()
    with urllib.request.urlopen(req, timeout=120) as resp:
        data = json.loads(resp.read().decode("utf-8"))
    latency_ms = (time.perf_counter() - started) * 1000
    output_tokens = data.get("usage", {}).get("completion_tokens", 0)
    return latency_ms, output_tokens

def percentile(values, q):
    values = sorted(values)
    index = round((len(values) - 1) * q)
    return values[index]

def run_level(concurrency):
    wall_started = time.perf_counter()
    with concurrent.futures.ThreadPoolExecutor(max_workers=concurrency) as pool:
        results = list(pool.map(lambda _: one_request(), range(REQUESTS_PER_LEVEL)))
    wall_s = time.perf_counter() - wall_started
    latencies = [item[0] for item in results]
    tokens = sum(item[1] for item in results)
    return (
        percentile(latencies, 0.50),
        percentile(latencies, 0.95),
        percentile(latencies, 0.99),
        REQUESTS_PER_LEVEL / wall_s,
        tokens / wall_s if tokens else 0.0,
    )

print("concurrency,p50_ms,p95_ms,p99_ms,req_s,out_tok_s")
for concurrency in LEVELS:
    metrics = run_level(concurrency)
    print(
        f"{concurrency},{metrics[0]:.1f},{metrics[1]:.1f},"
        f"{metrics[2]:.1f},{metrics[3]:.2f},{metrics[4]:.2f}"
    )
预期输出
concurrency,p50_ms,p95_ms,p99_ms,req_s,out_tok_s
1,<LATENCY>,<LATENCY>,<LATENCY>,<THROUGHPUT>,<TOKEN_THROUGHPUT>
2,<LATENCY>,<LATENCY>,<LATENCY>,<THROUGHPUT>,<TOKEN_THROUGHPUT>
4,<LATENCY>,<LATENCY>,<LATENCY>,<THROUGHPUT>,<TOKEN_THROUGHPUT>
8,<LATENCY>,<LATENCY>,<LATENCY>,<THROUGHPUT>,<TOKEN_THROUGHPUT>
16,<LATENCY>,<LATENCY>,<LATENCY>,<THROUGHPUT>,<TOKEN_THROUGHPUT>
<LATENCY> 等实际值取决于模型、GPU 和服务实现。为了同步观察显存与 GPU 利用率,可在另一终端运行:
watch -n 1 'nvidia-smi --query-gpu=timestamp,memory.used,utilization.gpu --format=csv,noheader,nounits'预期输出
<TIME>, <MEMORY_USED_MB>, <GPU_UTIL_PERCENT>
<TIME>, <MEMORY_USED_MB>, <GPU_UTIL_PERCENT>
找出稳定区、拐点和饱和区
把并发作为横轴时,理想的稳定区表现为吞吐继续上升,而 P95/P99 只缓慢增长,队列长度也能快速回落。进入拐点后,吞吐的边际增益开始变小,但尾延迟和排队会明显加速;继续增加并发,如果吞吐几乎不再增长甚至下降,就已经进入饱和区。
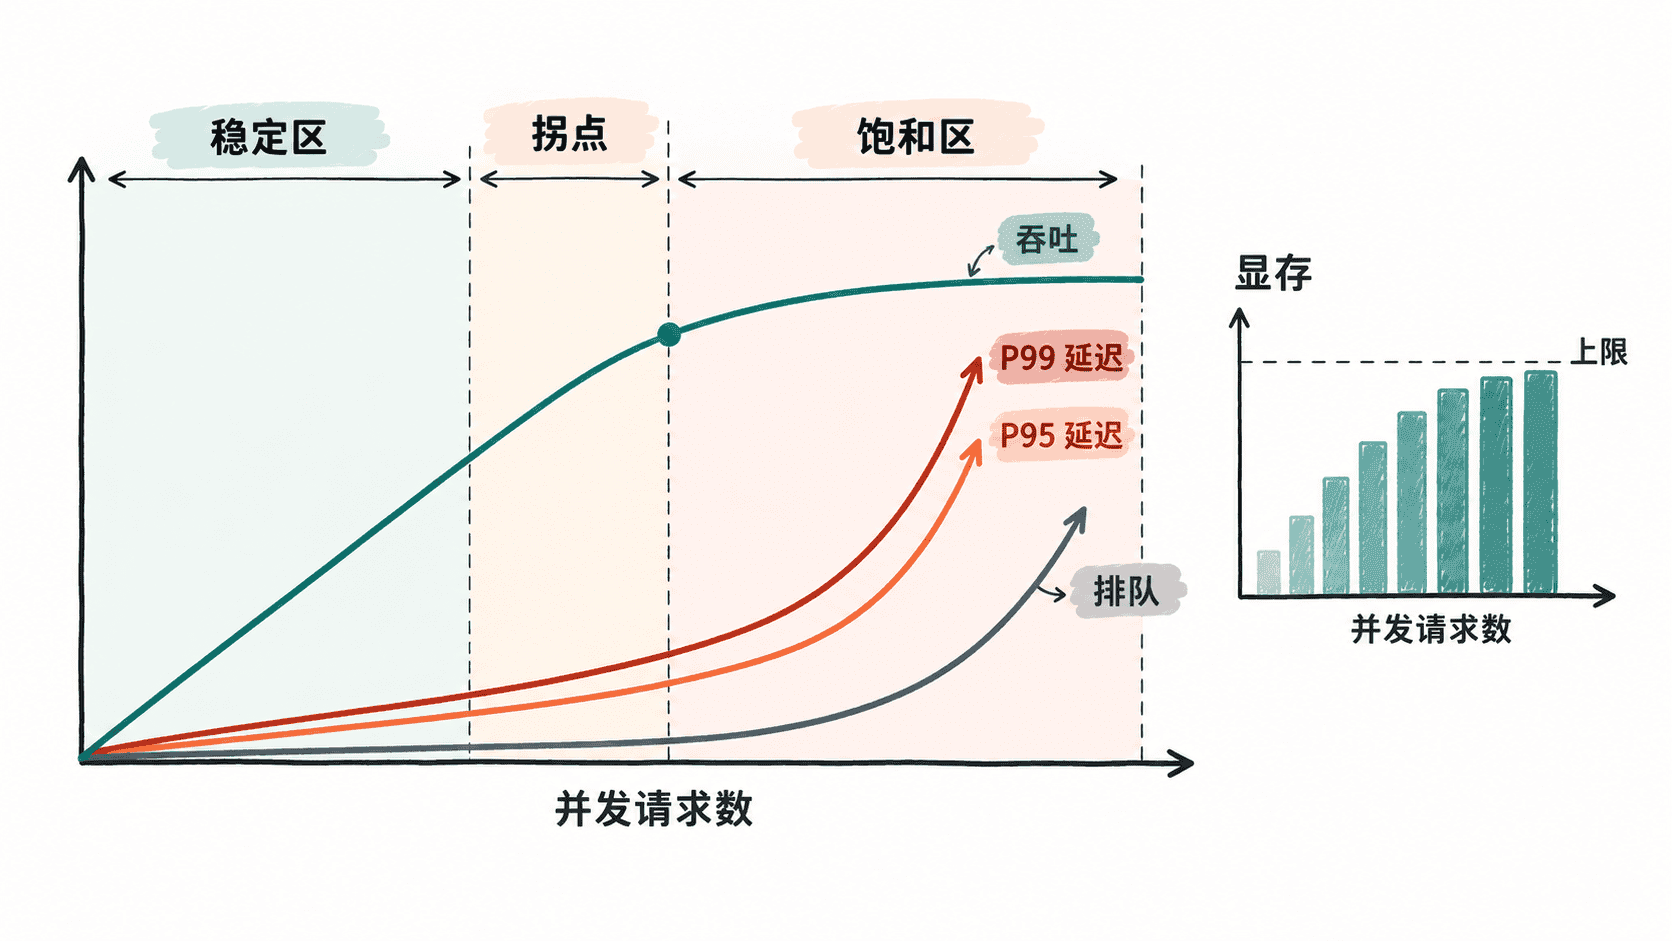
不要只看平均延迟。平均值可能仍然平稳,但少量请求已经在队列里等待很久;上线体验通常更接近 P95/P99。也不要只看 GPU 利用率,GPU 达到高利用率并不等于服务已经不可接受,真正的边界仍要由延迟、队列和吞吐共同决定。
把拐点转成可承诺并发
先确定业务 SLO,例如 P95 延迟上限、错误率上限和最低吞吐,再从压测结果中选择“仍满足 SLO 且队列不会持续增长”的最高并发档位。生产并发上限应低于这个技术极限,为流量抖动、长请求和后台任务留出余量,而不是把拐点本身直接当作承诺值。
正式验收时,同一并发档位至少重复多轮,并分别覆盖短输入、长输入和接近最大输出长度的请求。若量化模型在稳定区内显存更低、吞吐更高,但在高并发处尾延迟突然恶化,也应以业务 SLO 为准缩小承诺范围,而不是只因为“平均吞吐更高”就放宽并发。