
大模型原理与训练 / 系统课时
搭好训练与量化实验环境
搭好训练与量化实验环境
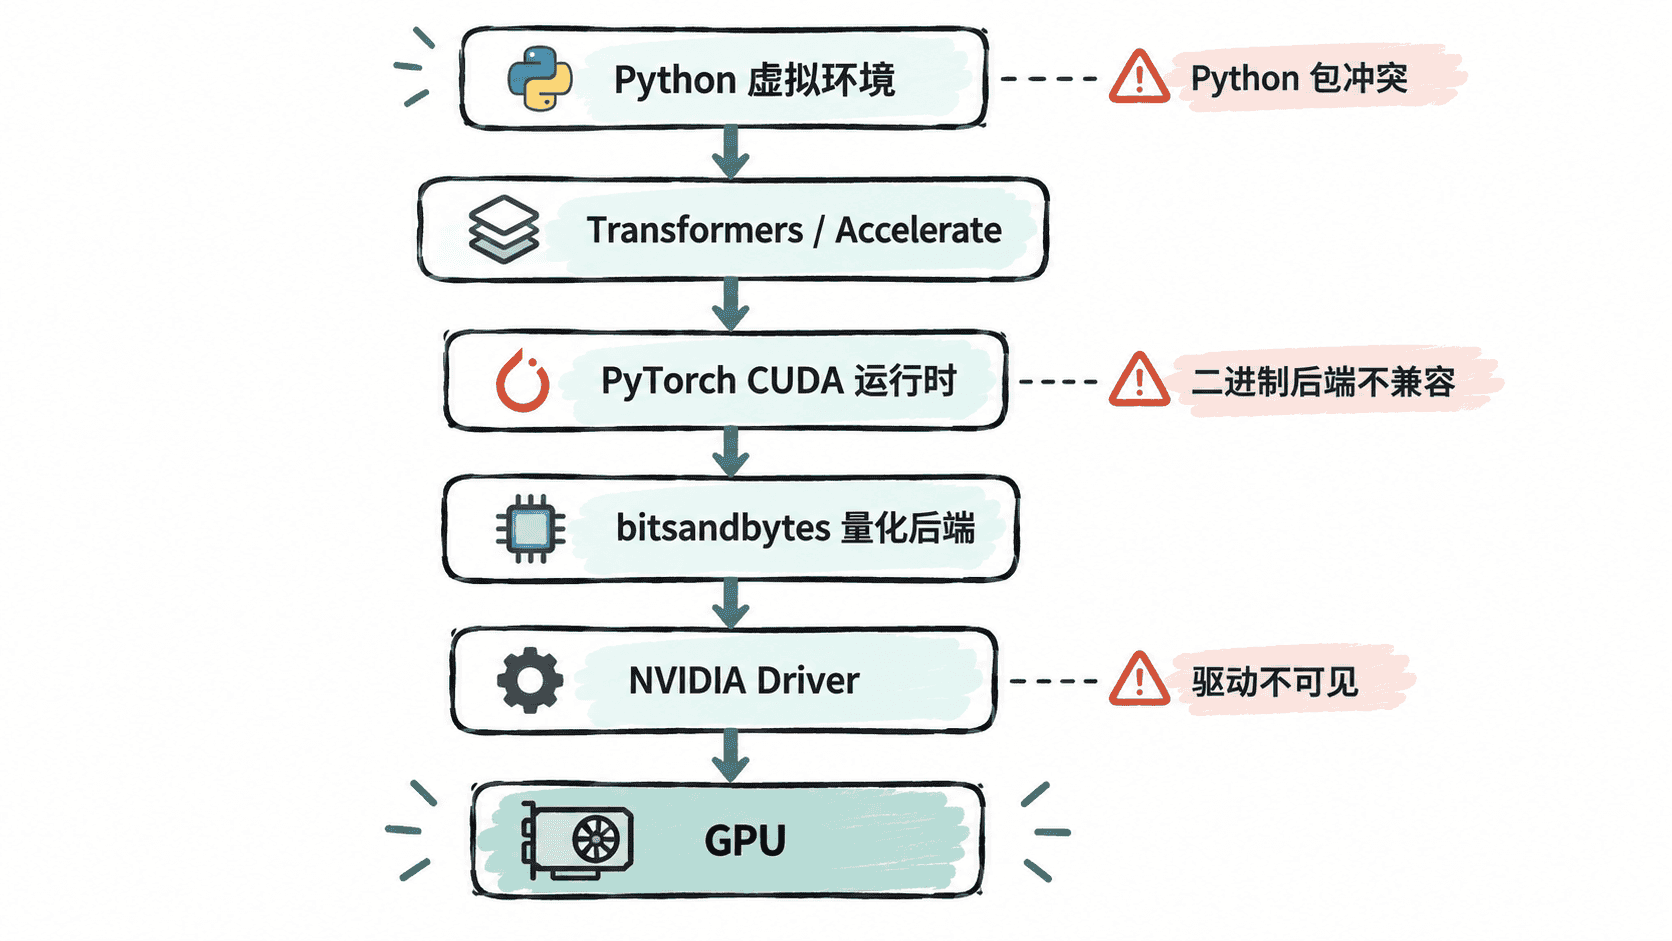
这一步的目标不是“把包装上就算完成”,而是建立一个可复现、能识别 GPU、能导入量化后端并成功加载模型的最小环境。完成后,你应能区分 Python 依赖问题、CUDA 运行时问题和驱动或二进制兼容问题。
学习目标
- 建立隔离的 Python 环境并安装训练、推理与量化依赖。
- 验证 PyTorch CUDA、GPU 可见性和量化库导入状态。
- 完成一次真实模型加载,并按层次定位常见二进制依赖故障。
先检查系统边界
建议使用 64 位 Python,并优先在 Linux 或 WSL2 中完成 NVIDIA GPU 实验。先确认 nvidia-smi 能看到显卡;如果这里失败,Python 层再怎么重装包也不会解决驱动或设备访问问题。
PyTorch 的预编译包通常自带所需 CUDA 运行时组件,因此“系统没有 nvcc”不等于 PyTorch 不能用 GPU。真正要对齐的是 NVIDIA 驱动、PyTorch 构建所带 CUDA 运行时、GPU 架构,以及 bitsandbytes 等额外二进制后端。
建立最小可复现实验环境
以下命令以 Linux/WSL2 为例。创建独立虚拟环境后,只安装当前实验需要的核心包,避免把系统 Python 中已有的 CUDA 相关包混进来。
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install torch transformers accelerate bitsandbytes
python -m pip check
预期输出
No broken requirements found.安装过程中的下载日志和版本号会因平台而不同;这里真正要检查的是最后的依赖一致性结果。如果 pip check 报冲突,先解决 Python 包版本问题,再继续验证 GPU。
验证 CUDA 与模型加载
下面的脚本会同时检查 PyTorch 是否识别 CUDA、输出 GPU 名称、导入量化库,并从 Hugging Face Hub 加载一个很小的 GPT-2 测试模型。首次运行需要联网下载模型文件。
import torch
import bitsandbytes as bnb
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "sshleifer/tiny-gpt2"

if not torch.cuda.is_available():
    raise SystemExit("CUDA is not available to PyTorch")

device_name = torch.cuda.get_device_name(0)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(MODEL_ID).to("cuda")

inputs = tokenizer("hello", return_tensors="pt").to("cuda")
with torch.inference_mode():
    outputs = model(**inputs)

print(f"cuda_available={torch.cuda.is_available()}")
print(f"gpu={device_name}")
print(f"bitsandbytes={bnb.__version__}")
print(f"model={model.__class__.__name__}")
print(f"logits_device={outputs.logits.device.type}")
预期输出
cuda_available=True
gpu=<GPU_NAME>
bitsandbytes=<VERSION>
model=GPT2LMHeadModel
logits_device=cuda
<GPU_NAME> 与 <VERSION> 会随机器和安装版本变化。只要模型能完成一次前向计算并且 logits_device=cuda,就说明从 Python、Transformers 到 PyTorch CUDA 的主链路已经跑通。
按层次处理典型失败
如果 nvidia-smi 正常但 torch.cuda.is_available() 为 False,先确认当前解释器确实来自 .venv,再检查安装的 PyTorch 是否为带 CUDA 支持的构建。不要先去改 LD_LIBRARY_PATH,因为错误地注入系统 CUDA 动态库反而可能覆盖 PyTorch 自带运行时。
如果 torch 可用而 import bitsandbytes 失败,问题通常已经缩小到量化后端自身:平台不受支持、二进制架构不匹配,或加载到了错误的共享库。此时记录完整异常、Python 版本、PyTorch 版本和 GPU 型号,再决定是否更换 bitsandbytes 版本或改用其他量化后端。
如果模型下载失败,则把它与 GPU 问题分开处理:认证、代理、证书、缓存目录权限都属于模型获取链路。只有模型成功下载且前向计算落在 CUDA 上,才算真正完成训练与量化实验环境的基线验收。