
大模型原理与训练 / 系统课时
选择离线还是在线蒸馏
选择离线还是在线蒸馏
离线蒸馏先把教师输出变成固定训练数据,在线蒸馏则让教师在学生训练过程中实时参与计算。两者迁移的教师能力可以相似,但成本、吞吐、随机性和可复现性完全不同,本节给出可直接用于项目选型的判断方法。
学习目标
- 解释离线蒸馏与在线蒸馏的数据流和资源差异
- 从成本、吞吐、随机性和可复现性比较两种方案
- 根据教师可用性、预算和实验节奏选择合适模式
两种方案改变的是教师出现的位置
离线蒸馏把教师推理与学生训练拆成两个阶段。先让教师处理训练样本,保存答案、标签或 logits,再只使用这些固定结果训练学生。教师不需要在每个训练 step 中保持在线。
在线蒸馏则把教师放进训练循环。同一批输入进入教师与学生,训练过程即时计算教师目标并更新学生。教师结果可以随采样、数据增强或训练策略变化,但训练期间必须持续支付教师计算成本。
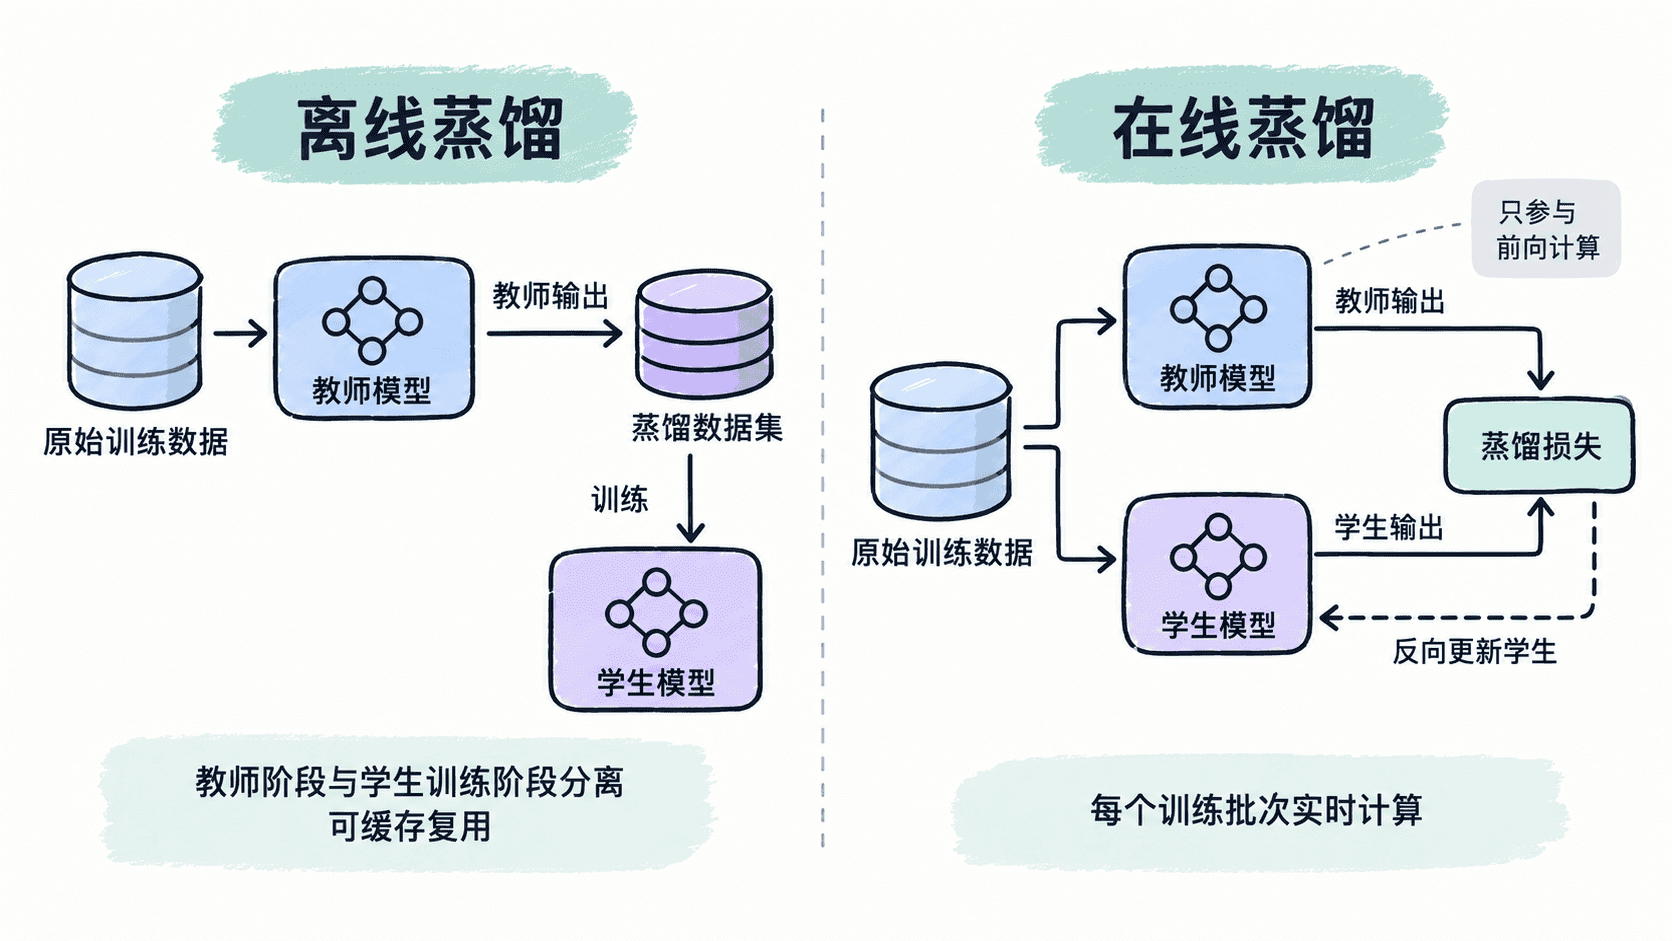
离线蒸馏换取稳定与高吞吐
离线方案最明显的优势是学生训练与教师解耦。教师输出生成一次后,可以供不同学生结构、超参数和训练策略重复使用,也可以在教师服务暂时不可用时继续实验。
这种方式尤其适合教师很大、教师只能通过有限额度的 API 使用,或者团队需要频繁重复学生实验的场景。由于训练阶段只读取普通数据,吞吐更容易预测,多机训练也不需要额外协调教师推理服务。
代价是存储与数据新鲜度。若只保存最终答案,空间通常可控;若保存每个 token 的完整 logits,数据规模可能远大于原始文本。教师结果一旦生成,后续更改提示模板、采样策略或数据增强规则通常意味着重新生成相应数据。
在线蒸馏保留更强的动态性
在线蒸馏可以让教师看到训练期间动态产生的输入。例如随机数据增强改变了样本,教师可以针对新样本实时给出目标,而不是只能依赖预先生成的固定答案。
如果需要蒸馏完整概率分布或内部表示,在线方式也避免了把海量中间结果长期落盘。学生得到的是当前批次对应的教师信号,因此训练逻辑更加直接。
代价是教师推理进入关键训练路径。教师计算慢时,学生 GPU 可能等待教师;教师需要额外 GPU 时,总显存和集群资源会明显增加。若教师通过远程服务访问,还要考虑请求延迟、并发限制和服务故障。
可复现性是重要分界线
离线数据一旦冻结,同一个样本通常可以反复读取相同教师目标,因此更容易比较不同学生实验。只要数据版本、代码和随机种子一致,教师侧随机性不会在每轮训练中重新出现。
在线方案若使用随机采样教师,同一输入在不同 step 可能得到不同输出。即便教师采用确定性解码,模型服务版本变化、动态路由或预处理变化也可能让实验结果漂移。因此需要更严格地固定教师版本、推理参数和服务配置。
按实验约束做选择
| 约束 | 更倾向离线蒸馏 | 更倾向在线蒸馏 |
|---|---|---|
| 教师调用昂贵 | 是,可一次生成后复用 | 否,每轮训练持续调用 |
| 学生实验频繁 | 是,同一教师数据可重复使用 | 成本随实验次数增加 |
| 输入会动态增强 | 固定数据覆盖有限 | 是,可实时产生教师目标 |
| 需要完整 logits 或内部表示 | 可能产生巨大存储 | 可即时计算后丢弃 |
| 强调实验可复现 | 更容易冻结教师结果 | 需要严格控制教师随机性 |
| 教师服务不稳定或额度有限 | 更安全 | 容易阻塞训练 |
项目早期通常更适合离线蒸馏:它把教师成本变成一次性数据准备工作,便于快速比较学生配置。当实验已经证明有效,并且固定教师数据成为能力上限,例如需要动态增强、持续生成软目标或内部层监督时,再切换到在线蒸馏更合理。