
大模型原理与训练 / 系统课时
检查显卡与算子支持范围
检查显卡与算子支持范围
量化方案不能只看“显卡有多少显存”。同一张 GPU 是否能高效运行 BF16、FP16、INT8 或 INT4,还取决于计算能力、驱动与 PyTorch 运行时,以及推理后端是否为目标格式提供对应内核。本节建立一套从硬件到实际加载的验证顺序。
学习目标
- 读取 GPU 计算能力、显存和 PyTorch 的 BF16 支持状态。
- 区分“硬件理论可用”和“推理后端实际可用”。
- 用真实量化模型加载测试提前发现 INT8、INT4 与后端不匹配问题。
先读取硬件事实
不要凭显卡名称猜支持范围。先让当前 Python 环境直接读取设备属性,这能同时确认进程看到的是哪张卡。
import torch

if not torch.cuda.is_available():
    raise SystemExit("CUDA is not available")

props = torch.cuda.get_device_properties(0)
major, minor = torch.cuda.get_device_capability(0)
total_gib = props.total_memory / 1024**3

print(f"gpu={props.name}")
print(f"compute_capability={major}.{minor}")
print(f"memory_gib={total_gib:.1f}")
print(f"torch_cuda={torch.version.cuda}")
print(f"bf16_supported={torch.cuda.is_bf16_supported()}")
预期输出
gpu=<GPU_NAME>
compute_capability=<MAJOR>.<MINOR>
memory_gib=<GIB>
torch_cuda=<CUDA_VERSION>
bf16_supported=<True_OR_FALSE>
这些值是后续判断的输入,不是最终结论。尤其是 INT8、INT4,不能仅凭 Compute Capability 宣布“支持”,因为真正执行时还要经过 Transformers、bitsandbytes、TensorRT-LLM、vLLM 或其他后端提供的具体算子实现。
用验证顺序代替硬编码结论
精度或量化格式的可用性可以按下面的层次判断:
| 格式 | 第一检查项 | 仍需确认的内容 |
|---|---|---|
| BF16 | torch.cuda.is_bf16_supported() |
推理后端是否保留 BF16 内核与算子覆盖 |
| FP16 | CUDA 可见、模型可转为 FP16 | 目标算子是否走高效半精度内核而非回退 |
| INT8 | 后端声明支持该 GPU 与量化格式 | 模型结构、权重格式、算子内核是否匹配 |
| INT4 | 后端声明支持对应 4bit 格式 | NF4、GPTQ、AWQ 等格式是否被当前后端直接接受 |
显存也要单独估算。权重从 16 bit 降到 8 bit 或 4 bit 会降低权重占用,但 KV Cache、激活、临时工作区和框架开销不会按同样比例缩小,因此不能用“模型参数量 × 位宽”直接当成整机显存需求。
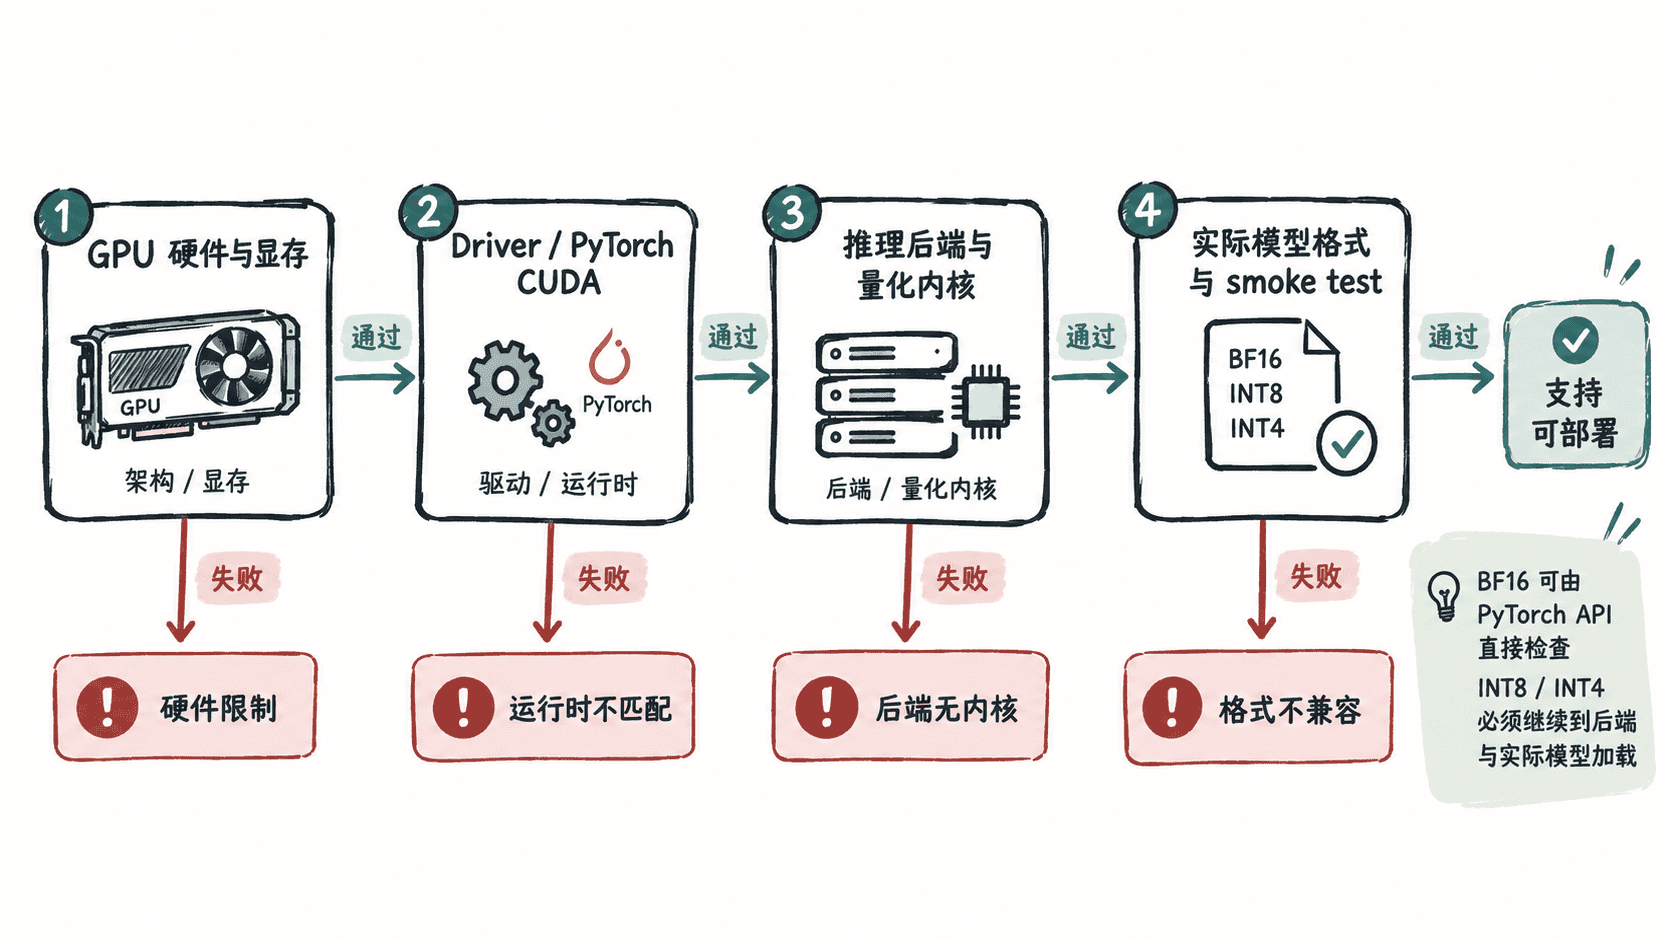
用实际加载验证 INT8 与 INT4
下面的脚本用 bitsandbytes 分别尝试 8bit 与 4bit 加载一个小模型。它比“导入包成功”更有价值,因为会真正经过 Transformers 的量化集成、设备映射和后端内核初始化。首次运行需要联网。
import gc
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig

MODEL_ID = "sshleifer/tiny-gpt2"

if not torch.cuda.is_available():
    raise SystemExit("CUDA is not available")

tests = {
    "int8": BitsAndBytesConfig(load_in_8bit=True),
    "int4": BitsAndBytesConfig(load_in_4bit=True),
}

for name, quant_config in tests.items():
    try:
        model = AutoModelForCausalLM.from_pretrained(
            MODEL_ID,
            quantization_config=quant_config,
            device_map="auto",
        )
        print(f"{name}=ok")
        del model
        gc.collect()
        torch.cuda.empty_cache()
    except Exception as exc:
        print(f"{name}=failed:{type(exc).__name__}")
预期输出
int8=ok
int4=ok
如果某一项输出 failed:<ERROR_TYPE>,不要立刻认定显卡“不支持低比特”。这只说明当前“GPU + 驱动 + PyTorch + Transformers + bitsandbytes + 模型格式”组合没有通过验证,应保留完整异常信息继续定位。
决定上线格式
最终选择应以实际推理后端为准,而不是训练环境里某个库能不能加载。计划用 vLLM,就检查目标 vLLM 版本接受哪些量化格式;计划用 TensorRT-LLM,就按其构建与运行时支持矩阵验证;计划直接用 Transformers,则以 Transformers 与量化后端的组合测试为准。
同一模型如果 BF16 能跑但 INT4 失败,通常意味着量化格式或后端内核不匹配,而不是模型本身不可部署。上线前至少保留一份“设备属性、后端版本、量化格式、实际加载结果”的记录,这比单独记显卡型号更能预测迁移到另一台机器后是否还能正常运行。