
大模型原理与训练 / 系统课时
评估学生模型能力迁移效果
评估学生模型能力迁移效果
蒸馏是否成功,不能只看一个准确率上涨。可靠评估要在同一评测条件下同时比较教师、原学生和蒸馏后学生的质量、延迟与参数规模,并用未参与蒸馏训练的任务验证提升是否能够迁移。
学习目标
- 建立教师、原学生与蒸馏后学生的公平对比口径
- 同时解读质量、速度、参数规模与未见任务表现
- 用留出任务和数据去重判断能力迁移而不是样本记忆
先固定评测边界
三组模型必须使用同一批测试样本、同一输入预处理、同一最大输出长度和同一评分脚本。生成式任务还应固定解码策略;若测吞吐与延迟,则要固定硬件、精度、批大小、并发度和预热轮数,否则速度差异可能只是运行条件不同。
质量指标要跟任务匹配:分类可用 Accuracy 或 F1,生成可用 ROUGE、BLEU、任务判分器或人工评分,代码任务可用 pass@k。不要把多个性质不同的指标强行平均成一个“总分”,先分别看清变化方向。
用四个维度判断迁移是否成立
至少保留四类结果:已参与蒸馏任务的质量、未参与训练任务的质量、端到端推理速度,以及参数量或显存占用。原学生是关键基线,因为它回答“提升是否来自蒸馏”,教师则给出能力上限与成本参照。
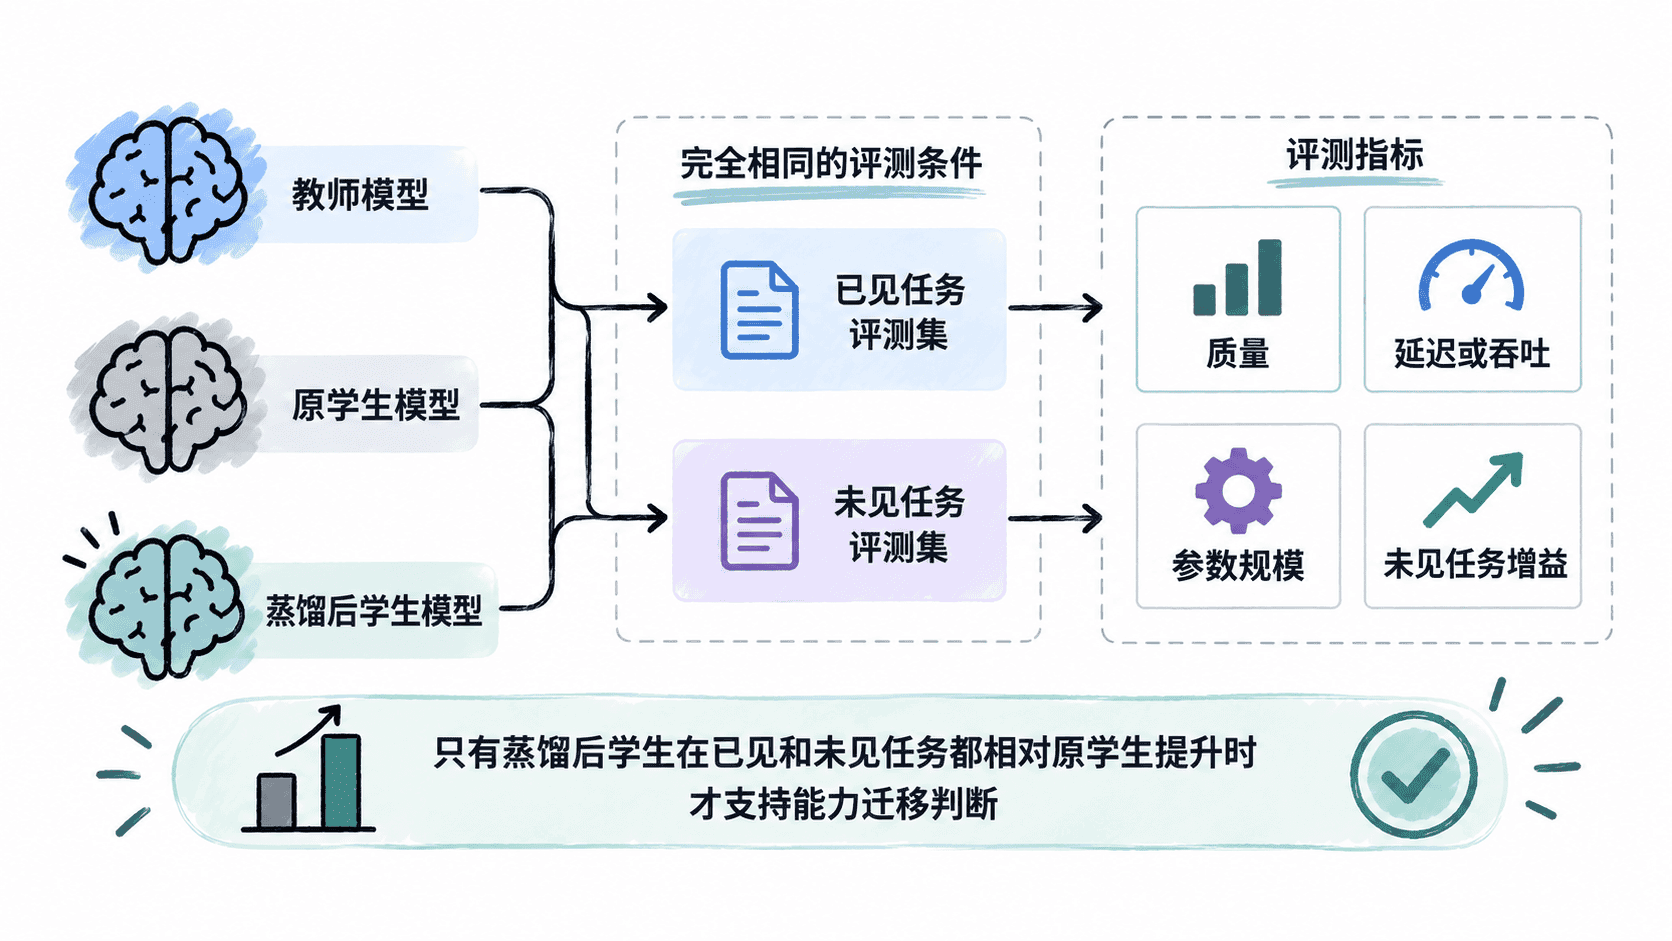
若蒸馏后学生只在训练同分布任务上涨,而未见任务无提升甚至下降,应优先怀疑模板记忆、数据污染或过拟合;若两个任务族都稳定优于原学生,且仍保持学生模型的体量与速度优势,迁移证据更强。
用同一脚本汇总三组结果
下面示例假设各模型的原始推理与打分已经完成,脚本只负责统一汇总。示例数据是演示值,实际项目应替换为同一评测环境得到的真实结果。
models = {
    "teacher": {"seen": 0.92, "unseen": 0.88, "latency_ms": 42.0, "params_m": 340},
    "original_student": {"seen": 0.78, "unseen": 0.74, "latency_ms": 18.0, "params_m": 110},
    "distilled_student": {"seen": 0.87, "unseen": 0.83, "latency_ms": 19.0, "params_m": 110},
}

for name, m in models.items():
    print(
        f"{name:17s} seen={m['seen']:.3f} unseen={m['unseen']:.3f} "
        f"latency={m['latency_ms']:.1f}ms params={m['params_m']}M"
    )

teacher = models["teacher"]
base = models["original_student"]
distilled = models["distilled_student"]

seen_gain = distilled["seen"] - base["seen"]
unseen_gain = distilled["unseen"] - base["unseen"]
seen_gap = (distilled["seen"] - base["seen"]) / (teacher["seen"] - base["seen"])
unseen_gap = (distilled["unseen"] - base["unseen"]) / (teacher["unseen"] - base["unseen"])
speedup = teacher["latency_ms"] / distilled["latency_ms"]
param_reduction = 1 - distilled["params_m"] / teacher["params_m"]

print(f"seen_gain={seen_gain:+.3f}")
print(f"unseen_gain={unseen_gain:+.3f}")
print(f"teacher_gap_closed_seen={seen_gap:.1%}")
print(f"teacher_gap_closed_unseen={unseen_gap:.1%}")
print(f"speedup_vs_teacher={speedup:.2f}x")
print(f"parameter_reduction_vs_teacher={param_reduction:.1%}")
预期输出
teacher           seen=0.920 unseen=0.880 latency=42.0ms params=340M
original_student  seen=0.780 unseen=0.740 latency=18.0ms params=110M
distilled_student seen=0.870 unseen=0.830 latency=19.0ms params=110M
seen_gain=+0.090
unseen_gain=+0.090
teacher_gap_closed_seen=64.3%
teacher_gap_closed_unseen=64.3%
speedup_vs_teacher=2.21x
parameter_reduction_vs_teacher=67.6%
这里的“教师差距追回比例”比单独看绝对分数更有解释力:它表示学生通过蒸馏追回了多少原本与教师之间的能力差距。不过分母很小时该比例会失真,因此仍要同时报告原始指标。
排除数据记忆再下结论
未见任务必须真正与蒸馏训练解耦。先对蒸馏输入、教师答案和评测集做精确去重,再做近重复检查;若评测样本或高相似改写曾出现在蒸馏数据中,就不能把该结果当作迁移证据。
还要检查提升是否跨题型、长度和难度层级出现。若增益只集中在与教师样本模板相似的子集,而换表达方式后迅速消失,更像记忆。更可靠的结论是:蒸馏后学生在多个未见切片上都优于原学生,同时没有明显牺牲延迟、吞吐或显存目标。
最终报告应把“质量提升”和“部署收益”并列呈现,而不是只宣布学生接近教师。只有当未见任务也出现可重复增益,并且成本仍符合部署约束时,才能把这次蒸馏判定为有效的能力迁移。