
大模型原理与训练 / 系统课时
生成可复用的教师响应数据
生成可复用的教师响应数据
蒸馏数据真正难的不是“多生成一些回答”,而是让每条样本都可追溯、可复现、可重新评测。本节给出一套最小数据契约、提示覆盖方法和批量生成脚本,把教师响应沉淀成可重复使用的 JSONL 数据集。
学习目标
- 设计覆盖正常路径、边界条件和失败模式的提示集
- 固定教师采样参数,并记录足够的模型与提示元数据
- 生成、校验并保存可追溯的教师响应 JSONL
先定义可复用的数据契约
只保存 prompt 和 answer 不够。模型版本、提示模板、采样参数一旦变化,同一句提示就可能产生不同回答;后续发现异常时,也无法判断问题来自教师、模板还是采样策略。
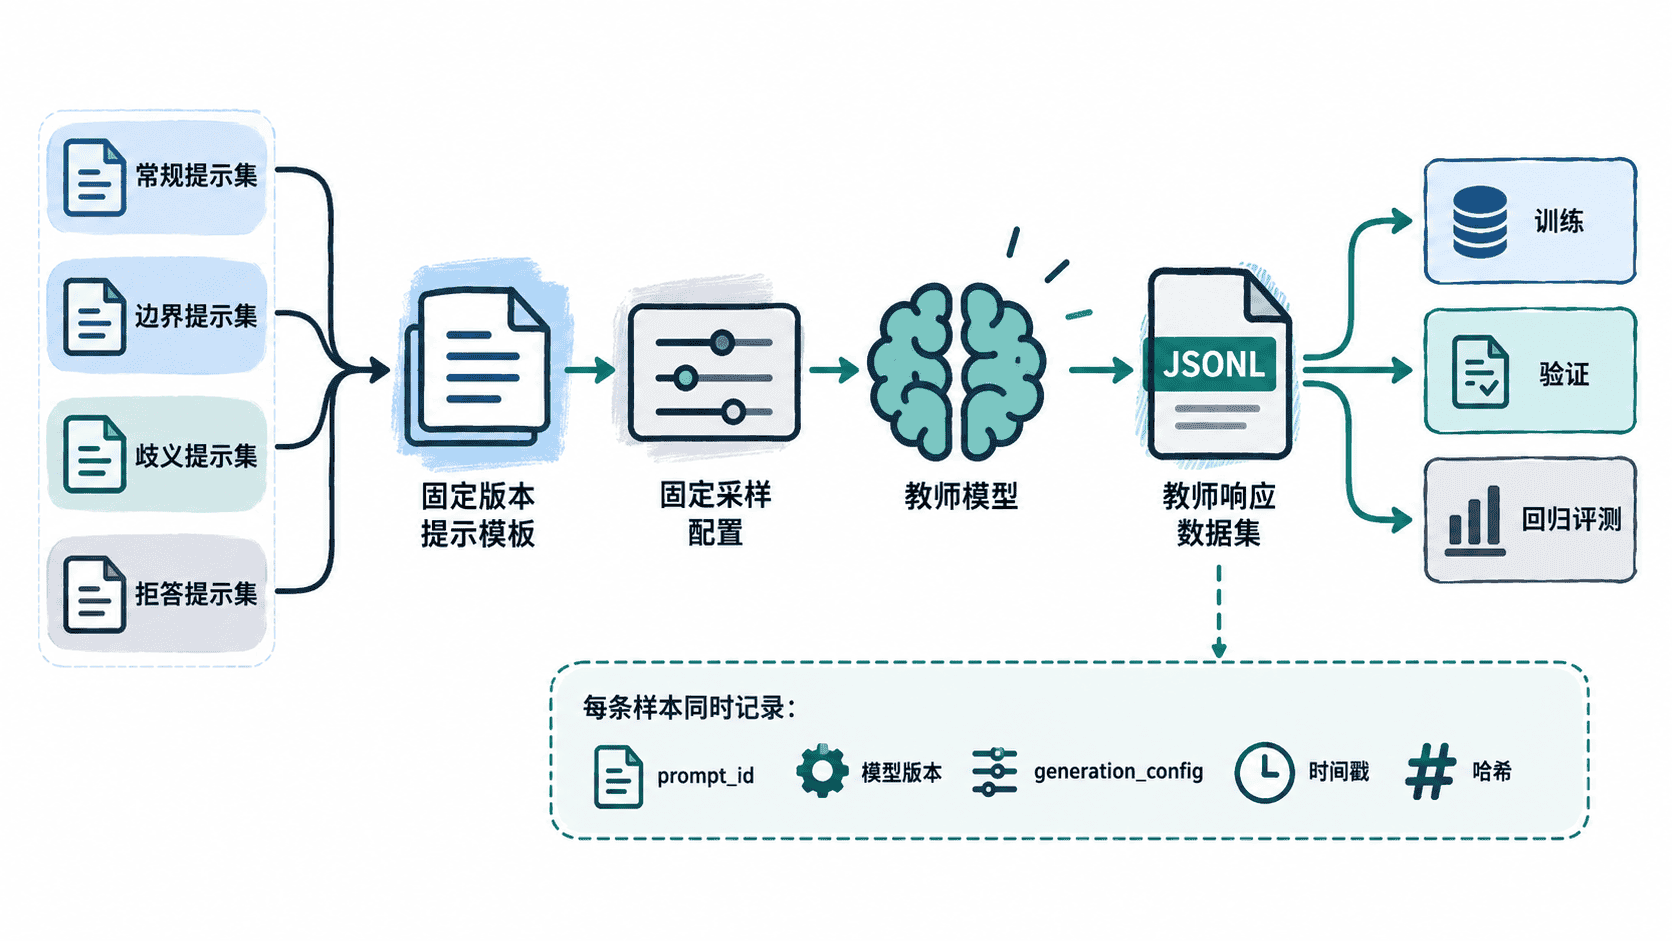
每条样本至少保存这些信息:稳定的 prompt_id、原始提示 prompt、教师回答 teacher_response、教师模型标识 teacher_model、完整 generation_config、提示模板版本 prompt_version、生成时间以及内容哈希。训练集、验证集和回归评测集还应使用稳定规则分配,避免每次随机切分造成指标漂移。
用覆盖矩阵设计提示集
提示集应覆盖任务边界,而不是只收集最容易的成功案例。一个实用的最小矩阵通常包括:常规输入、长度或数值边界、信息缺失或歧义输入,以及明确要求拒答或说明不确定性的输入。
对分类、抽取、结构化生成等任务,还要刻意覆盖标签长尾和格式边界。例如目标输出是 JSON,就应加入空列表、多实体、特殊字符和无法抽取等样本。每个类别设定最低样本数,再分层抽样,比单纯随机抓取更容易发现教师在长尾条件下的行为缺口。
固定采样并批量落盘
下面的脚本面向兼容常见 Chat Completions 请求格式的教师服务。它只依赖 Python 标准库,通过环境变量读取端点、令牌和模型名,固定温度、top_p、最大生成长度和随机种子,并把请求所需的关键元数据连同响应写入 JSONL。若你的教师服务字段不同,只需要替换 call_teacher 中的请求与解析逻辑,数据契约可以保持不变。
import hashlib
import json
import os
import urllib.request
from datetime import datetime, timezone

TEACHER_URL = os.environ["TEACHER_URL"]
TEACHER_API_KEY = os.environ["TEACHER_API_KEY"]
TEACHER_MODEL = os.environ["TEACHER_MODEL"]

# 固定采样配置,并把它原样写入每条记录以支持复现。
GENERATION_CONFIG = {
    "temperature": 0.2,
    "top_p": 0.9,
    "max_tokens": 256,
    "seed": 20260913,
}
PROMPT_VERSION = "distill-v1"

PROMPTS = [
    ("normal-001", "把下面文本归类为 billing、technical 或 other:无法登录后台"),
    ("edge-001", "把下面文本归类为 billing、technical 或 other:"),
    ("uncertain-001", "信息不足时先说明不确定:用户说“它坏了”,应该归到哪类?"),
]

def call_teacher(prompt: str) -> str:
    # 这里只封装教师调用;更换供应商时保持外层数据契约不变。
    payload = {
        "model": TEACHER_MODEL,
        "messages": [{"role": "user", "content": prompt}],
        **GENERATION_CONFIG,
    }
    request = urllib.request.Request(
        TEACHER_URL,
        data=json.dumps(payload).encode("utf-8"),
        headers={
            "Authorization": f"Bearer {TEACHER_API_KEY}",
            "Content-Type": "application/json",
        },
        method="POST",
    )
    with urllib.request.urlopen(request, timeout=60) as response:
        body = json.loads(response.read().decode("utf-8"))
    return body["choices"][0]["message"]["content"]

def sha256_text(text: str) -> str:
    return hashlib.sha256(text.encode("utf-8")).hexdigest()

def main() -> None:
    output_path = "teacher_responses.jsonl"
    with open(output_path, "w", encoding="utf-8") as f:
        # 原始响应直接落盘,清洗应在后续训练视图中完成。
        for prompt_id, prompt in PROMPTS:
            answer = call_teacher(prompt)
            record = {
                "prompt_id": prompt_id,
                "prompt": prompt,
                "teacher_response": answer,
                "teacher_model": TEACHER_MODEL,
                "generation_config": GENERATION_CONFIG,
                "prompt_version": PROMPT_VERSION,
                "created_at": datetime.now(timezone.utc).isoformat(),
                "prompt_sha256": sha256_text(prompt),
                "response_sha256": sha256_text(answer),
            }
            f.write(json.dumps(record, ensure_ascii=False) + "\n")
    print(f"saved={len(PROMPTS)} path={output_path}")

if __name__ == "__main__":
    main()
预期输出:
saved=3 path=teacher_responses.jsonl实际教师回答和 created_at 会随服务状态与执行时间变化;如果教师端真正支持固定 seed,重复请求通常更稳定,但仍应以落盘的原始响应和哈希作为审计依据。
生成后先做数据验收
采集完成后不要立刻进入训练。先检查三类问题:结构字段是否齐全、教师回答是否为空或截断、同一 prompt_id 是否重复。对于结构化任务,还应重新解析教师输出,统计 JSON 解析失败率、标签越界率或必填字段缺失率。
训练前再冻结一份不可修改的原始数据,并从它派生训练视图。这样后续更换清洗规则、过滤阈值或学生模型时,可以重新构建数据集并复现实验,而不是重新向教师模型付费采样。