
大模型原理与训练 / 系统课时
准备代表性量化校准数据
准备代表性量化校准数据
训练后量化会从校准样本中估计激活范围或统计量,因此校准集偏向短文本、单一主题或单一格式时,生成的 Scale 也会随之偏移。本节建立一套从真实请求分层抽样、控制长度到使用独立留出集验证误差的最小流程。
学习目标
- 按长度、主题和输入格式构造代表性校准集
- 控制校准样本数量与序列长度,避免统计分布被人为扭曲
- 用独立留出集识别校准偏差造成的量化质量下降
代表性不是随机多抓一些请求
校准数据的目标不是复现训练集,而是近似模型上线后的真实输入分布。对于文本模型,至少要检查序列长度、任务或主题、输入格式三个维度;如果线上还有工具调用、多轮上下文或特殊语言,也应把这些会改变激活分布的路径纳入分层。
直接从流量中均匀随机抽样可能漏掉占比较低但重要的长上下文或结构化请求。反过来,如果为了保险而大量加入极端长请求,又可能把激活范围拉得过宽,使普通请求损失量化分辨率。
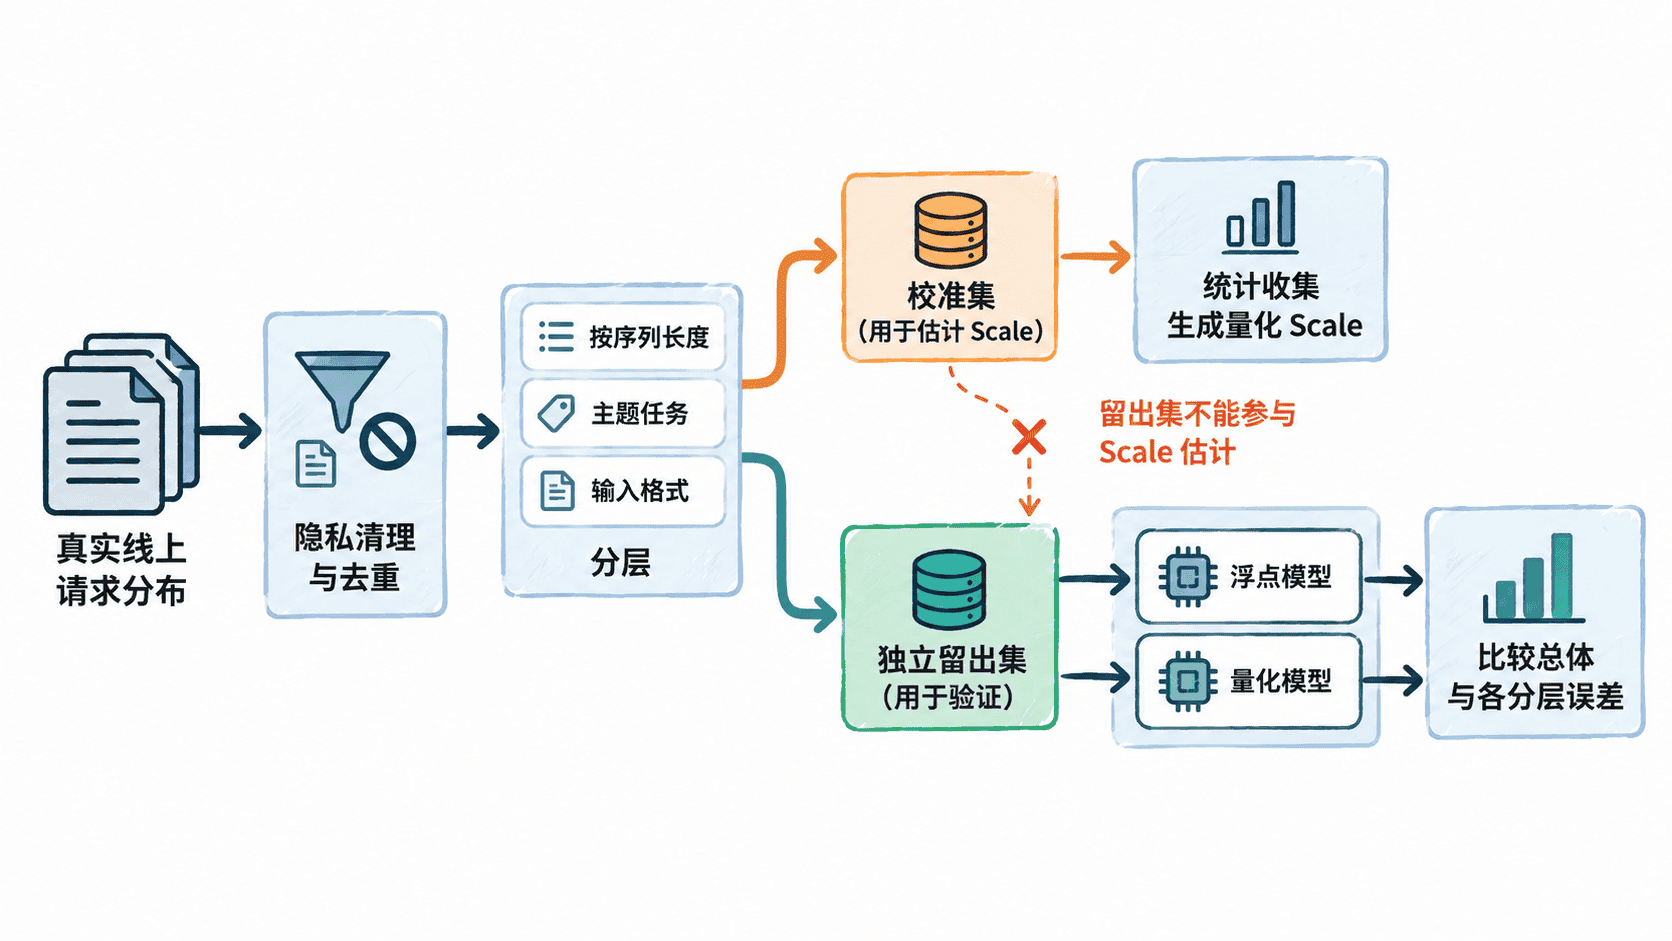
用分层样本观察校准偏差
下面用数值向量模拟不同请求产生的激活。示例不是某个具体模型的真实激活,而是为了展示同一 INT8 量化器在代表性校准集和偏置校准集下会得到不同 Scale,并在同一留出集上产生不同误差。
from collections import Counter

samples = [
    ('r01', 'short', 'support', 'plain', [0.10, -0.20, 0.30]),
    ('r02', 'short', 'support', 'plain', [0.12, -0.22, 0.32]),
    ('r03', 'short', 'support', 'json', [0.15, -0.25, 0.35]),
    ('r04', 'short', 'support', 'json', [0.18, -0.28, 0.38]),
    ('r05', 'medium', 'coding', 'code', [0.40, -0.80, 1.20]),
    ('r06', 'medium', 'coding', 'code', [0.45, -0.90, 1.25]),
    ('r07', 'medium', 'coding', 'markdown', [0.50, -1.00, 1.40]),
    ('r08', 'medium', 'coding', 'markdown', [0.55, -1.10, 1.50]),
    ('r09', 'long', 'reasoning', 'markdown', [1.00, -2.00, 3.00]),
    ('r10', 'long', 'reasoning', 'markdown', [1.10, -2.20, 3.10]),
    ('r11', 'long', 'reasoning', 'json', [1.20, -2.40, 3.20]),
    ('r12', 'long', 'reasoning', 'json', [1.30, -2.60, 3.40]),
]

# 成对样本分别进入校准集和留出集,使两个集合覆盖相同分层。
calibration = [row for i, row in enumerate(samples) if i % 2 == 0]
holdout = [row for i, row in enumerate(samples) if i % 2 == 1]
biased = [row for row in calibration if row[1] == 'short']

def profile(rows, column):
    return dict(sorted(Counter(row[column] for row in rows).items()))

def get_scale(rows):
    amax = max(abs(value) for row in rows for value in row[4])
    return amax / 127

def holdout_mse(rows, scale):
    errors = []
    for row in rows:
        for value in row[4]:
            q = max(-127, min(127, round(value / scale)))
            restored = q * scale
            errors.append((value - restored) ** 2)
    return sum(errors) / len(errors)

print(f'calibration length={profile(calibration, 1)}')
print(f'calibration topic={profile(calibration, 2)}')
print(f'calibration format={profile(calibration, 3)}')
print(f'holdout length={profile(holdout, 1)}')

for name, rows in [('representative', calibration), ('biased', biased)]:
    scale = get_scale(rows)
    print(f'{name} scale={scale:.6f} holdout_mse={holdout_mse(holdout, scale):.6f}')
预期输出
calibration length={'long': 2, 'medium': 2, 'short': 2}
calibration topic={'coding': 2, 'reasoning': 2, 'support': 2}
calibration format={'code': 1, 'json': 2, 'markdown': 2, 'plain': 1}
holdout length={'long': 2, 'medium': 2, 'short': 2}
representative scale=0.025197 holdout_mse=0.002268
biased scale=0.002756 holdout_mse=1.659078
偏置校准集只包含短请求,因此观察到的激活范围很窄。量化器据此得到较小 Scale,遇到中长请求时大量激活超过可表示范围并发生饱和,留出误差随之显著上升。真实 PTQ 工具可能使用直方图、百分位或其他校准算法,但代表性不足造成的风险相同。
控制样本数量与序列长度
校准样本不是越多越好,也不存在适用于所有模型的固定数量。先用能够覆盖主要分层的小型集合运行校准,再逐步增加样本,观察量化参数和留出质量是否趋于稳定;已经稳定后继续堆入大量同质数据,收益通常有限。
序列长度尤其要按部署分布处理。短、中、长请求应按实际流量比例覆盖,同时保证关键长上下文路径不缺失。不要为了方便把所有样本都填充到最大长度,否则填充方式和超长序列会改变统计权重,使校准数据与真实请求不一致。
原始线上请求还应先完成隐私清理、去重和异常流量过滤。重复模板如果占据校准集大部分位置,会让样本数量看起来充足,却没有增加真正的分布覆盖。
用独立留出集检查质量
留出集不能参与 Scale、零点、裁剪阈值或其他校准统计的估计。校准完成后,应让浮点基线模型和量化模型运行同一批留出请求,并同时观察总体指标和各分层指标。
如果整体质量看似正常,但长上下文、代码输入或 JSON 请求单独明显退化,优先检查这些分层在校准集中的比例和数值范围,而不是立即扩大整个数据集。补充缺失分层后重新校准,再使用原来的独立留出集复测,才能判断修正是否有效。
最终验收应使用与任务匹配的指标,例如分类准确率、生成任务质量指标或业务成功率,并结合必要的数值误差分析。代表性校准集负责让量化统计接近真实运行分布,独立留出集则负责证明这种近似没有把质量问题藏在校准数据内部。