
大模型原理与训练 / 系统课时
用 GGUF 跑通 CPU 推理
用 GGUF 跑通 CPU 推理
这一节用 llama.cpp 把 GGUF 模型真正跑起来,并建立一套可重复的本地基准:先强制纯 CPU 完成生成,再调整线程数,最后按需把部分层卸载到 GPU。验收不只看“能回答”,还要同时记录模型体积、峰值内存和生成速度。
学习目标
- 使用
llama-cli在纯 CPU 模式加载 GGUF 并完成一次文本生成 - 用
llama-bench比较线程数和不同 GGUF 量化等级的生成速度 - 在具备 GPU 后端时使用分层卸载,并正确理解文件体积、RAM/VRAM 与速度的关系
先选一个用于基准的量化文件
第一次验证通常可从 Q4_K_M 开始:它常被作为体积与质量之间的折中基线;如果更重视质量余量,可再比较 Q5_K_M 或 Q8_0。不要把量化名称直接等同于固定速度,实际吞吐还受 CPU 指令集、内存带宽、上下文长度、线程调度和后端实现影响。
| 格式 | 相对体积 | 适合做什么 |
|---|---|---|
Q4_K_M |
较小 | 先确认单机可运行与资源占用 |
Q5_K_M |
中等 | 在内存允许时换取更多质量余量 |
Q8_0 |
较大 | 作为更高精度的本地参考基线 |
先记录文件体积,避免后面只看 tokens/s:
ls -lh "<PATH>/model-q4_k_m.gguf"预期输出:
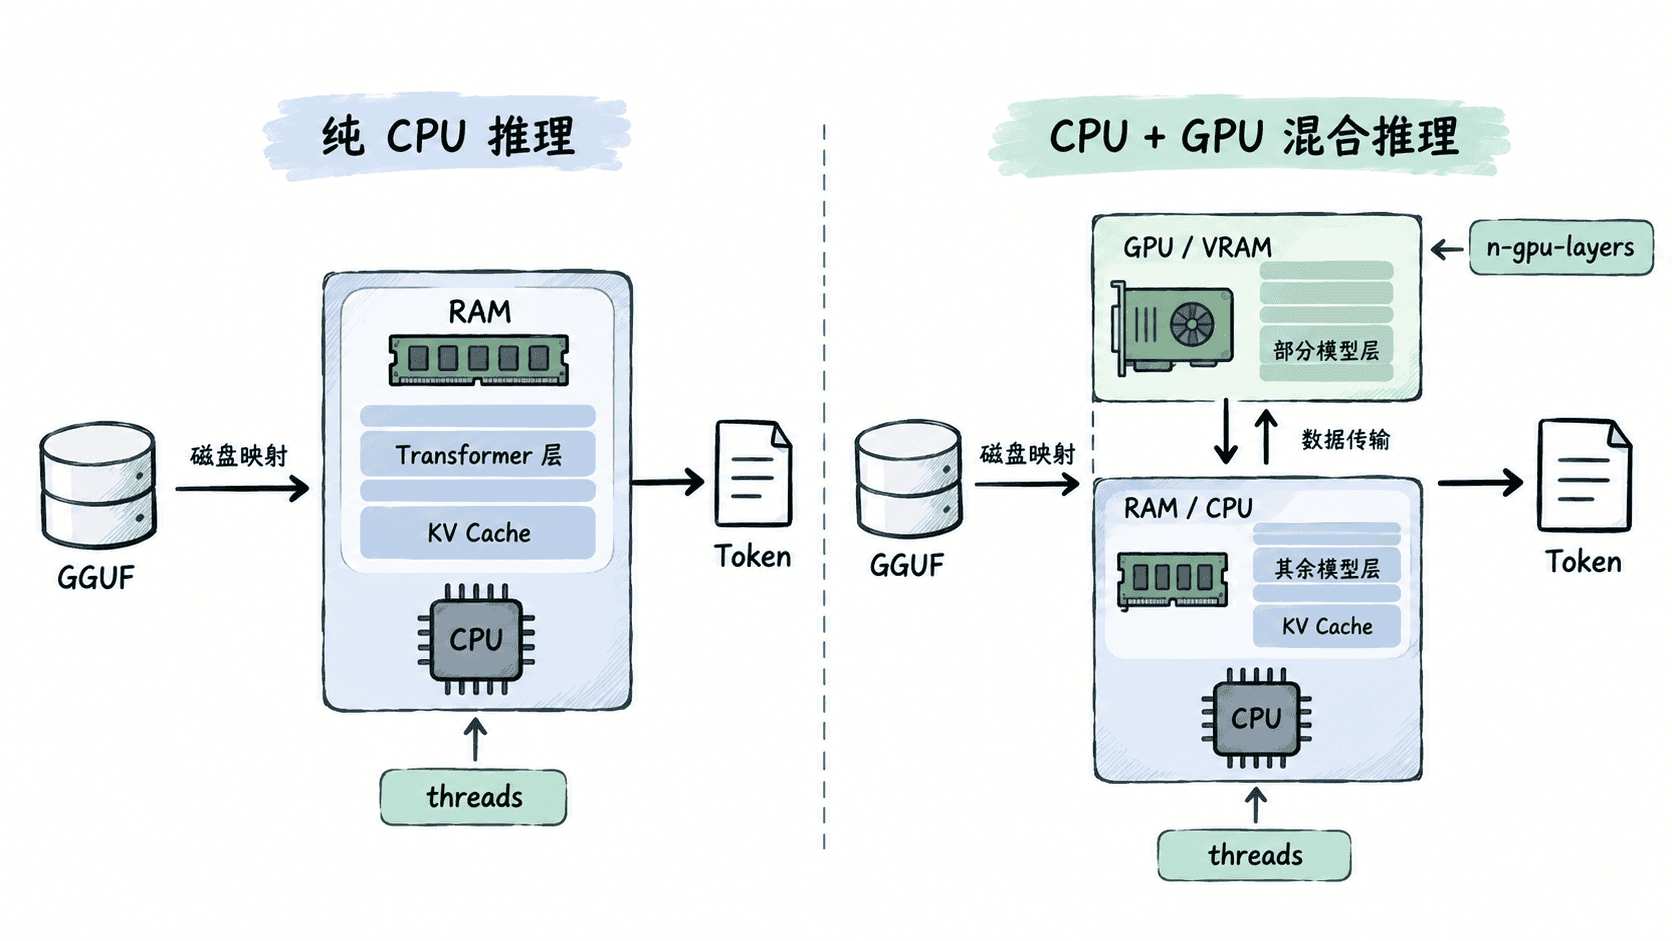
-rw-r--r-- ... <SIZE> ... <PATH>/model-q4_k_m.gguf<SIZE> 会随模型参数量和量化结果变化。文件大小只是磁盘占用,运行时还会额外分配 KV Cache、计算缓冲区和运行时结构,因此不能把 .gguf 大小直接当作峰值内存。
强制纯 CPU 跑通一次生成
为了得到干净的 CPU 基线,显式禁用设备卸载,并设置线程数、上下文长度和最大生成 Token。<THREADS> 建议先填写物理核心数附近的值,再用基准测试向上或向下调整。
cd "<PATH>/llama.cpp"

./build/bin/llama-cli \
  -m "<PATH>/model-q4_k_m.gguf" \
  --device none \
  --threads <THREADS> \
  --ctx-size 2048 \
  --predict 64 \
  --temp 0 \
  --prompt "用两句话解释模型量化。"
预期输出:
<MODEL_LOAD_LOG>
<GENERATED_TEXT>
<PERFORMANCE_STATS>
实际回答文本和速度数字由模型与硬件决定。验收重点是模型能成功加载、没有 GPU 层卸载,并在结束时给出生成及性能信息。若一开始就报内存不足,优先换更小量化等级或缩小上下文,而不是盲目增加线程。
用线程基准找出甜点区
线程越多并不一定越快。线程超过合适范围后,调度、缓存竞争和内存带宽都可能让生成速度下降。用相同模型、相同生成长度跑 llama-bench,比凭 CPU 逻辑核心数猜配置更可靠。
下面示例固定为纯 CPU,只改变线程数:
cd "<PATH>/llama.cpp"

for T in 2 4 8; do
  echo "THREADS=$T"
  ./build/bin/llama-bench \
    -m "<PATH>/model-q4_k_m.gguf" \
    --device none \
    -t "$T" \
    -p 0 \
    -n 128
done
预期输出:
THREADS=2
<THREAD_2_BENCHMARK_WITH_TOKENS_PER_SECOND>
THREADS=4
<THREAD_4_BENCHMARK_WITH_TOKENS_PER_SECOND>
THREADS=8
<THREAD_8_BENCHMARK_WITH_TOKENS_PER_SECOND>
比较各组的 text generation t/s,选择稳定且吞吐较高的线程数。正式比较 Q4_K_M、Q5_K_M 和 Q8_0 时,应保持线程数、上下文和生成长度一致,否则得到的差异无法归因到量化等级。
记录峰值内存而不是只看文件大小
在 Linux 上可用 GNU time 记录一次固定推理的最大常驻内存。为了让多次结果可比,模型、线程数、上下文和生成长度都应保持一致。
cd "<PATH>/llama.cpp"

/usr/bin/time -v ./build/bin/llama-cli \
  -m "<PATH>/model-q4_k_m.gguf" \
  --device none \
  --threads <THREADS> \
  --ctx-size 2048 \
  --predict 64 \
  --temp 0 \
  --prompt "用两句话解释模型量化。" \
  >/tmp/llama-output.txt
预期输出:
...
Maximum resident set size (kbytes): <KB>
...
<KB> 是本次进程的峰值常驻内存,实际数值会随模型、上下文和平台变化。若系统没有 GNU time,应使用本平台等价的进程监控工具;不要拿操作系统文件缓存变化直接当成模型运行内存。
有 GPU 时再做分层卸载
如果 llama.cpp 已用 CUDA、Vulkan、Metal 等可用 GPU 后端构建,可以通过 --n-gpu-layers 把部分模型层放入 VRAM,剩余层仍由 CPU 执行。先从较小层数开始,确认显存余量,再逐步增加;显存不足时降低卸载层数即可,不必重新量化模型。
cd "<PATH>/llama.cpp"

./build/bin/llama-cli \
  -m "<PATH>/model-q4_k_m.gguf" \
  --threads <THREADS> \
  --n-gpu-layers <GPU_LAYERS> \
  --ctx-size 2048 \
  --predict 64 \
  --temp 0 \
  --prompt "用两句话解释模型量化。"
预期输出:
<MODEL_LOAD_LOG_WITH_GPU_OFFLOAD>
<GENERATED_TEXT>
<PERFORMANCE_STATS>
<GPU_LAYERS> 取值要按显存容量实测;加载日志应能看到设备与层卸载相关信息。CPU+GPU 模式是否更快取决于卸载比例、GPU 性能和 CPU/GPU 之间的数据传输成本,因此最终仍应回到同一套基准:相同提示词与生成长度下,对比文件体积、峰值 RAM/VRAM 和 tokens/s,再决定部署配置。