
大模型原理与训练 / 系统课时
定位加载失败与算子不兼容
定位加载失败与算子不兼容
模型在量化导出后能否真正加载,取决于权重量化格式、运行时后端、GPU 计算能力和设备映射是否同时匹配。本篇给出一条可复用的排查路径:先固定错误现场,再核对元数据与硬件能力,最后选择最小代价的回退路径并重新验证。
学习目标
- 能从量化元数据、CUDA 能力和错误日志判断失败发生在哪一层。
- 能区分“格式不支持”“Kernel 不可用”“设备映射错误”三类常见问题。
- 能为失败场景选择安全的回退加载路径,并验证模型确实恢复可用。
先把失败定位到具体层
加载失败不要一开始就反复换参数。先保留完整异常堆栈,并确认失败发生在模型配置解析、权重反序列化、量化后端初始化、Kernel 选择,还是设备放置阶段。不同层的修复动作完全不同。
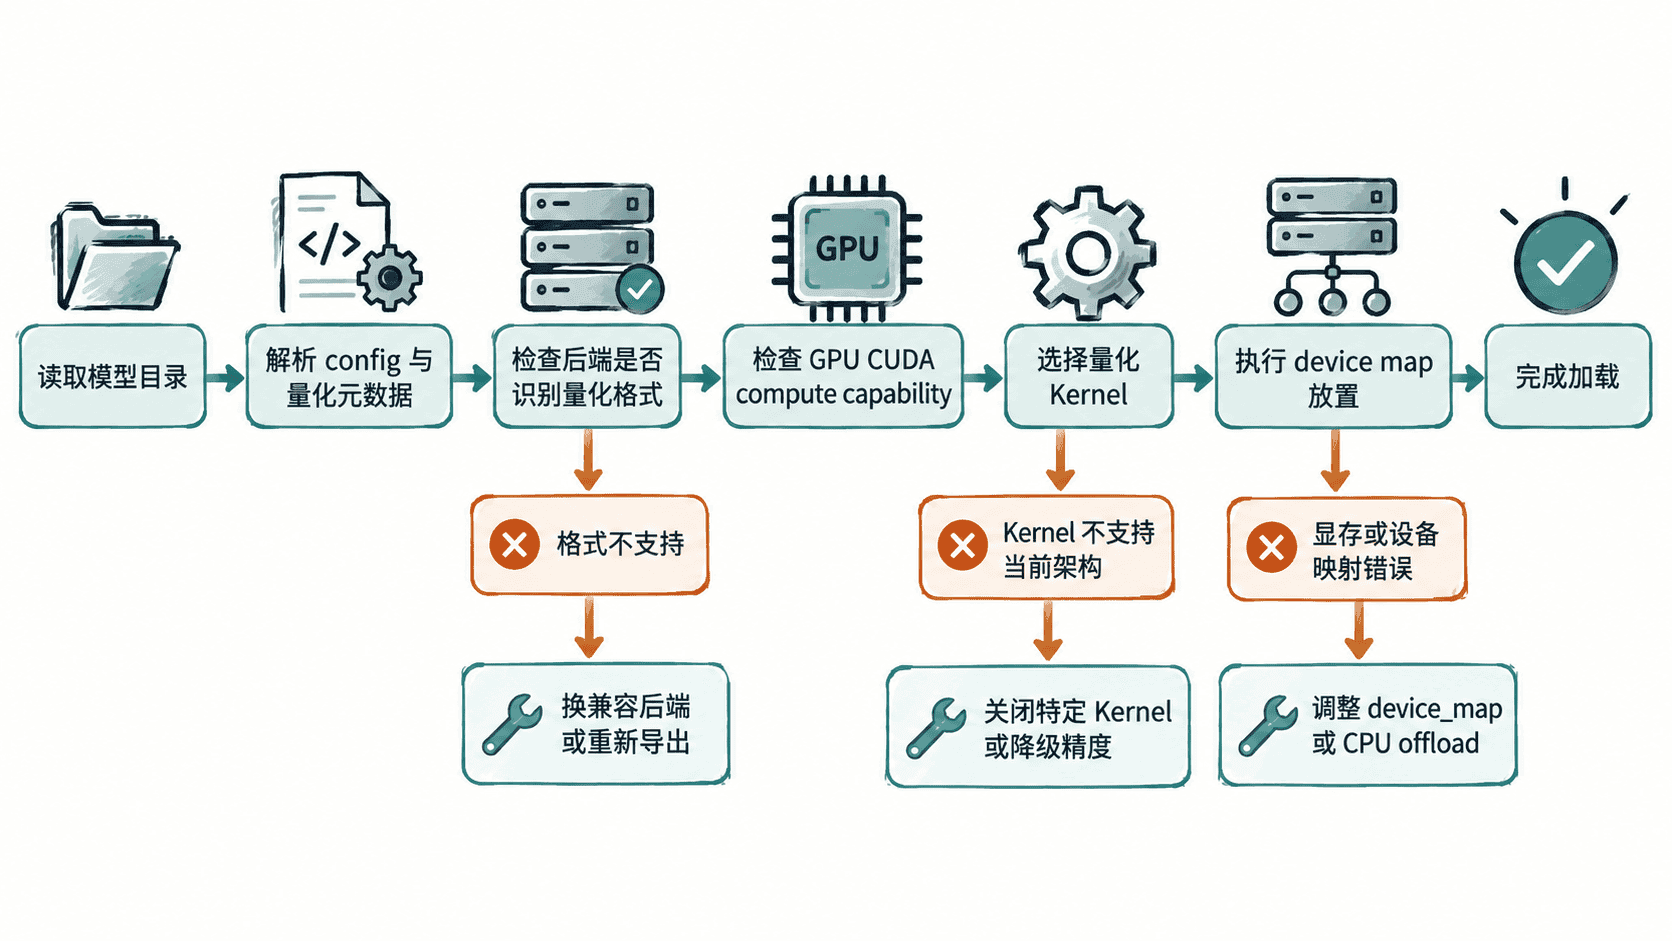
最先要回答的是“运行时是否认识这个量化模型”。例如模型目录中的 config.json、quantization_config 或专用元数据会记录量化方法、位宽、分组大小与部分后端参数。如果运行时根本不支持该格式,继续检查 CUDA Kernel 没有意义。
采集模型元数据与 CUDA 能力
下面的命令同时打印模型配置中的量化信息和当前 PyTorch 可见的 CUDA 能力。将 <PATH> 替换为模型目录;不同机器上的版本号和计算能力会不同。
MODEL_DIR='<PATH>' python - <<'PY'
import json
import os
from pathlib import Path

model_dir = Path(os.environ['MODEL_DIR'])
config_path = model_dir / 'config.json'
config = json.loads(config_path.read_text(encoding='utf-8'))

print('model_type:', config.get('model_type'))
print('torch_dtype:', config.get('torch_dtype'))
print('quantization_config:', json.dumps(config.get('quantization_config'), ensure_ascii=False))

try:
    import torch
    print('torch_version:', torch.__version__)
    print('cuda_available:', torch.cuda.is_available())
    print('cuda_version:', torch.version.cuda)
    if torch.cuda.is_available():
        print('device_name:', torch.cuda.get_device_name(0))
        print('compute_capability:', torch.cuda.get_device_capability(0))
except Exception as exc:
    print('torch_probe_error:', type(exc).__name__, str(exc))
PY
预期输出
model_type: <MODEL_TYPE>
torch_dtype: <DTYPE>
quantization_config: <QUANTIZATION_METADATA>
torch_version: <TORCH_VERSION>
cuda_available: True
cuda_version: <CUDA_VERSION>
device_name: <GPU_NAME>
compute_capability: (<MAJOR>, <MINOR>)
其中版本、设备名称和计算能力以实际环境为准。如果 quantization_config 为空,先确认导出阶段是否把量化元数据写入模型目录;如果 cuda_available 为 False,优先修复驱动、容器 GPU 挂载或 PyTorch CUDA 构建,而不是继续追量化 Kernel。
用错误关键词缩小根因
错误日志通常能把问题缩到少数几类。判断时不要只看最后一行,至少向上回溯到第一个由后端、CUDA 或设备映射抛出的异常。
| 典型线索 | 更可能的根因 | 优先动作 |
|---|---|---|
unsupported quantization、未知量化类型 |
运行时不识别导出格式 | 核对后端支持列表,换兼容加载器或重新导出 |
no kernel image、unsupported SM、架构不匹配 |
已选 Kernel 不支持当前 GPU compute capability | 换通用 Kernel、升级兼容构建或回退精度 |
CUDA out of memory |
单卡放置过多权重或 KV Cache 预算过高 | 调整 device_map、降低并发或启用 CPU offload |
tensor on different devices |
模块被映射到不一致设备 | 检查自动切分结果,显式约束关键模块 |
| 权重形状或 key 不匹配 | 量化导出与模型结构版本不一致 | 回到导出物与基础模型版本重新核对 |
选择最小代价的回退路径
回退应按“少改动、可验证、可恢复”的顺序进行。格式不兼容时,优先换到明确支持该量化格式的后端;Kernel 不兼容时,优先禁用专用 Kernel 或选择通用实现;只有确认量化路径本身不可用时,再回退到更高精度权重。
设备映射问题则应与量化格式分开处理。先用单卡或明确的设备映射验证模型能加载,再逐步恢复自动切分、CPU offload 或多卡部署。这样能避免把“格式问题”和“放置问题”叠加成一个难以解释的异常。
修复后做最小可用验证
修复后的验收至少包含三项:模型对象成功构造、一个最小输入可以完成前向或生成、日志中没有回退到意外精度或 CPU 路径。若性能明显低于预期,还要重新确认实际启用的 Kernel,而不能把“成功加载”直接等同于“量化部署成功”。
最终应保留一份可复现记录:模型目录版本、量化方法、后端版本、GPU 型号与 compute capability、关键加载参数、失败日志与最终回退方案。下次换机器或升级运行时,就能先比对兼容矩阵,而不是重新从异常末尾猜原因。