
大模型原理与训练 / 系统课时
处理长序列带来的显存压力
处理长序列带来的显存压力
长序列训练的显存峰值通常不是“样本多”,而是少量超长样本把批次长度、Padding 和注意力激活同时推高。本节给出一套可执行的长度审计与打包规划方法,并用标签锚点检查截断是否破坏监督语义。
学习目标
- 区分最大序列长度、Padding、打包和激活对显存的不同影响。
- 用长度统计选择动态 Padding、长度分桶、打包或截断策略。
- 在截断前验证任务关键上下文和标签依据仍被保留。
先定位显存是被什么推高的
同一批样本进入模型时,通常会补齐到该批最长序列。若一个批次里混入 1600 Token 的长样本,即使其余样本只有 200~300 Token,也可能让大量位置只用于 Padding。把所有样本固定补到全局 max_length 会进一步放大浪费。
序列长度还会放大激活占用。残差、MLP 等中间激活大致随批大小和序列长度线性增长,而标准全注意力中的注意力矩阵包含 L × L 关系,长度增加时相关占用会呈二次增长。训练还要保留反向传播所需中间结果,因此峰值通常明显高于纯推理。
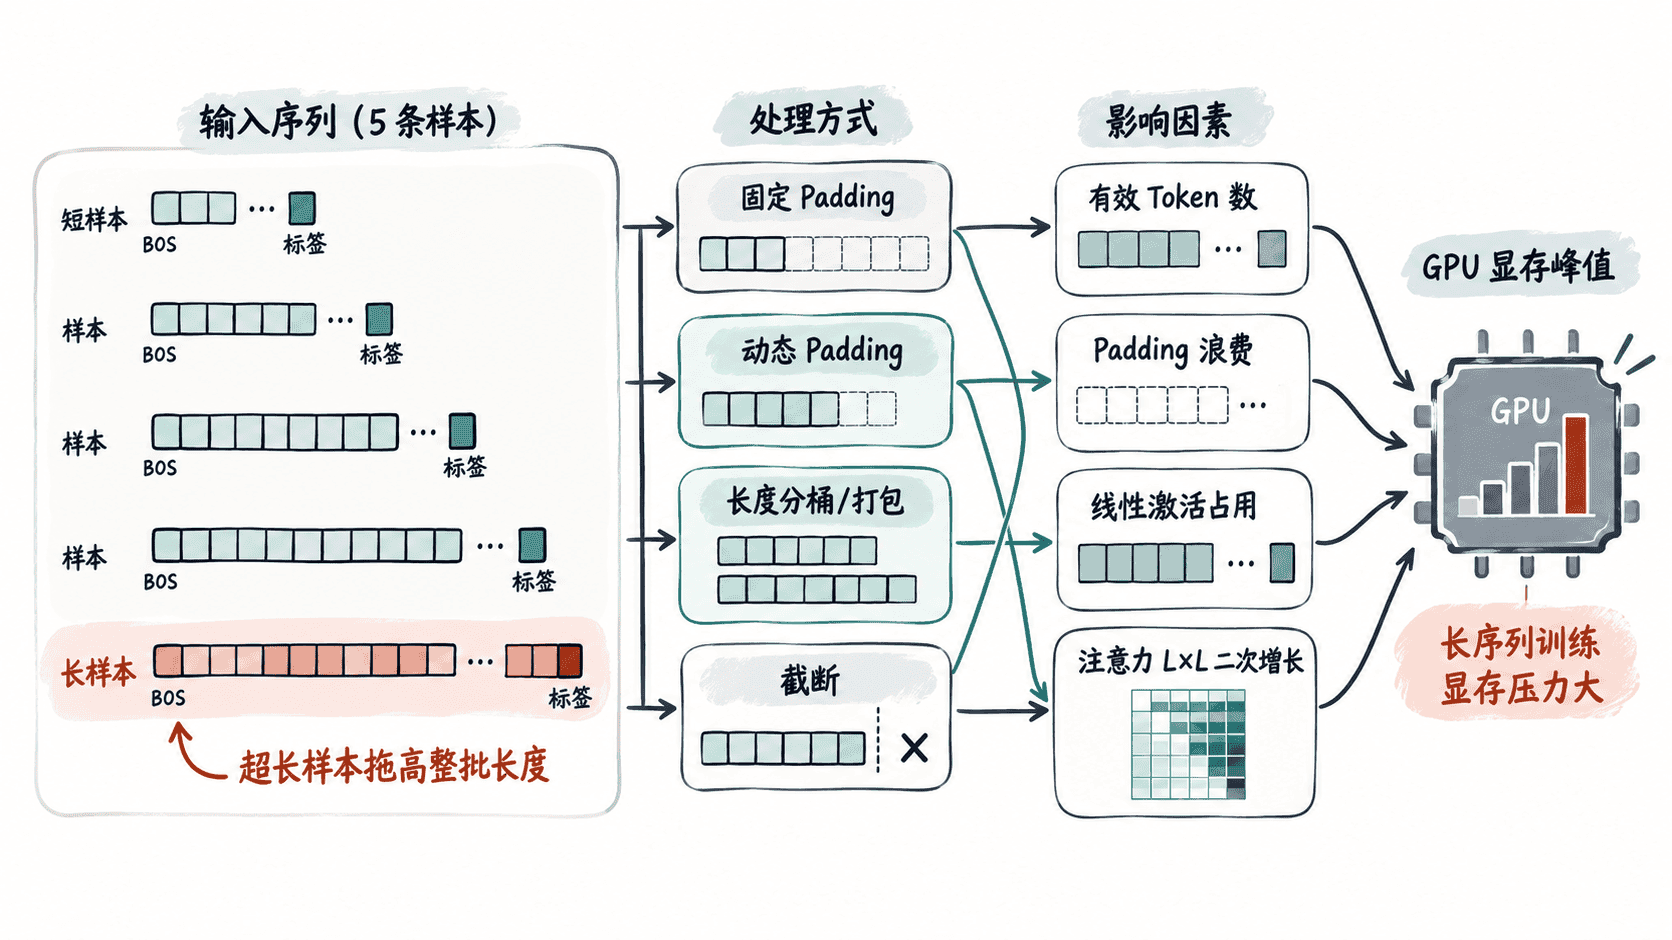
因此排查时不要只看 OOM 发生在哪一步,而要同时记录每批的最长长度、有效 Token 数、Padding 比例和异常长样本。若长样本本身不可截断,再考虑减小 micro-batch 或使用激活检查点;梯度累积只能维持有效批大小,不能消除单个长序列本身的激活成本。
用长度审计决定截断与打包
下面的脚本不做真实张量拼接,而是先计算训练计划:比较普通批处理的 Padding 浪费与 1024 Token 容量下的贪心打包,并检查“标签依据所在位置”是否会被截掉。这个检查应先于真正的数据整理。
from dataclasses import dataclass

@dataclass(frozen=True)
class Sample:
    sample_id: str
    tokens: int
    label_anchor: int

# label_anchor 表示决定标签的关键 Token 位置,用于做语义安全检查。
SAMPLES = [
    Sample("s1", 220, 180),
    Sample("s2", 780, 420),
    Sample("s3", 1600, 900),
    Sample("s4", 300, 260),
    Sample("s5", 1450, 1300),
]
MAX_LEN = 1024
BATCH_SIZE = 2

def clipped_len(sample):
    return min(sample.tokens, MAX_LEN)

def padded_tokens(batch):
    # 动态 Padding 后,一个批次仍要补齐到批内最长序列。
    longest = max(clipped_len(item) for item in batch)
    return longest * len(batch)

def first_fit_pack(samples):
    # 这里只规划 Token 容量;真实模型还需要隔离不同样本的注意力边界。
    packs = []
    for sample in sorted(samples, key=clipped_len, reverse=True):
        length = clipped_len(sample)
        for index, (items, used) in enumerate(packs):
            if used + length <= MAX_LEN:
                items.append(sample)
                packs[index] = (items, used + length)
                break
        else:
            packs.append(([sample], length))
    return packs

def main():
    naive = sum(
        padded_tokens(SAMPLES[i:i + BATCH_SIZE])
        for i in range(0, len(SAMPLES), BATCH_SIZE)
    )
    effective = sum(clipped_len(item) for item in SAMPLES)
    packs = first_fit_pack(SAMPLES)
    packed_capacity = len(packs) * MAX_LEN

    # 标签锚点落在截断线之后,说明“能截”不等于“语义安全”。
    unsafe = [
        item.sample_id for item in SAMPLES
        if item.label_anchor >= MAX_LEN
    ]

    print(f"naive_padded_tokens={naive}")
    print(f"effective_tokens={effective}")
    print(f"packed_capacity={packed_capacity}")
    print(f"unsafe_truncation={unsafe}")

if __name__ == "__main__":
    main()
预期输出
naive_padded_tokens=4632
effective_tokens=3348
packed_capacity=4096
unsafe_truncation=['s5']
这里的 s5 虽然可以机械截到 1024 Token,但标签依据位于第 1300 个 Token 左右,直接保留前缀会改变监督语义。对于分类任务,应确认决定标签的证据仍在保留窗口内;对于生成式蒸馏,还要保证学生输入、教师输出与损失对齐使用的是同一段上下文。
按风险从低到高降低显存
优先采用不改变样本语义的优化。先把全局固定 Padding 改为按批动态 Padding,再按长度分桶,让相近长度进入同一批。若训练框架支持 sequence packing,可把多个短样本放进同一容量块,但必须使用正确的 position id 和块状/分段注意力掩码,避免不同样本互相看到内容。
仍有压力时,再降低 micro-batch;需要保持有效批大小时配合梯度累积。若任务必须保留长上下文,可以启用激活检查点,用额外重算换显存。只有确认任务证据分布后才调整 max_length,因为截断是这里唯一可能直接改变样本含义的动作。
验证优化没有换来错误标签
上线新的长度策略前,至少对被截断样本单独抽检:记录原始长度、保留区间和标签证据位置,并统计有多少样本的关键位置越过截断线。对蒸馏任务,还要比较截断前后的教师预测或教师 logits;若大量样本的教师判断发生变化,说明节省的不是冗余 Token,而是任务信息。
最终目标不是把 max_length 压到最低,而是让每个 batch 尽量少携带无效 Padding,同时把确实决定标签的长上下文保留下来。显存预算应先由有效 Token 驱动,再由语义安全决定哪些长样本可以被截断。