
大模型原理与训练 / 系统课时
保存检查点并恢复蒸馏训练
保存检查点并恢复蒸馏训练
蒸馏训练中断后,如果只加载学生模型权重,优化器动量、学习率位置、随机数序列和数据游标都会重置,恢复后的曲线就不再是同一次训练。本节用可运行脚本保存完整训练状态,并通过中断前后对照验证恢复没有跳步。
学习目标
- 明确可恢复检查点必须保存的模型、优化器、调度器、步数和随机状态。
- 模拟训练中断并从检查点继续,而不是重新开始一个“相似训练”。
- 用损失、学习率和数据进度验证恢复前后状态连续。
检查点保存的是训练状态
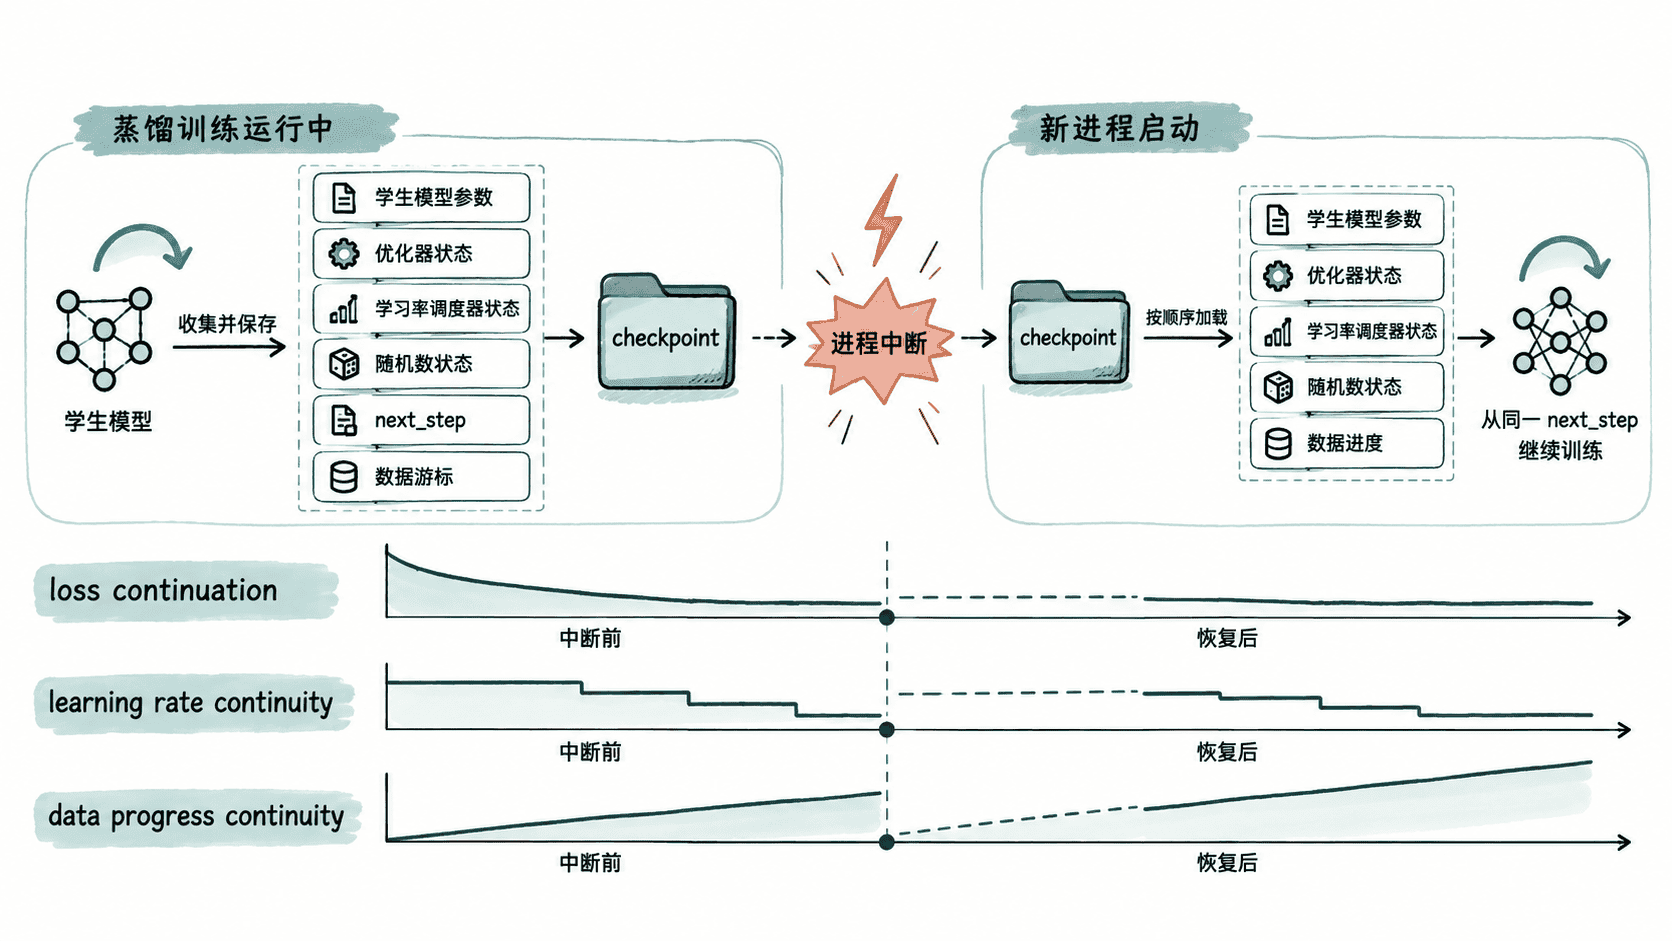
学生模型参数只描述“当前学到了什么”,并不描述“下一步该怎么更新”。AdamW 等优化器还保存动量统计,学习率调度器保存当前阶段;Dropout、采样和数据增强依赖随机数状态,数据管线还需要知道下一批从哪里继续。
因此一个最小可恢复检查点应至少包含学生模型、优化器、学习率调度器、下一训练步以及 Python、NumPy、PyTorch 的随机状态。若教师模型在训练期间冻结,可以从同一版本重新加载,但它的版本、蒸馏温度和损失权重等配置必须保持一致。
用可运行脚本模拟中断与恢复
下面使用一个带 Dropout 的小模型模拟学生网络。程序先训练 3 步并保存检查点,再继续得到“不中断”的参考轨迹;随后创建新模型,从检查点恢复,并重新执行剩余 3 步。只要完整状态恢复正确,两条后半程轨迹就应一致。
import os
import random
import tempfile

import numpy as np
import torch
from torch import nn

TOTAL_STEPS = 6
CUT_STEP = 3

def seed_all(seed):
    random.seed(seed)
    np.random.seed(seed)
    torch.manual_seed(seed)

class TinyStudent(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(4, 8),
            nn.ReLU(),
            nn.Dropout(p=0.2),
            nn.Linear(8, 1),
        )

    def forward(self, x):
        return self.net(x)

# 固定数据集,确保示例只让 Dropout 消耗训练随机状态。
X = torch.arange(0, 96, dtype=torch.float32).reshape(24, 4) / 100.0
Y = X.sum(dim=1, keepdim=True) * 0.5
BATCHES = [(X[i:i + 4], Y[i:i + 4]) for i in range(0, len(X), 4)]

def make_state():
    model = TinyStudent()
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-2)
    scheduler = torch.optim.lr_scheduler.StepLR(
        optimizer, step_size=2, gamma=0.5
    )
    return model, optimizer, scheduler

def train_step(model, optimizer, scheduler, step):
    xb, yb = BATCHES[step % len(BATCHES)]
    optimizer.zero_grad()
    loss = nn.functional.mse_loss(model(xb), yb)
    loss.backward()
    optimizer.step()
    # 调度器必须与 optimizer 更新次数保持同一进度。
    scheduler.step()
    return float(loss.detach()), optimizer.param_groups[0]["lr"]

def save_checkpoint(path, model, optimizer, scheduler, next_step):
    # 保存“下一步怎么继续”所需的全部状态,而不只保存模型权重。
    torch.save({
        "model": model.state_dict(),
        "optimizer": optimizer.state_dict(),
        "scheduler": scheduler.state_dict(),
        "next_step": next_step,
        "python_rng": random.getstate(),
        "numpy_rng": np.random.get_state(),
        "torch_rng": torch.get_rng_state(),
    }, path)

def load_checkpoint(path, model, optimizer, scheduler):
    state = torch.load(path, weights_only=False)
    model.load_state_dict(state["model"])
    optimizer.load_state_dict(state["optimizer"])
    scheduler.load_state_dict(state["scheduler"])
    random.setstate(state["python_rng"])
    np.random.set_state(state["numpy_rng"])
    torch.set_rng_state(state["torch_rng"])
    return state["next_step"]

def main():
    seed_all(7)
    model, optimizer, scheduler = make_state()

    with tempfile.TemporaryDirectory() as tmp:
        path = os.path.join(tmp, "distill.pt")

        for step in range(CUT_STEP):
            train_step(model, optimizer, scheduler, step)
        save_checkpoint(path, model, optimizer, scheduler, CUT_STEP)

        # 不中断地继续训练,得到恢复后应复现的参考轨迹。
        ref_losses, ref_lrs = [], []
        for step in range(CUT_STEP, TOTAL_STEPS):
            loss, lr = train_step(model, optimizer, scheduler, step)
            ref_losses.append(loss)
            ref_lrs.append(lr)

        # 模拟新进程:先重建对象,再由检查点覆盖全部训练状态。
        resumed_model, resumed_optimizer, resumed_scheduler = make_state()
        resume_step = load_checkpoint(
            path, resumed_model, resumed_optimizer, resumed_scheduler
        )

        resumed_losses, resumed_lrs = [], []
        for step in range(resume_step, TOTAL_STEPS):
            loss, lr = train_step(
                resumed_model, resumed_optimizer, resumed_scheduler, step
            )
            resumed_losses.append(loss)
            resumed_lrs.append(lr)

        print(f"resume_step={resume_step}")
        print(f"loss_match={np.allclose(ref_losses, resumed_losses, rtol=0, atol=0)}")
        print(f"lr_match={ref_lrs == resumed_lrs}")
        print(f"data_progress_match={resume_step == CUT_STEP}")

if __name__ == "__main__":
    main()
预期输出
resume_step=3
loss_match=True
lr_match=True
data_progress_match=True
这个例子把数据顺序设计成确定性的,因此保存 next_step 就足以恢复数据位置。若实际训练启用了随机 shuffle、分布式 sampler 或流式数据集,还需要保存 sampler/generator 状态、epoch 与批次游标,或者使用训练框架提供的可恢复数据加载机制。
补齐真实流水线中的附加状态
混合精度训练若使用 GradScaler,应同时保存 scaler 状态,否则动态缩放会从初始值重新开始。使用梯度累积时,还要确认检查点落在优化器更新边界;若允许在累积中途保存,就必须连同尚未提交的梯度或累积计数一起处理。
分布式蒸馏还要关注 checkpoint 的分片方式和 world size。FSDP、DeepSpeed 等场景应优先使用对应框架的 checkpoint API,因为参数、优化器状态可能被分片,简单调用单进程 state_dict() 未必得到可直接恢复的完整状态。
用连续性而不是“能加载”验收
恢复成功的最低标准不是“程序没有报错”,而是状态连续。先核对恢复后的下一步编号和下一批样本 ID,再检查学习率是否位于中断前应处的调度阶段;最后观察恢复点附近的蒸馏损失,确认没有因优化器或随机状态重置而出现异常跳变。
在同一 CPU、同一软件版本和确定性算子下,可以像示例一样要求后半程逐步一致;GPU 或分布式环境可能存在数值非确定性,此时更实际的标准是数据位置、学习率和优化器阶段严格连续,损失在合理浮点误差内延续,而不是强求每一位完全相同。