
大模型原理与训练 / 系统课时
把模型转换为 GGUF 格式
把模型转换为 GGUF 格式
这一节把 Hugging Face 风格的权重与 Tokenizer 转成可被 llama.cpp 直接读取的 GGUF,并在转换后检查文件与关键元数据。重点不是“生成一个 .gguf 文件”本身,而是确保模型结构、分词器和聊天模板等信息没有在转换链路中丢失。
学习目标
- 判断一个模型目录是否具备 GGUF 转换所需的结构与 Tokenizer 文件
- 使用 llama.cpp 的转换脚本生成高精度 GGUF 中间文件
- 检查 GGUF 元数据,并区分“格式转换”和“低比特量化”
转换前先确认输入目录
最稳妥的输入是完整的 Hugging Face 模型目录:至少要有 config.json、模型权重,以及与原模型匹配的 Tokenizer 文件。权重通常是一个或多个 *.safetensors;Tokenizer 可能使用 tokenizer.json、tokenizer.model 或 spiece.model,具体取决于模型家族。不要从另一个同名或近似模型拼 Tokenizer,否则文件虽然可能转换成功,推理时仍可能出现切词和特殊 Token 错位。
先把 <PATH> 替换为本机实际路径,再做最小检查:
set -e
MODEL_DIR="<PATH>/hf-model"

test -f "$MODEL_DIR/config.json"
find "$MODEL_DIR" -maxdepth 1 -name '*.safetensors' -print -quit | grep -q .
test -f "$MODEL_DIR/tokenizer.json" || \
  test -f "$MODEL_DIR/tokenizer.model" || \
  test -f "$MODEL_DIR/spiece.model"

echo "INPUT_READY"
预期输出:
INPUT_READY如果任一检查失败,set -e 会让脚本在输出 INPUT_READY 之前停止。此时应先补齐原始模型文件,而不是直接改转换脚本绕过检查。模型架构本身也必须被当前版本的 llama.cpp 转换器支持;遇到“不支持架构”时,应先确认模型类型和当前转换器能力。
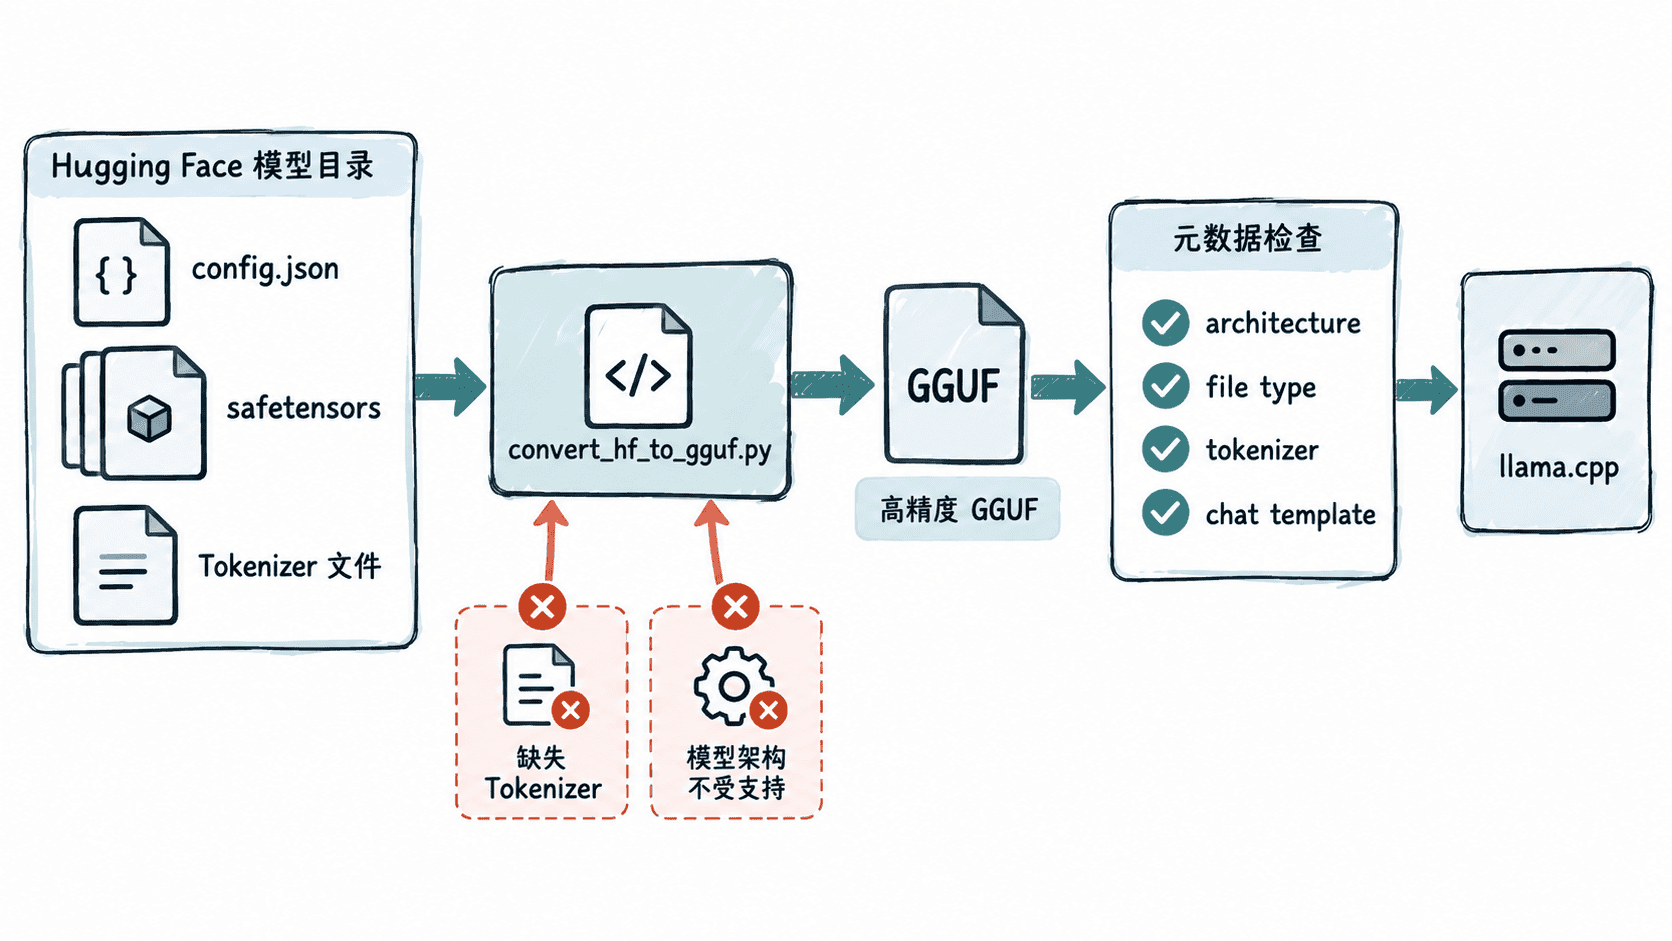
从 Hugging Face 目录生成 GGUF
建议先生成 F16 或 BF16 这类高精度 GGUF,再根据部署目标单独量化。这样可以保留一个稳定的转换产物,也避免把“模型格式不兼容”和“量化质量下降”混成同一个问题。下面使用 F16;<PATH> 仍需替换为实际路径。
set -e
cd "<PATH>/llama.cpp"

python3 -m pip install -r requirements.txt

python3 convert_hf_to_gguf.py \
  "<PATH>/hf-model" \
  --outfile "<PATH>/model-f16.gguf" \
  --outtype f16

test -s "<PATH>/model-f16.gguf"
echo "GGUF_READY"
预期输出:
GGUF_READY转换日志会随模型架构和 llama.cpp 版本变化,因此这里不依赖某一行固定日志;真正的最低验收条件是目标文件已生成且非空。若转换过程报找不到配置、Tokenizer 或某个权重分片,应回到输入目录核对原始仓库是否下载完整。
检查 GGUF 元数据
GGUF 不只是“把权重装进另一个文件”。它还携带模型架构、张量类型、分词器及其他推理所需元数据。转换完成后先用仓库自带的 gguf_dump.py 检查,而不是等到服务启动失败才定位。
set -e
cd "<PATH>/llama.cpp"

DUMP="$(python3 gguf-py/gguf/scripts/gguf_dump.py \
  "<PATH>/model-f16.gguf" \
  --no-tensors 2>&1)"

printf '%s\n' "$DUMP" | grep -q 'general.architecture'
printf '%s\n' "$DUMP" | grep -q 'tokenizer'
echo "METADATA_OK"
预期输出:
METADATA_OK随后可直接查看完整 dump,重点核对 general.architecture 是否与原模型一致,以及是否存在对应的 Tokenizer 元数据;指令模型还应关注聊天模板相关字段。字段值因模型而异,不应拿另一模型的固定值作为验收标准。
格式转换之后再决定量化等级
convert_hf_to_gguf.py 负责把受支持的模型转换为 GGUF,并可直接输出若干基础数据类型;常见的 Q4_K_M、Q5_K_M 等 K-Quant 通常在高精度 GGUF 之后交给 llama-quantize 处理。这样可以把两类问题分开:转换失败先查架构、权重和 Tokenizer,量化后质量异常再查量化等级与校准策略。
例如已构建 llama.cpp 时,可以从 F16 产物生成 Q4_K_M:
set -e
cd "<PATH>/llama.cpp"

./build/bin/llama-quantize \
  "<PATH>/model-f16.gguf" \
  "<PATH>/model-q4_k_m.gguf" \
  Q4_K_M

test -s "<PATH>/model-q4_k_m.gguf"
echo "Q4_K_M_READY"
预期输出:
Q4_K_M_READY最终应保留至少一个经过元数据检查的高精度 GGUF 作为基线,再产出部署用量化文件。这样后续 llama.cpp 加载失败、回答乱码或质量下降时,才能快速判断问题来自格式转换、Tokenizer,还是量化本身。