
大模型原理与训练 / 系统课时
用缩放因子映射浮点到整数
用缩放因子映射浮点到整数
量化真正做的事,是把连续的浮点数值映射到数量有限的整数编码,再在计算或读取结果时近似还原。本节从 Scale、Zero Point 和数值范围出发,手算一次量化与反量化,并区分舍入误差和超出范围后的截断误差。
学习目标
- 理解 Scale 与 Zero Point 如何建立浮点值和整数编码之间的映射
- 能手算量化、反量化以及单个数值的量化误差
- 能解释 INT8、INT4 位宽下降为什么会增加误差风险
从连续浮点到有限整数
有符号 INT8 一共有 256 个编码,通常可表示 -128 到 127;有符号 INT4 只有 16 个编码,可表示 -8 到 7。浮点数可以在两个相邻数之间继续取值,而整数编码只能落在这些离散格点上,因此量化一定会丢失一部分精度。
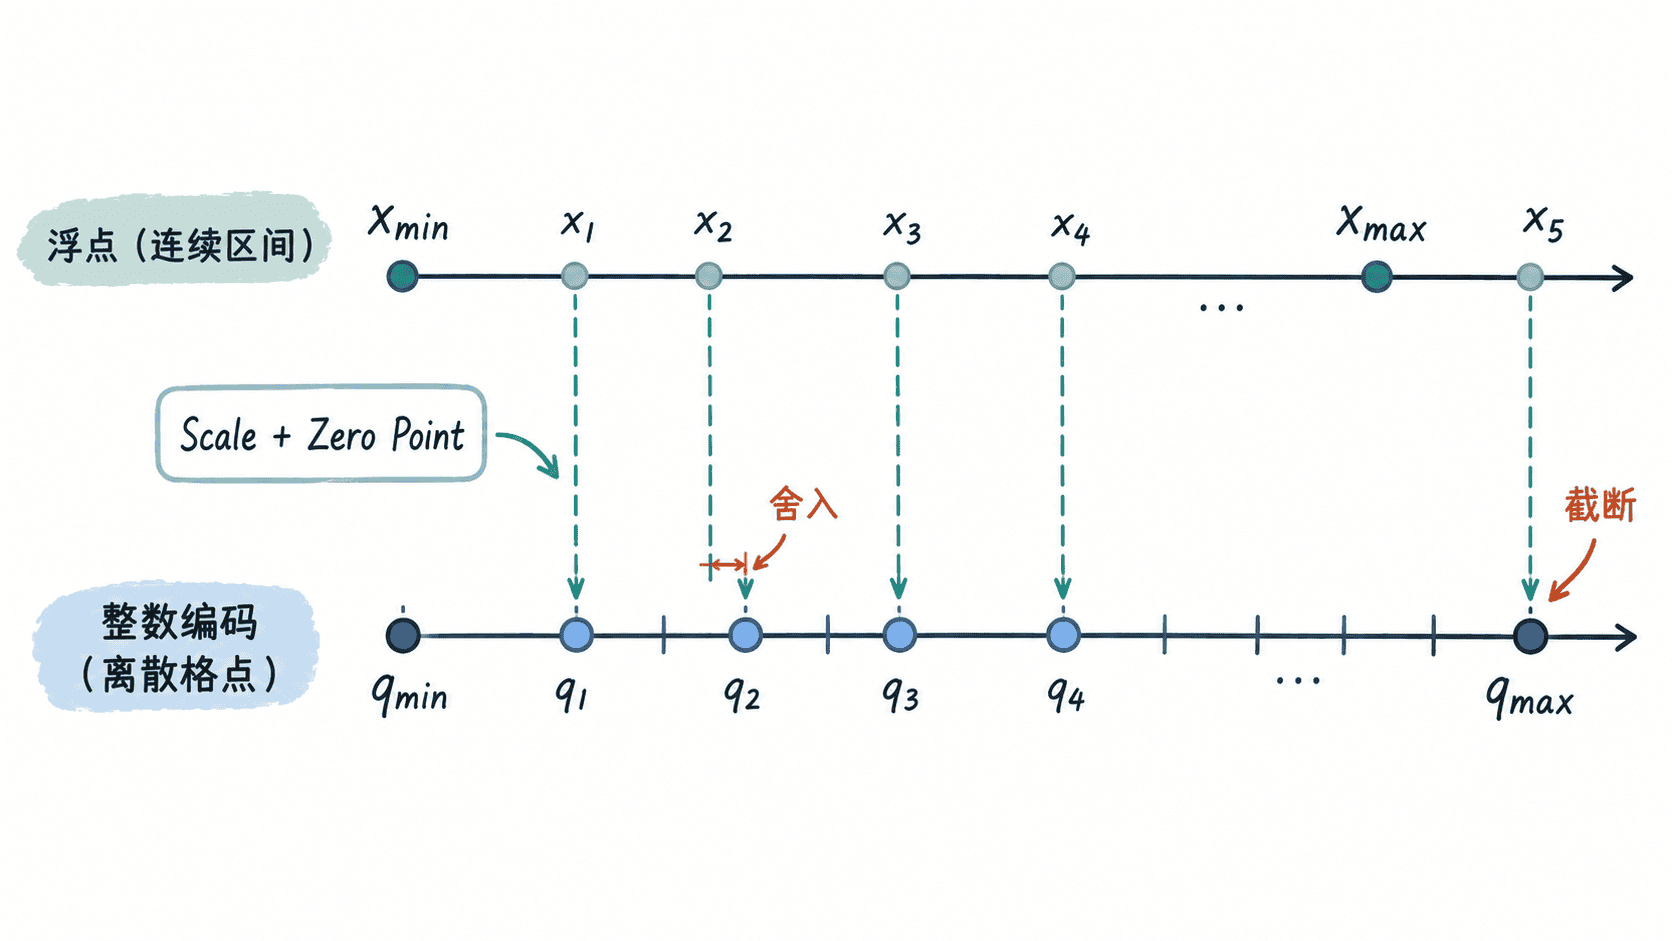
如果要把浮点区间 [xmin, xmax] 映射到整数区间 [qmin, qmax],最常见的是仿射量化。缩放因子决定一个整数步长代表多大的浮点变化:
Zero Point 决定浮点零落在哪个整数编码上:
实际实现还需要把 Z 限制在整数编码范围内。得到两个参数后,浮点值 x 的量化和反量化可写成:
这里的 q 是真正保存或参与整数计算的编码,x' 则是由该编码近似恢复出来的浮点值。量化误差就是 x' 与原值 x 的差。
手算一次量化与反量化
假设校准得到浮点范围 [-1.0, 2.0],并使用有符号 INT8 的 [-128, 127]。此时:
对 x=0.35 量化时,先计算 round(0.35/0.0117647)=30,因此 q=30-43=-13。反量化后:
误差约为 0.002941。这个误差来自浮点值无法恰好落在整数格点上。
再看 x=3.20。它已经超过校准上界 2.0,量化结果会被 clip 到 127,反量化只能得到约 2.0。此时损失的主要原因不再是舍入,而是输入超出了可表示范围。
| 原始值 | INT8 编码 | 反量化值 | 主要误差来源 |
|---|---|---|---|
| 0.35 | -13 | 0.352941 | 舍入 |
| 3.20 | 127 | 2.000000 | 范围截断 |
舍入误差和截断误差要分开看
只要数值位于校准范围内,并采用最近值舍入,单次量化造成的绝对误差通常不会超过约半个 Scale。Scale 越小,整数格点越密,能够表达的细节就越多。
截断误差则完全不同。只要真实输入超过 xmin 或 xmax,无论超过多少,最终都只能落到边界编码,因此误差可能远大于半个 Scale。部署中如果少量离群值把校准范围拉得过宽,会让绝大多数正常值使用更粗的格点;范围太窄又会导致大量截断,两者需要平衡。
同样覆盖一个固定浮点区间时,INT8 有 256 个编码,而 INT4 只有 16 个编码。区间长度不变时,INT4 的相邻格点距离大约是 INT8 的 17 倍,因此对细小权重和激活变化更加敏感。这也是降低位宽时必须重新评估误差,而不能只修改整数类型的原因。
判断量化范围是否合理
观察量化效果时,先区分问题来自分辨率还是范围。范围内误差普遍偏大,通常说明 Scale 太粗,可以考虑更高位宽、按通道量化或更细的分组;大量数值集中在边界编码,则应检查校准数据是否覆盖真实分布以及是否被异常值主导。
Scale 决定格点间距,Zero Point 决定零值落点,位宽决定可用格点数量。把这三个量和实际数据范围对应起来,就能从数值层面解释为什么某次 INT8 或 INT4 量化能够保持精度,或者为什么误差会突然放大。