
大模型原理与训练 / 系统课时
清洗蒸馏样本中的坏答案
清洗蒸馏样本中的坏答案
教师输出会直接塑造学生行为,因此蒸馏数据清洗不能只做去空值。需要把拒答、截断、重复、格式漂移和明显事实错误变成可解释的过滤规则,再用抽样复核守住自动规则看不到的灰区。
学习目标
- 识别最常见的低质量教师输出及其可检测信号
- 建立硬过滤、软标记与人工抽检相结合的清洗流水线
- 用可复现规则记录每条样本被保留或淘汰的原因
先区分硬错误和灰区
适合自动拒绝的是证据明确的坏样本,例如模型直接拒答、生成被长度上限截断、输出不满足强制格式、出现高比例机械重复,或在有标准答案的任务上与参考答案明确冲突。
开放式事实错误通常不能靠一个字符串规则可靠判断。更稳妥的做法是先标记风险,再进入参考资料核验或人工复核。这样可以避免为了提高“干净率”而误删表达不同但正确的答案。
把清洗做成分层流水线
先运行便宜且确定的规则,再做结构校验与参考答案核验,最后才把灰区送进抽检。每一层都要记录原因码,使训练集可以追溯“为什么被删”,而不是只剩一个不可解释的布尔字段。
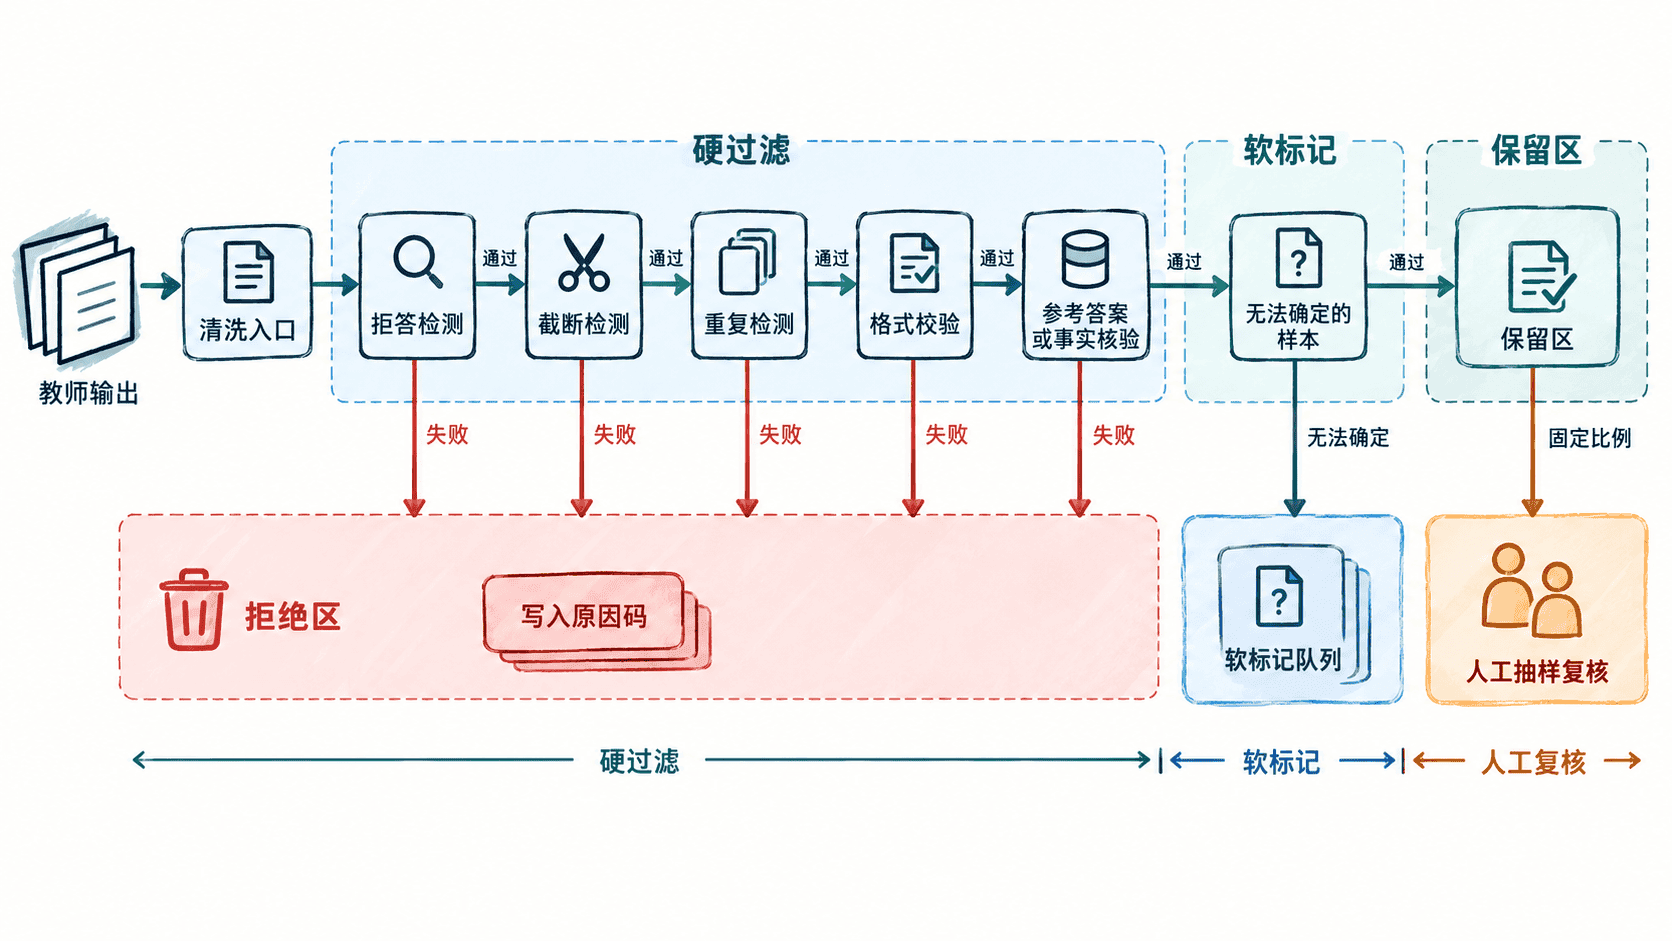
建议把规则分成三档:硬过滤用于确定性错误;软标记用于长度异常、弱重复、可疑事实和边界格式;人工复核覆盖全部软标记,再从自动通过样本中稳定抽取一小部分,例如按样本 ID 哈希固定抽取 5%。固定哈希比随机抽样更利于复现和回溯。
用可解释规则自动过滤
下面示例使用纯 Python 对六条教师答案执行确定性检查。真实任务可以替换格式规则和参考答案比较逻辑,但应保留原因码,而不是只返回通过或失败。
import re
from collections import Counter

REFUSAL_MARKERS = ("无法回答", "不能帮助", "抱歉,我不能")

def repeated_ratio(text: str) -> float:
    parts = [p.strip() for p in re.split(r"[。!?!?]", text) if p.strip()]
    if len(parts) < 3:
        return 0.0
    counts = Counter(parts)
    return max(counts.values()) / len(parts)

def extract_answer(text: str) -> str:
    prefix = "答案:"
    return text[len(prefix):].strip() if text.startswith(prefix) else text.strip()

def validate(sample: dict) -> list[str]:
    text = sample["text"].strip()
    reasons = []

    if any(marker in text for marker in REFUSAL_MARKERS):
        reasons.append("refusal")
    if sample["finish_reason"] != "stop":
        reasons.append("truncated")
    if repeated_ratio(text) >= 0.60:
        reasons.append("repetition")
    if not text.startswith("答案:"):
        reasons.append("format_drift")

    reference = sample.get("reference")
    if reference is not None and extract_answer(text) != reference:
        reasons.append("fact_mismatch")

    return reasons

samples = [
    {"id": "s1", "text": "答案:巴黎", "finish_reason": "stop", "reference": "巴黎"},
    {"id": "s2", "text": "抱歉,我无法回答这个问题。", "finish_reason": "stop", "reference": None},
    {"id": "s3", "text": "答案:42", "finish_reason": "length", "reference": "42"},
    {"id": "s4", "text": "答案:猫。猫。猫。猫。", "finish_reason": "stop", "reference": None},
    {"id": "s5", "text": "巴黎", "finish_reason": "stop", "reference": "巴黎"},
    {"id": "s6", "text": "答案:里昂", "finish_reason": "stop", "reference": "巴黎"},
]

accepted = 0
for sample in samples:
    reasons = validate(sample)
    if reasons:
        print(f"{sample['id']} REJECT {','.join(reasons)}")
    else:
        accepted += 1
        print(f"{sample['id']} ACCEPT")

print(f"accepted={accepted} rejected={len(samples) - accepted}")
预期输出
s1 ACCEPT
s2 REJECT refusal,format_drift
s3 REJECT truncated
s4 REJECT repetition
s5 REJECT format_drift
s6 REJECT fact_mismatch
accepted=1 rejected=5
示例中拒答样本同时触发格式漂移是正常的,因为一条样本可以保留多个原因码。生产流水线可以选择“首个失败即停止”以省算力,也可以像示例一样收集全部原因,便于统计教师输出的主要缺陷。
设计抽检与回流规则
自动通过不等于真实正确。建议对全部软标记样本做人工复核,并对硬规则全部通过的样本按固定比例抽检;若某一类错误在抽检中频繁出现,就把它升级为新的自动规则,再重新跑历史数据。
同时记录每种原因码的占比。如果某次教师模型或提示词变更后,refusal、truncated 或 format_drift 突然上升,先修教师生成配置,而不是继续扩大过滤器。清洗系统的目标是阻止坏答案进入学生模型,也要尽早暴露上游生成质量退化。
进入训练集前再做一次输入与评测集的去重,避免把评测答案混入蒸馏数据。最终保留下来的每条样本都应能回答两个问题:它为什么可信,以及如果以后发现问题,能否通过样本 ID 和原因记录快速追溯。